Excel zeigt „Wir haben ein Problem mit einigen Inhalten festgestellt“ bei einer XLSX, die LibreOffice und jeder selbst gestrickte Reader anstandslos öffnen, weil Excel zwei Dinge erzwingt, die diese Reader ignorieren: schema-erforderliche Attribute und die Eindeutigkeitsregeln der Open Packaging Conventions. Drei dieser Regeln lassen sich in jedem Writer leicht brechen, der generierte Parts mit bewahrten kombiniert: Ein <phoneticPr> braucht sein fontId, jeder Part-Name bekommt genau ein Override in [Content_Types].xml, und zwei Root-Beziehungen dürfen sich nie einen Bezeichner wie rId4 teilen. Dieser Artikel geht jede durch und zeigt, wie HotXLS, die native Excel-Spreadsheet-Komponente für Delphi und C++Builder, das Paket schreibt, damit sie erfüllt ist
Warum weist Excel ein Paket zurück, das jeder andere Reader akzeptiert?
Weil der Reparatur-Prompt ein Schema- und Paket-Validator ist, kein Parser-Fehler. Ein Workbook kann durch die eigene Bibliothek, durch LibreOffice und durch XML-Validatoren laufen und im OPC-Sinne strukturell gesund sein, wie ihn der Artikel zur XLSX-OPC-Beziehungsauflösung benutzt: jedes Part erreichbar, jedes Ziel auflösbar. Öffnen Sie es über Workbooks.Open in einer isolierten COM-Instanz mit ausgeschaltetem DisplayAlerts, kann der Aufruf trotzdem komplett scheitern. Interaktiv bringt dieselbe Datei den vertrauten Dialog, der Reparatur anbietet, und das Reparaturprotokoll benennt, wenn Excel sich die Mühe macht, eines zu schreiben, das Part, aber nicht die Regel. Mehrere unabhängige Verstöße können sich hinter diesem einen Prompt verstecken, und Excel meldet sie nicht einzeln; es verweigert die Mappe und überlässt Ihnen das Suchen und Analysieren. Was folgt, ist jede Regel, der natürliche Weg, sie zu verletzen, und wie HotXLS das Paket stattdessen schreibt, denn jede davon ist eine Regel, über die jeder Delphi-XLSX-Writer stolpern kann
Regel 1: phoneticPr-fontId ist erforderlich, auch wenn sie null ist
Das Element <phoneticPr> trägt ein Attribut fontId, das in ECMA-376 Part 1 §18.4.3 mit use="required" deklariert ist, und der Wert 0 ist ein legaler Font-Index, kein Fehlen. Ein Writer, der null als „nicht gesetzt“ behandelt und das Attribut nur ausgibt, wenn Sheet.PhoneticFontId > 0, folgt einem natürlichen Delphi-Reflex, weil Integer-Felder standardmäßig null sind, produziert aber <phoneticPr type="noConversion"/> für jede Mappe, deren phonetischer Font zufällig der erste Font in styles.xml ist – leicht zu treffen, denn Index 0 ist schlicht der erste Font. Excel weist auf dem Rückweg also einen Wert zurück, den es selbst geschrieben hatte
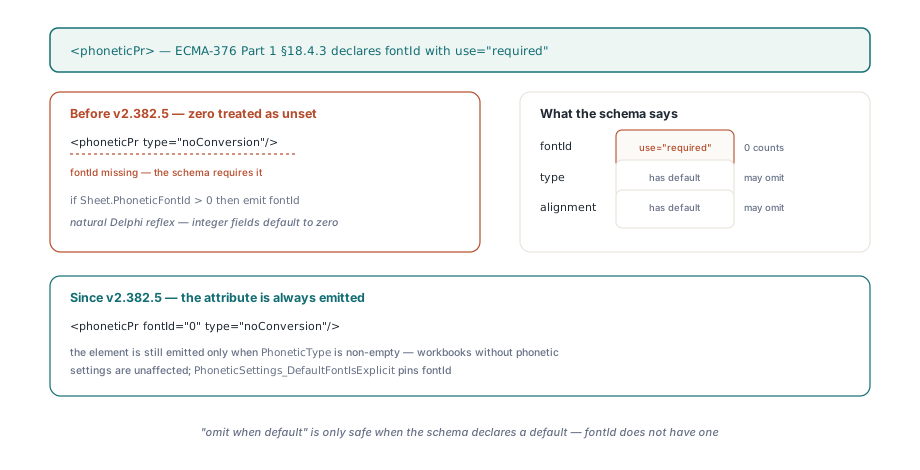
// Der natürliche Reflex: null als nicht gesetzt behandelt, fontId weggelassen
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas, Worksheet-Writer — das Attribut ist erforderlich, null eingeschlossen
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS gibt das Element nur aus, wenn TXLSXWorksheet.PhoneticType nicht leer ist, daher bleiben Mappen ohne phonetische Einstellungen unberührt. Setzen Sie PhoneticFontId auf einem frischen Sheet auf null, speichern Sie, und xl/worksheets/sheet1.xml trägt <phoneticPr fontId="0". Die allgemeinere Lehre: „Weglassen, wenn Default“ ist nur sicher, wenn das Schema einen Default deklariert; type und alignment haben in diesem Element Defaults, fontId nicht
Regel 2: ein Override pro Part-Namen in [Content_Types].xml
Der Content-Types-Stream darf jeden Part-Namen höchstens einmal deklarieren, und Excel wertet ein zweites Override für denselben PartName als Korruption, selbst wenn beide Einträge dasselbe ContentType tragen. In HotXLS speisen zwei Writer diesen Stream. BuildContentTypesXml deklariert jedes Part, das das Objektmodell erzeugt: Workbook, Styles, Shared Strings, Theme, Worksheets und, wenn TXLSXWorkbook.CustomProperties.Count > 0, /docProps/custom.xml. Ist PreserveUnsupportedParts an, hängt TXLSXOpaquePackage anschließend für jedes Part, das es wortgetreu aus dem Quellpaket übernommen hat, ein Override an, damit diese Bytes auf dem Ausweg weiter deklariert bleiben. Die Kollision ist ein Part, das auf beiden Seiten existiert. Custom-Dokumenteigenschaften werden ins Modell geparst, aber das docProps/custom.xml des Quellpakets wird zusätzlich opak übernommen, also deklariert ein naiver Merge es zweimal, und Chart- und Pivot-Cache-Parts können an dieselbe Stelle geraten, wenn das Modell ein Part neu erzeugt, das die opake Schicht ebenfalls behalten hat. Ein opaker Writer ohne Blick darauf, was das Modell bereits geschrieben hat, kann es nicht wissen – deshalb bekommt ContentTypeOverridesXml diesen Blick
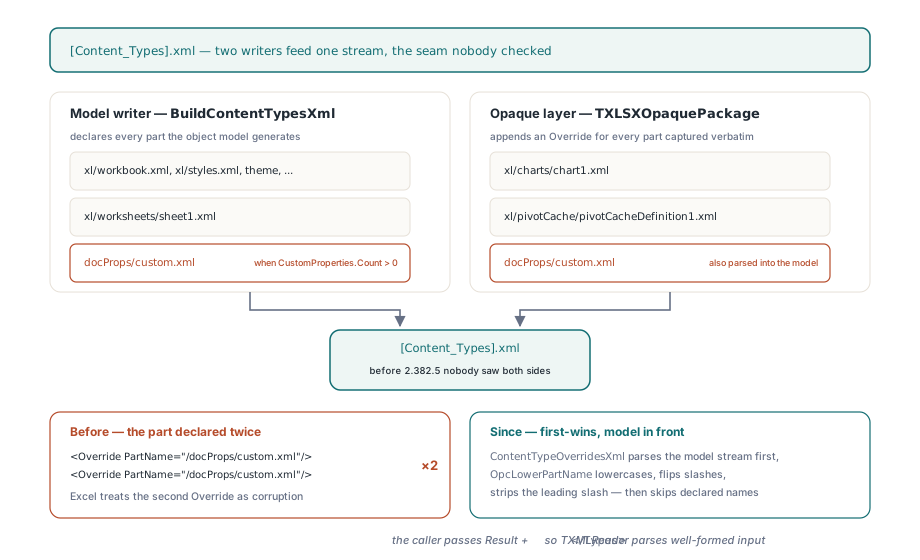
<!-- Was ein naiver Merge produziert -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS reicht das erzeugte XML in ContentTypeOverridesXml hinein und lässt den opaken Writer es parsen, bevor er irgendetwas ausgibt. Zwei Details tragen die Korrektheit. OpcLowerPartName wandelt in Kleinbuchstaben, dreht Backslashes in Forward Slashes und schneidet führende Slashes ab, bevor verglichen wird, denn OPC-Part-Namen werden case-insensitive verglichen, und das Modell schreibt sie mit führendem Slash, während die opake Schicht ZIP-Eintragsnamen ohne solchen ablegt. Und der Aufrufer in BuildContentTypesXml übergibt Result + '</Types>' und schließt damit das halb fertige Dokument, sodass TXMLReader wohlgeformte Eingabe sieht statt eines abgeschnittenen Streams. Die Regel, die dabei herauskommt, lautet First-Wins mit dem Modell vorne: Was das Objektmodell deklariert, ist maßgeblich, und die opake Wiedergabe füllt nur Lücken
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Den vom Modell erzeugten Stream parsen und jeden deklarierten PartName einsammeln.
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // bereits deklariert oder ein rels-Part
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Regel 3: Beziehungs-Ids sind innerhalb eines Relationships-Parts eindeutig
Jedes Relationship in einem .rels-Part braucht eine Id, die innerhalb dieses Parts eindeutig ist, und Excel verweigert das Paket, wenn sich zwei eine teilen. HotXLS schreibt das Paket-level _rels/.rels mit festen Bezeichnern: rId1 für das Workbook, rId2 und rId3 für die Kern- und erweiterten Dokumenteigenschaften und rId4 für Custom-Properties, wenn das Modell welche hat. Das opake Paket hängt dann alle Root-Beziehungen an, die es aus der Quelle behalten hat, und nummeriert jeden Bezeichner um, der bereits in einer UsedIds-Liste steht. Kennt die Liste nur rId1 bis rId3, und nicht, dass das Modell gleich seine eigene Custom-Properties-Beziehung ausgeben wird, kommt ein Quellpaket, dessen Custom-Properties-Beziehung ebenfalls rId4 ist – was Excel standardmäßig schreibt – mit zwei rId4-Einträgen heraus, die auf dasselbe Ziel zeigen. RootRelationshipsXml reserviert deshalb rId4 und überspringt die Quellkopie, wann immer das Modell Custom-Properties ausgibt. Der Aufrufer, BuildRootRelsXml, übergibt Workbook.FCustomProps.Count > 0 als zweites Argument, sodass die Reservierung und das Überspringen von derselben Bedingung gesteuert werden, die entscheidet, ob das Modell überhaupt rId4 ausgibt. Umnummerieren ist am Paket-Root sicher, weil nichts innerhalb der Mappe Root-Beziehungs-Bezeichner beim Namen referenziert; derselbe Trick wäre eine Ebene tiefer falsch, wo sich die r:id-Attribute in workbook.xml an Bezeichner im Workbook-Relationships-Part binden – deshalb führt MergeWorkbookRelationshipsXml eine eigene Bezeichner-Map
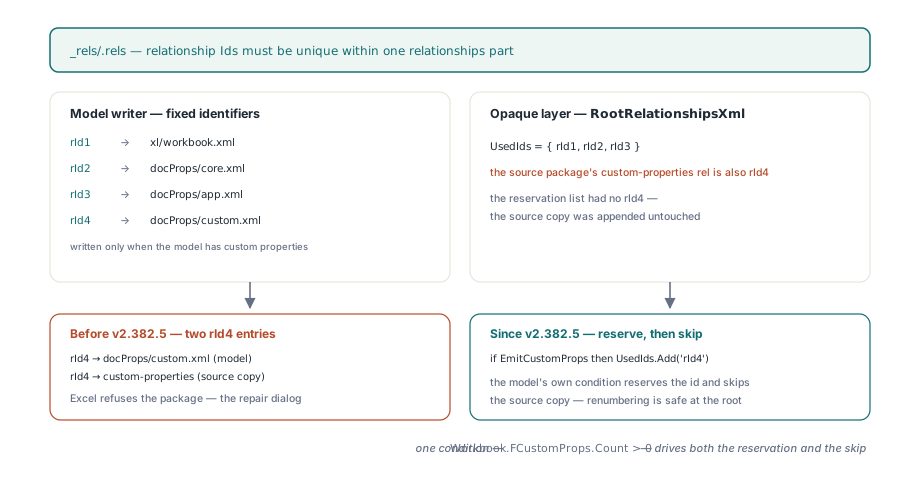
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // vom Modell-Writer reserviert
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // Das Modell besitzt die Custom-Properties; die Quellkopie nicht wiedergeben.
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // niedrigste freie rIdN
  UsedIds.Add(String(Id));
  ...
end;
Was haben die drei Regeln gemeinsam?
Alle drei bewachen vor einem Writer mit zwei Quellen und ohne einen einzigen Besitzer der Paket-Invarianten. Das Objektmodell erzeugt Parts, die es versteht; die opake Schicht spielt Parts zurück, die es nicht tut, sodass ein Round Trip Charts, Pivot-Caches, Custom-XML und alles andere bewahrt, was die Notizen zum verlustfreien Round Trip von Theme, extLst und calcChain beschreiben. Jede Seite kann für sich konsistent sein. Die Auflagen, die OPC dem ganzen Paket stellt – eindeutige Override-Part-Namen und eindeutige Beziehungs-Bezeichner pro Part –, existieren nur an der Naht, an der beide zusammengeklebt werden, also muss etwas die Naht besitzen. Die fontId-Regel hat dieselbe Gestalt, eine Ebene tiefer: Ein Writer kann wissen, was er weglassen will, und nie das Schema konsultieren, das ihm das verbietet. HotXLS entscheidet das mit einer festen Präzedenz statt einer Merge-Heuristik. Das Modell schreibt zuerst, die opake Schicht sieht, was geschrieben wurde, und weicht bei jeder Kollision. Die Invarianten lassen sich auch von außen billig prüfen: Lesen Sie [Content_Types].xml und jeden .rels-Eintrag in einem gespeicherten Paket und scheitern Sie an jedem doppelten PartName, Extension oder Id. Diese Prüfung braucht kein Excel und deckt die beiden Eindeutigkeitsregeln ab; die fontId-Regel braucht weiterhin einen Schema-Validator
Druckbereiche, die Formeln sind, nicht Bereiche
Der Druckbereich ist das andere, das Excel an einer gespeicherten Kopie vergleicht: Eine Vorlage, deren _xlnm.Print_Area Excel als $A$1:$J$29 meldet, muss nach einem Round Trip identisch melden. Dahinter sitzen zwei Fallen. Beim Import schneidet ein Präfix-Strip, der alles bis zum ersten nicht in Anführungszeichen stehenden ! entfernt, einen dynamischen Druckbereich wie OFFSET('Print Data'!$A$1,0,0,2,2) zu $A$1,0,0,2,2) zurecht, und lässt eine qualifizierte Vereinigung wie 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 den Präfix nur an ihrem ersten Segment verlieren. Beim Export stellt das Voranstellen des Sheet-Namens vor die ganze gespeicherte PrintArea einer schlichten Vereinigung $A$1:$B$2,$D$1:$E$2 ein qualifiziertes erstes und ein nacktes zweites Segment, was Excel nicht als _xlnm.Print_Area-Definition nach ECMA-376 Part 1 §18.2.5 akzeptiert
// Import: den Präfix nur abtrennen, wenn übrig ein schlichter sqref bleibt
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) wird unangetastet zurückgegeben

// Export: jedes kommagetrennte Segment qualifizieren oder keins
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // eine Formel: wortgetreu ausgeben
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
Die Paarungsregel ist auf beiden Seiten dieselbe: Ein Druckbereich ist nur dann ein nackter Bereich, wenn jedes Segment als einer parst, sonst ist er eine Formel und reist wortgetreu. Mit dieser Regel überleben die benannte Basis, die blattqualifizierte Basis und die Vereinigung wiederholte Speicher-und-Wiederöffnen-Zyklen. Wie Druckbereiche mit dem Seiten-Setup und dem Rest des Druckmodells zusammenspielen, behandelt der Artikel zu Blattschutz, Seiten-Setup und Drucken
Wie finden Sie heraus, gegen welche Regel Excel etwas hat?
Beginnen Sie mit der Annahme, dass Ihr eigener Validator falsch liegt, denn er hat durchgelassen. Der Open XML SDK Validator benennt eine Schema-Verletzung wie das fehlende fontId mit Part und XPath, und die Packaging-Schicht darunter verweigert ohnehin das Öffnen eines Pakets mit doppelten Content-Type-Einträgen, also fahren Sie ihn vor allem anderen. Wenn er schweigt und Excel trotzdem repariert, halbieren Sie das Paket per Bisektion: entpacken, ein Part samt seiner Beziehung und seinem Override löschen, neu packen und neu öffnen, und die Kandidatenmenge jedes Mal halbieren, bis der Prompt verschwindet. Die drei Verstöße oben kommen in genau dieser Reihenfolge zum Vorschein, und keiner davon wäre in der reparierten Datei sichtbar, die Excel anzubieten pflegt, denn die Reparatur wirft die beanstandeten Einträge still weg oder nummeriert sie um. Zwei Designentscheidungen im HotXLS-Writer sollte man kennen. Die Deduplikation ist First-Wins mit dem Modell vorne: Hat das Quellpaket für ein Part, das das Modell ebenfalls erzeugt, einen anderen Content-Typ deklariert, gewinnt die Deklaration des Modells und die der Quelle fliegt raus – korrekt für die Parts, die HotXLS neu erzeugt, und kein allgemeiner Merge. Und der zusätzliche TXMLReader-Lauf über den erzeugten Content-Types-Stream läuft bei jedem Save mit aktiviertem PreserveUnsupportedParts – ein kleiner Preis für einen Stream, der selten mehr als ein paar Kilobyte hat. Mit diesen Regeln öffnet eine Darlehensvorlage mit 4805 Formeln, gespeichert vom Win32- wie vom Win64-Build, ohne Prompt in Excel, berechnet mit null Abweichungen neu und meldet denselben Druckbereich wie das Original
Wenn Sie XLSX selbst aus Delphi heraus schreiben, ist die Checkliste kurz: Geben Sie jedes Attribut aus, das das Schema als erforderlich markiert, egal mit welchem Wert, deklarieren Sie jeden Part-Namen genau einmal, und führen Sie eine einzige Liste benutzter Bezeichner pro Relationships-Part über alle Writer hinweg, die es anfassen. Wenn Sie diese Liste lieber bereits vorhanden und gegen Excel getestet hätten statt nur gegen Ihren eigenen Reader: Der hier beschriebene Paket-Writer steckt in der HotXLS Delphi-Tabellenkomponente, zusammen mit dem Opaque-Part-Round-Trip, der die Naht überhaupt erst bewachenswert gemacht hat