Geben Sie =NORM.DIST(115,100,15,TRUE) in eine Zelle ein, und Excel gibt ohne Umschweife 0.8413447 zurück. Der Aufruf liest sich wie ein einfacher Tabellen-Lookup. Das ist er aber nicht. Hinter dieser einen Zahl steht die kumulierte Normalverteilung, ein Integral ohne geschlossene Form, und hinter CHISQ.INV.RT und BETA.DIST verbergen sich mathematische Spezialfunktionen, die eine präzise arbeitende Bibliothek berechnen muss, anstatt sie von Hand abzurunden. Eine Tabellenkalkulationskomponente, die Excel-Kompatibilität beansprucht, muss diese Werte bis zur letzten von Excel angezeigten Ziffer reproduzieren, was bedeutet, dass die numerischen Methoden und nicht nur die Funktionsnamen nachgebildet werden müssen
HotXLS implementiert mehr als fünfzig dieser statistischen Funktionen, und die Arbeit, die sie korrekt macht, ist in der Formelleiste fast vollständig unsichtbar. Dies ist ein Rundgang durch die Funktionsweise der Berechnung durch die Engine: der gemeinsame Spezialfunktionskern, die Verzweigungsentscheidungen, die die Arithmetik stabil halten, und ein Fallstrick bei der inversen Normalverteilung, der sich im Tail verbirgt, weil der Regelfall diese Zeile nie berührt
Ein Arbeitsblattaufruf, fünfzig Verteilungen dahinter
Die Funktionen decken die Familien ab, die in einer Statistik-Arbeitsmappe benötigt werden. Es gibt die Normalverteilungs-Familie, NORM.DIST und NORM.S.DIST mit ihren Inversen; die Gamma- und Chi-Quadrat-Familie, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; die Beta-Familie, BETA.DIST und BETA.INV; die Stichprobenverteilungen T.DIST, T.DIST.2T, F.DIST und F.INV; das diskrete Paar BINOM.DIST und POISSON.DIST; sowie die Inferenz-Hilfen wie CONFIDENCE.T und CONFIDENCE.NORM. Aus Sicht des Aufrufers ist jede davon eine einzelne Formel. Sie tragen Werte in Zellen ein, lassen die Arbeitsmappe rechnen und lesen das Ergebnis ab
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // Beobachtungswert
  sh.Range['A2', 'A2'].Value := 100;   // Mittelwert
  sh.Range['A3', 'A3'].Value := 15;    // Standardabweichung

  // Der XLS-Formelparser verwendet ';' als Argumenttrennzeichen.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
Die Methode Calculate der Arbeitsmappe kompiliert und wertet eine Ad-hoc-Formel für das aktive Blatt aus und gibt einen Variant-Wert zurück. Ein Detail bringt Einsteiger beim ersten Versuch oft ins Stolpern: Der Formel-Parser hinter Calculate verwendet das Semikolon als Argumenttrennzeichen, es heißt also =SUM(A1;B1) und nicht =SUM(A1,B1). In Zellen gespeicherte Formeln behalten das von Excel gewohnte Komma bei. Derselbe Evaluator verarbeitet jede unten aufgeführte statistische Funktion. Sobald eine davon in Calculate funktioniert, folgen die restlichen demselben Pfad
Die zwei Funktionen, auf denen alles andere aufbaut
Die meisten kumulierten Verteilungsfunktionen in diesem Satz werden nicht durch Summieren oder Integrieren ihrer eigenen Definitionen berechnet. Sie werden aus zwei Spezialfunktionen berechnet: der regularisierten unteren unvollständigen Gammafunktion, geschrieben P(a, x), und der regularisierten unvollständigen Betafunktion, geschrieben Ix(a, b). Intern sind dies die Helfer, auf die sich die Dispatcher stützen, und die Verbindungskette ist kurz. Die Chi-Quadrat-Verteilungsfunktion (CDF) ist die Gamma-CDF mit der Form df/2 und der Skalierung 2. Die Gamma-CDF ist direkt P(a, x). Die kumulierten Funktionen von t-, F- und Binomialverteilung sind allesamt Werte der regularisierten unvollständigen Betafunktion bei den passenden Argumenten. Die Poisson-CDF ist die obere unvollständige Gammafunktion Q. Implementiert man die Gamma- und Betafunktion präzise, erben ein Dutzend Verteilungen deren Genauigkeit völlig kostenlos
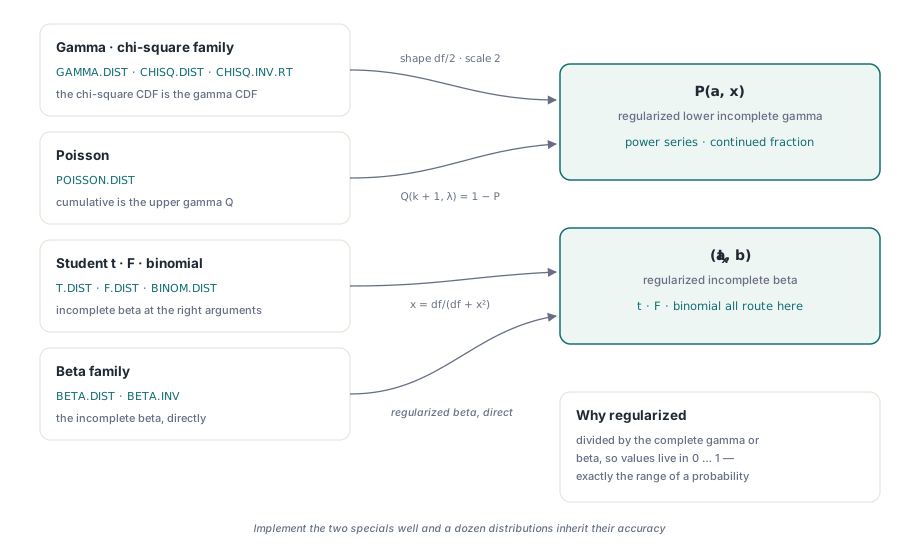
Das Wort "regularisiert" trifft den eigentlichen Kern. Die rohe unvollständige Gammafunktion wächst wie eine Fakultät, und das rohe Beta-Integral kann über- oder unterlaufen, lange bevor das Endergebnis dies tut. Die regularisierten Formen sind durch die vollständige Gamma- bzw. Betafunktion dividiert, sodass sie vollständig im Intervall von Null bis Eins liegen – was genau dem Bereich entspricht, den eine Wahrscheinlichkeit einnimmt. Diese Normalisierung sorgt dafür, dass dieselbe Routine eine Chi-Quadrat-Verteilung mit zwei Freiheitsgraden und eine mit zweihundert bedienen kann, ohne dass die Zwischenterme die Grenzen eines Double-Werts überschreiten. Es erklärt auch, warum man eine CDF nicht durch Aufsummieren vieler einzelner Dichtewerte berechnet: Jeder Term bringt seinen eigenen Rundungsfehler mit, die Fehler summieren sich im Verlauf der Reihe auf, und die regularisierte Spezialfunktion umgeht die Summe vollständig, indem sie stattdessen eine schnell konvergierende Reihe oder einen Kettenbruch auswertet
Reihen unterhalb der Diagonalen, Kettenbruch oberhalb
Die Routine für die unvollständige Gammafunktion trifft eine Entscheidung, bevor sie irgendetwas berechnet: Sie vergleicht x mit a + 1. Diese Grenze ist nicht willkürlich gewählt. Die Potenzreihenentwicklung von P(a, x) konvergiert schnell, wenn x im Verhältnis zu a klein ist, und langsam (schließlich unbrauchbar langsam), wenn x groß ist. Der Kettenbruch verhält sich genau umgekehrt. Die Engine verwendet daher die Potenzreihe für x-Werte unter a + 1 und einen Kettenbruch nach Lentz für x-Werte bei oder über a + 1. So wird jeder Berechnungszweig nur mit der Arbeit betraut, für die er sich am besten eignet
Der Kettenbruch benötigt eine Schutzmaßnahme. Die Methode nach Lentz arbeitet mit einem laufenden Zähler und Nenner und invertiert den Nenner bei jedem Schritt. Nähert sich einer der beiden Null an, scheitert die Invertierung. Die Lösung ist ein winziger Mindestwert: Wann immer ein Zwischenwert betragsmäßig unter etwa 1e-30 fällt, wird er auf 1e-30 begrenzt, was die Rekursion endlich hält, ohne den konvergierten Wert zu verfälschen. Derselbe Mindestwert wird aus demselben Grund auch im Kettenbruch der unvollständigen Betafunktion angewendet. Es ist eine kleine Konstante mit tragender Rolle – der Unterschied zwischen einer stabilen Auswertung und einer Division durch einen Wert, der sich praktisch nicht von Null unterscheidet
Der obere Bereich (Tail), Q(a, x), is schlicht 1 minus P(a, x), und so wird auch der kumulierte Zweig für Poisson berechnet: Die Wahrscheinlichkeit von höchsten k Ereignissen bei einem Erwartungswert λ ist Q(k + 1, λ). Der Weg über die obere unvollständige Gammafunktion anstelle des Summierens von k + 1 Poisson-Termen ist wiederum die Entscheidung, einen einzelnen konvergierenden Ausdruck auszuwerten, anstatt viele kleine Werte aufzusummieren
Diskrete Massen ohne Fakultätsüberlauf
Die diskreten Verteilungen bergen eine andere Gefahr. Eine binomiale Wahrscheinlichkeitsfunktion enthält einen Binomialkoeffizienten, und der Koeffizient für "52 über 26" ist eine enorme Ganzzahl. Bildet man ihn direkt ab, läuft der Zähler bei einem Double-Wert über, noch bevor die Division stattfinden kann, die ihn wieder auf eine sinnvolle Wahrscheinlichkeit zurückführen würde. Die Engine berechnet ihn daher niemals direkt. Sie berechnet die Fakultäten im logarithmischen Raum über die Log-Gamma-Funktion, addiert und subtrahiert die Logarithmen, rechnet die Logarithmen der Erfolgs- und Misserfolgswahrscheinlichkeiten ein und wendet erst ganz am Ende die Exponentialfunktion an
// Binomiale Wahrscheinlichkeitsmasse, vollständig im logarithmischen Raum ausgewertet.
// LnGammaF(n+1) ist ln(n!); die drei Log-Faktoren bilden ln(C(n,k)),
// und der gesamte Exponent wird aufgebaut, bevor ein einziger Exp-Aufruf erfolgt.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
Die Log-Gamma-Funktion selbst ist eine Lanczos-Approximation, die über die gesamte positive Achse hinweg präzise und kostengünstig auszuwerten ist. Da jeder große Wert bis zum abschließenden Exp als Logarithmus gehalten wird, ist die größte Zahl, die die Routine jemals tatsächlich bildet, die Wahrscheinlichkeit selbst (also höchstens eins). Die Poisson-Massenfunktion folgt demselben Rezept, wobei der einzelne Log-Gamma-Term anstelle der Fakultät im Nenner steht. Die geschlossenen Formen werden an den Rändern, wo p genau Null oder Eins ist, als Sonderfälle behandelt, sodass der Code niemals Ln(0) aufruft. HotXLS gibt 0.2460938 für BINOM.DIST(5,10,0.5,FALSE) und 0.6766764 für das kumulierte POISSON.DIST(2,2,TRUE) zurück, was exakt mit den von Excel ausgegebenen Stellen übereinstimmt
Inverse Verteilungsfunktionen durch Einklammern der Vorwärtskurve
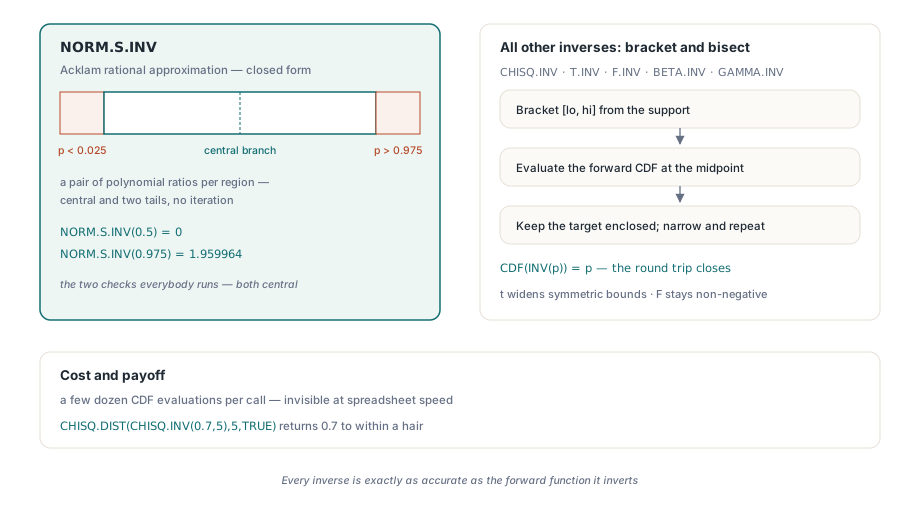
Eine inverse Verteilungsfunktion stellt die umgekehrte Frage: Bestimme für eine gegebene Wahrscheinlichkeit den Wert, dessen kumulierte Verteilungsfunktion (CDF) diesem Wert entspricht. Nur eine Inverse in diesem Satz besitzt eine schnelle direkte Formel. NORM.S.INV, die inverse Standardnormalverteilung, verwendet eine rationale Approximation nach Acklam – ein Paar von Polynomverhältnissen, das über den gesamten Bereich hinweg in etwa der Genauigkeit eines Double-Werts entspricht, aufgeteilt in einen zentralen Bereich und zwei Endbereiche (Tails). Dies ist eine geschlossene Auswertung ohne Iteration
Die anderen inversen Funktionen haben keine solche Formel, weshalb die Engine sie numerisch invertiert. Sie klammert die Antwort mit einer unteren und oberen Grenze ein, die aus dem Definitionsbereich der Verteilung gewählt werden, und führt dann eine Bisektion (Intervallhalbierung) durch: Wertung der Vorwärts-CDF am Mittelpunkt, Verschieben der Grenze, die die Zielwahrscheinlichkeit eingeschlossen hält, und Wiederholen, bis das Intervall schmal ist. Für die Gamma- und Chi-Quadrat-Inversen beginnt die Einklammerung bei Null und einer großzügigen oberen Schätzung, die auf Form und Skalierung basiert, wobei die obere Grenze verdoppelt wird, wenn die Wahrscheinlichkeit noch nicht eingeschlossen ist. Die inverse t-Verteilung klammert symmetrische Grenzen ein, die sich nach außen erweitern; die inverse F-Verteilung halbiert auf einem nicht-negativen Intervall. Die Kosten belaufen sich auf ein paar Dutzend CDF-Auswertungen pro Aufruf, was bei Tabellenkalkulations-Geschwindigkeit nicht ins Gewicht fällt. Der Vorteil ist jedoch, dass jede Inverse exakt so genau ist wie die Vorwärtsfunktion, die sie invertiert. Aus diesem Grund gibt ein Rundlauf wie CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) haargenau 0.7 zurück
Der Logarithmus-Fallstrick im Tail
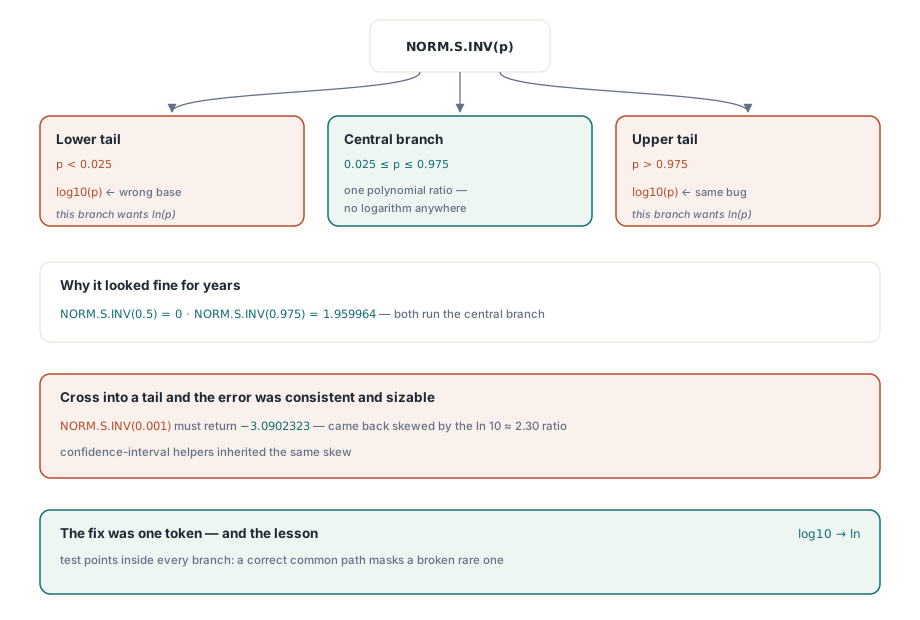
Hier ist der Fallstrick, den es sich zu erzählen lohnt, denn es ist die Sorte, die in jeder Implementierung lange überlebt. Die Acklam-Routine für die inverse Normalverteilung hat drei Zweige. Der breite zentrale Zweig, der immer dann greift, wenn die Wahrscheinlichkeit etwa zwischen 0,025 und 0,975 liegt, schickt die Eingabe durch ein Polynomverhältnis, in dem nirgends ein Logarithmus vorkommt. Die beiden Tail-Zweige, für sehr kleine oder sehr große Wahrscheinlichkeiten, nehmen zuerst jeweils den Logarithmus der Eingabe, weil sich der Tail wie die Quadratwurzel aus dem negativen natürlichen Logarithmus von p verhält
Nimmt man in einem Tail-Zweig, wo der natürliche Logarithmus hingehört, den Logarithmus zur Basis 10, liegen die Tail-Ergebnisse um eine gleichbleibende, erhebliche Abweichung daneben, denn die beiden unterscheiden sich um einen konstanten Faktor von etwa 2,30. Und trotzdem sieht die Funktion bei jeder beiläufigen Prüfung in Ordnung aus, denn solche Prüfungen finden in der Mitte statt. NORM.S.INV(0.5) ist Null, NORM.S.INV(0.975) entspricht den Lehrbuch-1.959964, und beide laufen durch das zentrale Polynom, das überhaupt keinen Logarithmus aufruft. Der Fehler zeigt sich erst, wenn eine Wahrscheinlichkeit in einen Tail rutscht – etwa NORM.S.INV(0.001), das -3.0902323 zurückgeben muss. Jede Funktion, die in ihrem Tail von der inversen Normalverteilung abhängt, inklusive der Konfidenzintervall-Helfer, erbt dieselbe Schieflage. Die Lehre ist banal und teuer: Eine Funktion mit Verzweigungsstruktur braucht Testpunkte in jedem einzelnen Zweig, denn ein korrekter Hauptpfad kaschiert einen defekten Randpfad mit Freuden. HotXLS nimmt in beiden Tail-Zweigen den natürlichen Logarithmus, sodass die Tail-Werte denen von Excel entsprechen
Das Vorzeichen von x entscheidet über den Tail-Bereich der t-Verteilung
Die kumulierte Student-t-Verteilungsfunktion enthält eine Feinheit, die man leicht verwechseln kann. Ihr Wert stammt aus der regularisierten unvollständigen Betafunktion, ausgewertet bei df / (df + x²). Dieser Beta-Wert entspricht jedoch der Wahrscheinlichkeit im Endbereich jenseits der Größe von x, nicht der kumulierten Wahrscheinlichkeit bis zu x. Die symmetrische Form der t-Verteilung bedeutet, dass die Umwandlung davon abhängt, auf welcher Seite von Null x liegt
// Student-t-CDF. ib ist die regularisierte unvollständige Beta-Funktion bei df/(df+x*x),
// die den symmetrischen Endbereich misst. Der kumulierte Wert hängt vom Vorzeichen von x ab;
// die unkonvertierte Rückgabe von ib würde den falschen Endbereich ergeben.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // oberhalb des Mittelwerts: eins minus die Hälfte des Endbereichs
else if x < 0 then
  result := 0.5 * ib            // unterhalb des Mittelwerts: die Hälfte des Endbereichs
else
  result := 0.5;                // genau am Mittelwert
Für x-Werte über Null ist die kumulierte Wahrscheinlichkeit eins minus der halbe symmetrische Endbereich; für x-Werte unter Null ist sie die Hälfte dieses Endbereichs; bei Null ist sie genau ein Halb. Gibt man den Beta-Wert direkt zurück, meldet man die falsche Seite der Verteilung – für jedes x ungleich Null um den gesamten Körper der Kurve verschoben. Die rechtsseitigen und zweiseitigen Varianten bauen auf demselben Zweig auf, weshalb T.DIST.2T(1,1) als 0.5 und T.DIST(1,1,TRUE) als 0.75 zurückgegeben wird, und die Inverse T.INV führt die Bisektion gegen diese CDF durch, sodass der Rundlauf geschlossen wird
Nichts davon ist in der Zelle sichtbar, und das ist das gewünschte Ergebnis. Sie schreiben eine Formel und lesen eine Zahl ab, die mit Excel übereinstimmt. Wenn Sie die Engine mit Ihrer eigenen Logik erweitern möchten, werden die Mechanismen zur Registrierung einer Funktion in unserer Einführung in die Formel-Engine und benutzerdefinierte Funktionen behandelt, und der Weg, wie Formeln über Tabellen und benannte Bereiche hinweg aufgelöst werden, wird im Artikel über definierte Namen und tabellenübergreifende Formeln beschrieben. All dies wird in der HotXLS-Delphi-Tabellenkalkulationskomponente für Delphi und C++Builder ausgeliefert, zusammen mit den Lese-, Schreib-, Diagramm- und Formatierungs-APIs, die an anderer Stelle in diesem Blog behandelt werden