Ein als =0<B2<100 geschriebener Bereichs-Check liefert in Excel in jeder Zeile FALSE, auch in der Zeile, in der B2 die 50 hält. Excel wertet zuerst 0<B2 aus, bekommt TRUE und fragt dann, ob TRUE kleiner als 100 ist; ein logischer Wert rangiert über jeder Zahl, also ist die Antwort FALSE, was auch immer B2 enthält. Leerzellen und SUMIF haben Überraschungen derselben Art: Eine leere Zelle ist gleichzeitig gleich 0, gleich "" und gleich FALSE, und =SUMIF(A1:A10,">5",B1) addiert zehn Zellen der Spalte B
Eine Berechnungs-Engine, die eine solche Arbeitsmappe außerhalb von Excel neu berechnet, muss diese Antworten reproduzieren, auch wenn sie offensichtlich nicht sind, was der Autor meinte. Das in der Datei gespeicherte gecachte Ergebnis ist das, was ein Viewer, eine Mail-Vorschau oder ein nachgelagerter Import sieht, bevor jemand F9 drückt. Schreibt der Server für den Bereichs-Check TRUE und zeigt Excel später FALSE, enthält derselbe Bericht zwei verschiedene Zahlen, je nachdem, wo er geöffnet wurde, und niemand kann sagen, welcher man vertrauen soll. Die Formel des Autors zu reparieren, ist die Aufgabe des Autors
Warum liefert =1<2<3 in Excel FALSE?
Excel liefert für =1<2<3 FALSE, weil alle sechs Vergleichsoperatoren eine einzige Vorrangstufe teilen und von links nach rechts assoziieren, die Formel also (1<2)<3 bedeutet, und das innere TRUE dann einen Typ-Ranking-Wettkampf gegen die Zahl 3 verliert. HotXLS Delphi Component parst Vergleichsketten in beiden Workbook-Engines auf dieselbe Weise, im klassischen TXLSWorkbook und im XLSX-nativen TXLSXWorkbook. Der Parser liest einen Operanden, und solange das nächste Token =, <>, <, >, <= oder >= ist, baut er einen Vergleichsknoten mit allem, was bisher geparst wurde, als linkem Kind und dem nächsten Operanden als rechtem Kind, und trägt diesen Knoten in die nächste Runde. Das ist dieselbe Schleifenform, die er für +, - und & verwendet
Die Falle sitzt in der Lehrbuch-Grammatik. Als expr = operand op expr geschrieben, steigt ein Recursive-Descent-Parser für die rechte Seite in sich selbst ab und macht den Operator still rechtsassoziativ. Unter dieser Lesung wird =1<2<3 zu 1<(2<3), das ist 1<TRUE, das ist TRUE. Der Fehler läuft in beide Richtungen: =3>2>1 ist in Excel TRUE und unter Rechtsassoziativität FALSE, und =1=1=TRUE kippt genauso. Parenthesisierte Formen kommen ohnehin richtig heraus, also schlüpft der Fehler an jedem Test vorbei, der nur (a<b)<c prüft
Die Methode Calculate wertet einen Formel-String aus, ohne ihn in eine Zelle zu setzen, was sie zum schnellen Weg macht, eine ganze Liste von Ketten gegen beide Engines zu prüfen. Die Methode wird im Überblick über die HotXLS-Formel-Engine ausführlicher behandelt
uses
  SysUtils, Variants, lxCalc, lxHandle, lxHandleX;   // lxOk ist in lxCalc deklariert

const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Excels Antworten:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;   // referenzgezählt über das Interface
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate wertet gegen das aktive Sheet aus und
    // liefert Null, wenn die Arbeitsmappe noch kein Sheet hat
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;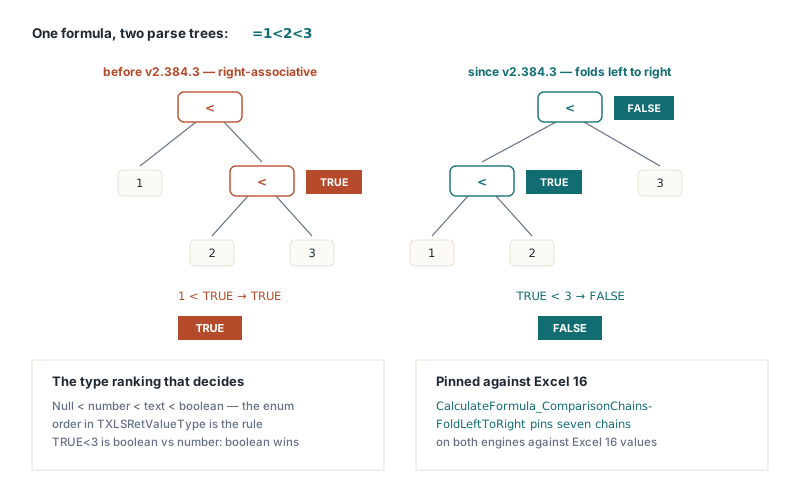
Zahlen, Text und Booleans: das typübergreifende Ranking
Wenn die beiden Seiten eines Vergleichs verschiedene Typen haben, wandelt Excel keinen in den anderen um. Es rangiert stattdessen die Typen: Jede Zahl ist kleiner als jeder Textwert, und jeder Textwert ist kleiner als jeder Boolean. HotXLS klassifiziert beide Operanden als Zahl, Text oder Boolean und vergleicht, wenn die Klassen differieren, allein die Klassen. Also ist =TRUE>99999 TRUE, ="1">2 ist TRUE, und =FALSE>"zzz" ist ebenfalls TRUE. Das ist das Stück, das verkettete Vergleiche willkürlich wirken lässt. TRUE<3 ist kein zu 1 umgewandeltes TRUE, das mit 3 verglichen wird; es ist ein Boolean, der mit einer Zahl verglichen wird, und der Boolean gewinnt
Innerhalb einer Klasse ist der Vergleich der natürliche, mit einer Wendung bei Text: Der Stringvergleich ignoriert Groß-/Kleinschreibung, also liefert ="abc"="ABC" in Excel und in HotXLS TRUE. Datumswerte sind für die Engine Serial-Nummern, was bedeutet, dass ein Datum stets unter jedem Text rangiert, einschließlich einer Textzelle, die nur wie ein Datum aussieht. Eine Spalte importierter Daten, in der die Hälfte der Zellen als Strings ankam, sortiert und vergleicht in zwei getrennten Bändern, und =A2>DATE(2026,1,1) liefert für jede der String-Zellen TRUE
Womit ist eine Leerzelle in einem Vergleich gleich?
Eine als Vergleichsoperand genutzte Leerzelle nimmt den Typ der anderen Seite an: Sie ist gleich 0 gegen eine Zahl, gleich "" gegen Text und gleich FALSE gegen einen logischen Wert. Bei leerem A1 sind =A1=0, =A1="" und =A1=FALSE in Excel alle TRUE. HotXLS nimmt dieselbe Substitution vor, bevor es die beiden Operanden rangiert, für alle sechs Vergleichsoperatoren und in beiden Engines. Sind beide Operanden leer, findet keine Substitution statt, und sie vergleichen sich als gleich
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;                  // das erste Sheet wird das aktive
  Sh.Range['B1', 'B1'].Value := 5;      // A1 bleibt absichtlich leer

  Writeln(VarToStr(Wb.Calculate('=A1=0')));      // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));     // True
  Writeln(VarToStr(Wb.Calculate('=A1=FALSE')));  // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));     // True: die Leerzelle vergleicht als 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));      // False: 0 liegt nicht unter 0
end;
Die letzte Zeile ist die, die in der Praxis beißt. Die Arithmetik behandelt eine Leerzelle bereits als 0, also liefert =A1+1 in jeder Engine die 1. Beim Vergleich geht die Abkürzung schief. Eine Engine, die „leer“ als eigenen untersten Rang hält, unter jeder Zahl, antwortet auf =A1<0 mit TRUE, und dann markiert =IF(A1<0,"overdrawn","ok") jede leere Saldozelle als überzogen. Nur 0 oder den leeren String zu substituieren, reicht ebenfalls nicht: Gegen einen Boolean würde die Leerzelle zu 0, das unter sowohl TRUE als auch FALSE rangiert, und =A1=FALSE käme bei einer leeren Zelle als FALSE heraus
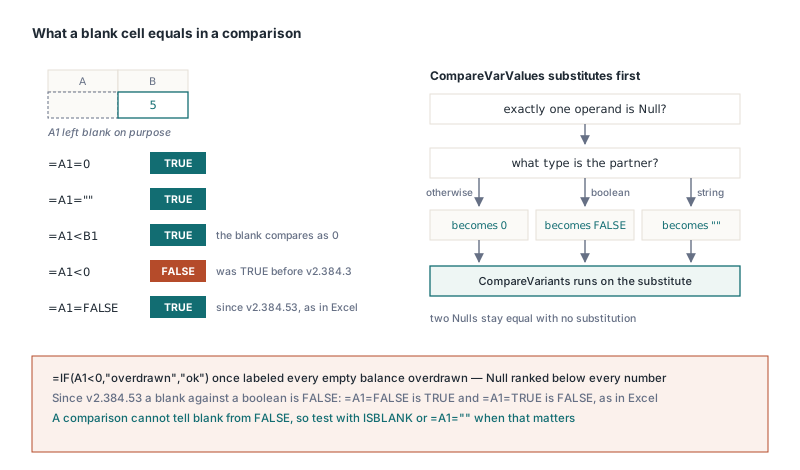
Es gibt eine Konsequenz, die man einplanen sollte. Weil eine Leerzelle gegen einen logischen Wert als FALSE vergleicht, kann =A1=FALSE eine leere Zelle nicht von einer Zelle unterscheiden, die FALSE hält, in Excel wie in HotXLS, und =A1=0 kann leer nicht von null unterscheiden. Templates, die wissen müssen, ob jemand tatsächlich einen Wert eingegeben hat, sollten mit ISBLANK(A1) testen. Die Form =A1="" ist schwächer, denn sie ist auch für eine Formel TRUE, die einen leeren String zurückgibt
Warum deckt SUMIF mit Ein-Zell-Summenbereich die ganze Spalte ab?
Excel behält die Form des Kriterienbereichs bei und nutzt den Summenbereich nur für dessen obere linke Zelle, also bedeutet =SUMIF(A1:A10,">5",B1) B1:B10. Viele handgebaute Templates verlassen sich auf diese Kurzform, ohne dass ihre Autoren es wissen. Die naheliegende Implementierung, den Lauf auf den kleineren der beiden Bereiche zu klemmen, reduziert das Beispiel auf einen einzigen Test von A1 gegen B1 und liefert 0. HotXLS läuft den Kriterienbereich ab und liest jeden Wert mit demselben Zeilen- und Spalten-Offset von der oberen linken Ecke des Summenbereichs. AVERAGEIF macht denselben Lauf und bekommt dieselbe Aufweitung, und ein Summenbereich, der größer als der Kriterienbereich ist, wird auf die Kriterienform zugeschnitten
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // Kriterien-Spalte: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // Beträge: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';      // Ein-Zell-Summenbereich
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)';  // expliziter Summenbereich
    Sheet.Cells[3, 4].Formula := '=AVERAGEIF(A1:A10,">5",B1)';  // dieselbe Aufweitung
    if Book.Recalculate = lxOk then
      // D1 und D2: 4000 (600+700+800+900+1000); D3: 800
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ',
        VarToStr(Sheet.Cells[2, 4].Value), ' ', VarToStr(Sheet.Cells[3, 4].Value));
  finally
    Book.Free;
  end;
end;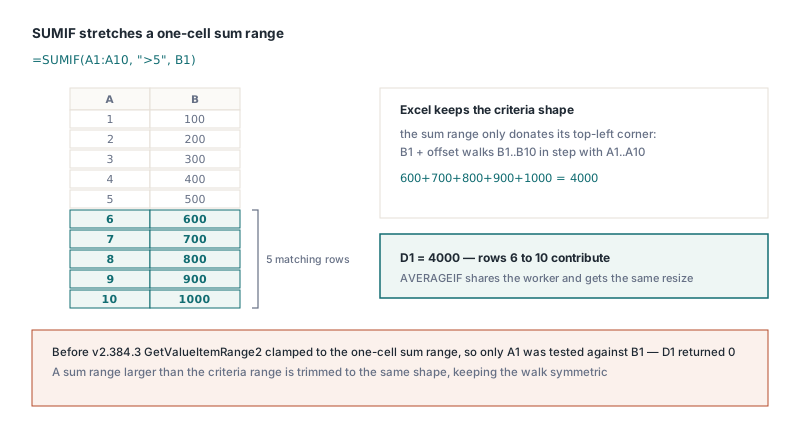
Für Templates, die Sie selbst schreiben, schreiben Sie den vollen Summenbereich aus. Die Engine ehrt die Kurzform, weil bestehende Dateien davon abhängen, aber B1 in einer Formel liest sich für die nächste Person, die das Sheet pflegt, wie eine einzelne Zelle, und diese Person wird vernünftigerweise annehmen, dass nur ein Betrag addiert wird. Das Kriterien in der Mitte wird als einzelner Wert ausgewertet, während die beiden äußeren Argumente Referenzen sind; diese Aufteilung zwischen Argumentklassen erklärt der Artikel über implizite Intersection und Argumentklassen. Bedingte Summen, die zusätzlich gefilterte oder ausgeblendete Zeilen überspringen müssen, folgen wieder anderen Regeln, behandelt im Artikel zu SUBTOTAL und AGGREGATE bei ausgeblendeten Zeilen
INDIRECT-Referenzstile und YEARFRAC-Basis 0
Zwei kleinere Funktionen tragen dieselbe Art Falle. INDIRECT nimmt ein optionales zweites Argument, a1, und wenn es FALSE ist, ist der Text eine R1C1-Referenz: =INDIRECT("R2C3",FALSE) liest C2. Ein Parser, der das Flag ignoriert, liest „R2“ als Spalte R, Zeile 2, was eine echte Zelle ist, also liefert die Formel einen plausiblen Wert vom falschen Ort. HotXLS liest das Flag als Boolean, als Zahl (null bedeutet FALSE) oder als Text „FALSE“ und wandelt R1C1-Text vor der Auflösung um, wobei geklammerte Offsets wie R[1]C[1] von der Zelle gemessen werden, die die Formel hält. Text mit etwas Übriggebliebenem nach einer gültigen Referenz, etwa "B2 junk", liefert #REF!, statt stumm B2 zu verwenden
YEARFRAC mit Basis 0 nutzt die US-Zählung (NASD) 30/360, einschließlich der Ende-Februar-Regeln, die DAYS360 anwendet: Liegen beide Daten am letzten Februar-Tag, wird der Endtag zu 30, und danach wird ein am letzten Februar-Tag liegender Start zu 30. Von 2024-02-29 bis 2025-02-28 ergibt das 360 Tage und einen Bruchteil von exakt 1. Ein schlichter 30/360-Zähler, der diese Regeln überspringt, gibt 359 Tage und 0,99722, und die Differenz taucht in Zinsanrechnungen auf, die über das Ende des Februars laufen
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['C2', 'C2'].Value := 'row 2, column 3';

  Writeln(VarToStr(Wb.Calculate('=INDIRECT("R2C3",FALSE)')));   // Zeile 2, Spalte 3
  Writeln(VarToStr(Wb.Calculate('=ISERROR(INDIRECT("B2 junk"))')));  // True: #REF!
  Writeln(VarToStr(Wb.Calculate(
    '=YEARFRAC(DATE(2024,2,29),DATE(2025,2,28),0)')));           // 1
end;
Wenn Sie solches Verhalten dokumentieren oder testen, nehmen Sie die erwarteten Werte aus Excel selbst, nicht aus dem, was die Formel zu sagen scheint. „1 ist kleiner als 2 ist kleiner als 3“ legt nahe, dass =1<2<3 TRUE ist, was genau die Antwort eines rechtsassoziativen Parsers ist und das Gegenteil dessen, was Excel liefert. Eine kurze Tabelle von Formeln mit den Werten, die Excel daneben zeigt, fängt alle vier Fälle dieses Artikels ein: Ketten, Leerzellen, die SUMIF-Aufweitung und die Februar-Tagezählung
HotXLS liest, berechnet neu und schreibt XLS, XLSX, ODS und CSV aus Delphi und C++Builder heraus, ohne Excel auf der Maschine, und die Vergleichs-, Leerzellen- und bedingten Aggregat-Regeln oben gehören zur Berechnungs-Engine, die beide Workbook-Klassen teilen. Die Liste der unterstützten Funktionen, Editionen und Lizenzierung finden Sie auf der Seite der HotXLS Delphi spreadsheet component