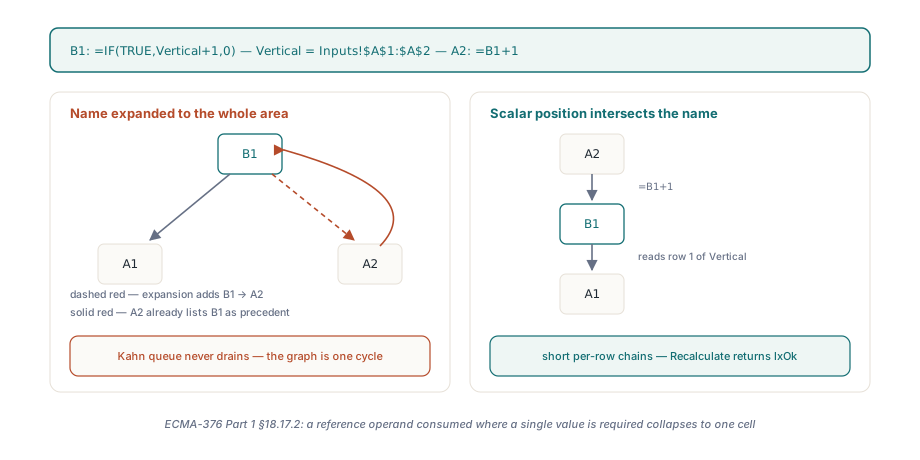
Einen definierten Namen, der auf eine ganze Spalte verweist, liest Excel als einzelne Zelle, sobald er an einer skalaren Position auftaucht: =Vertical+1 in Zeile 7 bedeutet „die Zelle aus Zeile 7 von Vertical“, nicht den ganzen Bereich. Das HotXLS Delphi Component wendet diese implizite Schnittmenge in v2.382.4 auf zwei Ebenen an, bei der Auswertung und beim Ziehen der Abhängigkeiten, denn eine Darlehensvorlage mit 4805 Formeln hat gezeigt, dass der richtige Wert allein nicht reicht. Wenn der Abhängigkeits-Läufer den Namen auf seine volle Fläche ausdehnt, schließt eine nachgelagerte Formel, die in irgendeine Zelle dieser Fläche schreibt, einen Kreis, den es nicht gibt, und TXLSXWorkbook.Recalculate verweigert der ganzen Mappe die Dienstleistung
Die Vorlage im Beispiel ist eine klassische Darlehens-Tilgungsmappe. Nachdem jeder gecachte Wert auf 777 vergiftet und ein kompletter Recalculate-Lauf gefahren war, lieferten beide Engine-Architekturen 23 zurück, also lxErrorRef, den Code für den Zirkelbezug. 3842 der 4805 Formeln trafen die unabhängige Erwartung nicht, B18 hielt #VALUE!, E18 stand weiterhin auf 777, und die Anzahl der Zahlungen in J7 hatte die Platzhalter in einer unfertigen Saldo-Spalte gelesen. Hinter einem einzigen Rückgabewert versteckten sich drei getrennte Defekte, und dieser Beitrag geht jeden davon mit dem Quellcode durch, der ihn behoben hat
Warum erzeugt eine skalare Referenz auf einen Spaltennamen einen falschen Kreis?
Weil ein Abhängigkeitsgraph nur Kanten kennt, und eine Kante von einer Formel zu einem 480-Zeilen-Bereich besteht aus 480 Kanten, von denen eine über eine Zelle zurückzeigt, die von der Formel abhängt. Nehmen Sie =IF(TRUE,Vertical+1,0) in B1 mit Vertical definiert als Inputs!$A$1:$A$2 sowie =B1+1 in A2. Excel wertet B1 als A1+1 und A2 als B1+1 aus, eine glatte Kette. Ein Läufer, der B1 als abhängig von A1:A2 einträgt, macht A2 zum Vorgänger von B1, A2 führt B1 bereits als Vorgänger, und die Kahn-Queue, die die inkrementelle Neuberechnung in HotXLS antreibt, sieht keinen der beiden Knoten jemals bei Eingangsgrad null ankommen. Genau aus diesem Muster bestehen Darlehensvorlagen: Jede Periodenzeile referenziert benannte Spalten für Saldo, Zinssatz und Anzahl der Zahlungen, jeder Name spannt den ganzen Tilgungsplan auf, und jede Zeile schreibt zugleich in diese Spalten zurück. Klappen Sie die Namen auf, ist der Graph eine einzige riesige stark zusammenhängende Komponente. Werten Sie sie mit impliziter Schnittmenge aus, ist der Graph ein Satz kurzer Ketten, eine pro Zeile – genau das beschreibt ECMA-376 Part 1 §18.17.2 für einen Referenz-Operanden, der dort konsumiert wird, wo ein Einzelwert gefordert ist
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Skalare Position: Vertical kollabiert zu A1, weil die Formel in Zeile 1 steht
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Ein Name, dessen Definition ein anderer Name ist, schneidet ebenfalls, also A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Referenz-Klassen-Argument: der ganze Bereich wird summiert, keine Schnittmenge
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Zeile 6 liegt außerhalb von A1:A2, die Schnittmenge ist leer und IFERROR greift
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Vor v2.382.4 war dieser Zweig unerreichbar: B1 -> A2 -> B1 war ein Zirkel
    end;
  finally
    Book.Free;
  end;
end;
Wie entscheidet HotXLS, ob ein Argument skalar ist?
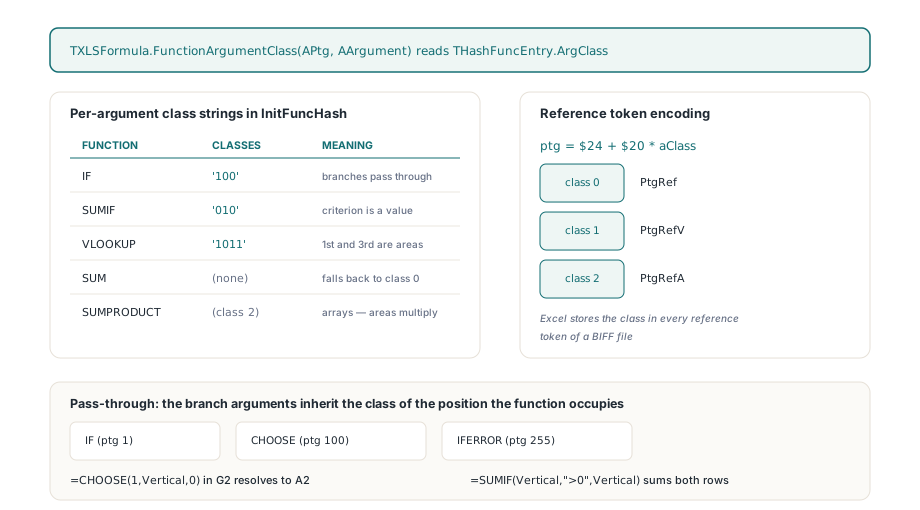
HotXLS liest die Antwort aus der Funktionstabelle statt aus der Gestalt des Arguments. Jeder Eintrag in TXLSFormula.InitFuncHash wird über THashFunc.SetValue mit einem optionalen Klassen-String je Argument registriert: 'IF' trägt '100', 'SUMIF' trägt '010', 'VLOOKUP' trägt '1011', und 'SUM' trägt keinen, sodass alle seine Argumente auf die Funktionsklasse 0 zurückfallen. Das neue TXLSFormula.FunctionArgumentClass(APtg, AArgument) legt dieses Byte über THashFuncEntry.ArgClass offen, und ein Ergebnis von 1 heißt Wertklasse. Das sind dieselben drei Klassen, die [MS-XLS] §2.2.2 den Operand-Tokens zuweist, und der Encoder hängt längst an ihnen: Beim Schreiben einer Referenz berechnet er das ptg als $24 + $20 * aClass, was für Klasse 0 PtgRef, für Klasse 1 PtgRefV und für Klasse 2 PtgRefA ergibt. Eine von Excel geschriebene BIFF-Datei legt diese Klasse in jedem Referenz-Token ab, sodass eine Engine mit spektreuer Tabelle die Frage „ist dieses Argument skalar“ beantworten kann, ohne einen Blick auf die Daten zu werfen. Das mittlere Argument von SUMIF ist das Kriterium, also ein Wert; das erste und das dritte sind Bereiche, also Referenzen. SUMPRODUCT ist mit Funktionsklasse 2 registriert, Array, weshalb =SUMPRODUCT(Vertical,Vertical) weiterhin die ganze Fläche multipliziert
Drei Funktionen fragen für alles nach dem ersten Argument nicht ihren eigenen Tabelleneintrag. IF (ptg 1), CHOOSE (ptg 100) und IFERROR (ptg 255) reichen durch, was sie auswählen, daher erben ihre Zweig-Argumente die Klasse der Position, die die Funktion selbst einnimmt. Diese eine Regel lässt =CHOOSE(1,Vertical,0) in G2 zu A2 auflösen, während =SUMIF(Vertical,">0",Vertical) daneben weiterhin beide Zeilen summiert, und es ist die Regel, die ein Tilgungsplan am härtesten fordert, denn seine Periodenzellen setzen darauf, mit IF zu prüfen, ob das Darlehen noch läuft
Die Klasse durch den Abhängigkeits-Lauf hindurchreichen
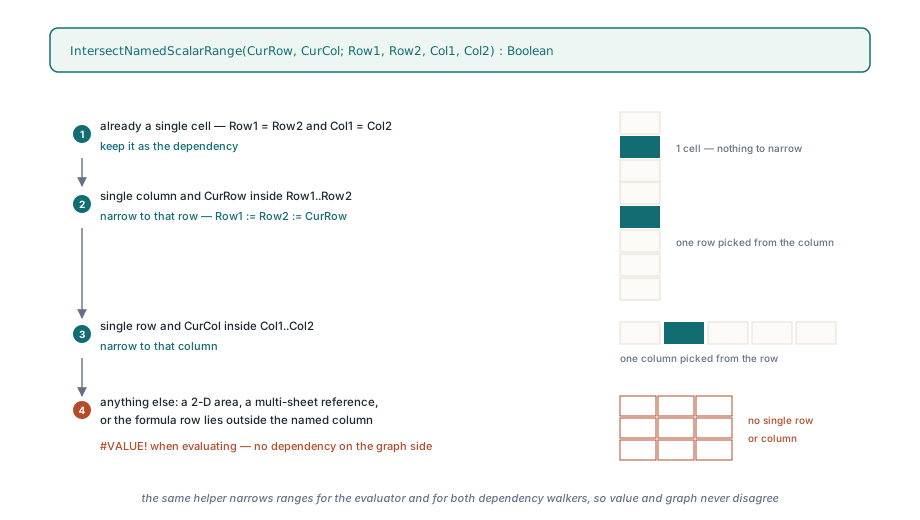
Der Abhängigkeits-Extraktor in lxCalc.pas ist ein rekursives Walk über den kompilierten Syntaxbaum, und er existiert zweimal, einmal in TXLSCalculator.ExtractDependencies für den Graphen pro Mappe und einmal in ExtractWorkspaceDependencies für den mappenübergreifenden Graphen. v2.382.4 gibt beiden Läufern zwei zusätzliche Parameter. AScalar startet an der Wurzel einer Formel als True, wird für jedes Funktions-Kind aus FunctionArgumentClass neu berechnet und für die Zweig-Argumente von ptg 1, 100 und 255 unverändert durchgereicht. ANameRoot wird nur dann True, wenn der Läufer in die kompilierte Definition eines Namens hinabsteigt, und er überlebt ausschließlich SA_GROUP-Knoten, also die Klammern, damit ein Name, der als =A1:A2+1 definiert ist, nicht für einen schlichten Bereich gehalten wird. Sind beide Flags an einem SA_RANGE-Knoten True, schränkt AddResolvedRange den Bereich mit demselben Helper ein, den auch die Auswertung benutzt, bevor sie die Abhängigkeit einträgt. Der Helper ist kurz genug, um ihn komplett zu zitieren
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // bereits eine Zelle
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // einspaltig: diese Zeile nehmen
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // einzeilig: diese Spalte nehmen
    Result := True;
  end;
end;
Was der Helper zurückweist – eine zweidimensionale Fläche, eine blattübergreifende Referenz oder eine Formel, deren Zeile außerhalb der benannten Spalte liegt – liefert auf der Auswertungsseite #VALUE! und auf der Graphenseite überhaupt keine Abhängigkeit, genau wie Excel es bei einer leeren Schnittmenge tut. Die Auswertungsseite wohnt in TXLSCalculator.GetValueItemName: Sie schält die SA_GROUP-Wrapper aus der kompilierten Definition, und wenn die Wurzel ein SA_RANGE ist, ruft sie GetRangeInfo, schneidet und holt die eine Zelle über FGetValue, statt die ganze Definition auszuwerten. Externe Referenzen bleiben auf dem alten Pfad, denn es gibt dort keine lokale Zeile, gegen die man schneiden könnte. Woher der Speicher und der Scope eines Namens überhaupt stammen, klärt der Artikel zu definierten Namen und blattübergreifenden Formeln; hier geht es nur darum, was die Engine tut, sobald der Name aufgelöst ist
Warum las MATCH über eine halb berechnete Spalte 777?
Weil das Lookup-Array-Argument von MATCH eine Scan-Referenz ist und Scan-Referenzen bewusst aus der Auswertungsreihenfolge ausgeschlossen wurden. Der Artikel zum Lookup-Scan stellte TXLSDepRange.LookupScan vor und endete mit einer Sektion mit dem Titel „Was man einbüßt, wenn Scan-Kanten aus der Ordnung ausgeschlossen werden“: Eine Lookup-Formel darf laufen, bevor jede Zelle ihres Bereichs neu berechnet wurde, und veraltete Werte lesen. In einer interaktiven Session konvergiert das im nächsten Durchlauf. Bei einer Batch-Neuberechnung einer vergifteten Vorlage tut es das nicht, und PaymentCount, definiert als =MATCH(0.01,Balances,-1)+1, las die 777-Platzhalter, die noch in der Saldo-Spalte standen, und lieferte eine Periodenanzahl, die nicht stimmen konnte
TXLSDepGraph.TopoOrder behandelt Scan-Kanten jetzt als weiche Ordnungs-Kanten. Neben dem harten Eingangsgrad führt sie ein ScanInDeg-Array mit, das je Knoten die schmutzigen Scan-Vorgänger zählt und abbaut, sobald diese ausgegeben werden, und benutzt dafür die Listen ScanPrecedents, ScanDependents und ScanPrecedentCount, die die frühere Änderung bereits vorgehalten hat. In jeder Iteration durchsucht die Kahn-Queue ihr Ready-Fenster nach dem ersten Knoten, dessen ScanInDeg null ist, und tauscht ihn an den Kopf; wartet jeder bereite Knoten noch auf einen Scan-Vorgänger, wird der Kopf in stabiler Reihenfolge entnommen. Scan-Kanten fließen nie in den harten Eingangsgrad, daher bleibt ein selbstreferenzielles VLOOKUP über die eigene Spalte legal, aber ein Lookup, das auf einen abarbeitbaren Vorgänger warten könnte, wartet jetzt auch. Das Regressionstest-Muster dazu, LookupScan_WaitsForDirtyFormulaValues, vergiftet drei Saldo-Zellen auf 777 und erwartet, dass PaymentCount als 3 zurückkommt, dann stellt es die Eingabe auf null und erwartet, dass =IFERROR(PaymentCount,99) das #N/A sieht und 99 liefert
Woher kam die Abschneidung auf vier Dezimalstellen?
Aus Delphi-Variant-Arithmetik, und nur in verschachtelten Positionen. Die binären Operatoren in TXLSCalculator.GetValueItem hatten ein top-level + oder - bereits in zwei Double-Locals kopiert, sodass =B1-A1 unproblematisch war. Innerhalb von =IF(TRUE,B1-A1,0) lief dieselbe Subtraktion als Value := Value - SubValue auf zwei Varianten, und wenn ein Operand ein Int64-Zellwert war und der andere ein Double, war das Ergebnis unserer Beobachtung nach ein Currency, ein Festkomma-Typ mit vier Dezimalstellen, sodass 1066.1854641400994 minus 120 auf vier Nachkommastellen abgeschnitten zurückkam. In einem Plan, in dem jede Zahlung aus der vorherigen Zeile weiterverzinst wird, wandert dieser Fehler durch hunderte Perioden, bevor er die Summen erreicht
// TXLSCalculator.GetValueItem, Zweig für binäre Arithmetik (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Gemischte Int64/Double-Variant-Arithmetik kann zu Currency promoten.
// Tabellen-Arithmetik muss die Fließkomma-Präzision bewahren.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Die Absicherung läuft vor SA_ADD, SA_SUB, SA_MUL und SA_DIV gleichermaßen, und das Regressionstest-Muster Arithmetic_MixedInt64AndDoubleKeepsPrecision legt Int64(120) in A1 und 1066.1854641400994 in B1 ab und prüft dann die verschachtelte Differenz und Summe auf 1E-10 sowie Produkt und Quotient auf 1E-8 und 1E-12. HotXLS beansprucht nicht, jede Promotionsregel zu kennen, die das RTL je nach Compilerversion auf gemischte Variant-Typen anwendet; es behauptet, dass Tabellen-Arithmetik IEEE double ist, und macht jetzt beide Operanden zu Doubles, bevor der Operator sie sieht – damit erledigt sich die Frage
Was der Fix garantiert und was nicht
Nach v2.382.4 liefern beide Engine-Architekturen für die vergiftete Vorlage lxOk zurück, alle 4805 gecachten Werte treffen die unabhängige Erwartung Zeile für Zeile innerhalb von 1E-7, und die Asserts, dass die Caches wirklich vergiftet waren, dass der Quell-Hash unverändert blieb und dass jede Formel noch vorhanden ist, halten allesamt. Iteration wurde dafür nicht eingeschaltet und kein Fehlercode unterdrückt. Ein echter Kreis über einen Namen – =B1 in A1, während B1 weiter Vertical liest – liefert weiterhin einen Fehler, und der Test NamedScalarRanges_IntersectWithoutFalseCycles endet mit exakt dieser Behauptung
Die Grenzen sind eine klare Ansage wert. Implizite Schnittmenge greift nur bei einem Namen, dessen kompilierte Definition nach dem Abtrennen der Klammern eine einspaltige oder einzeilige Fläche auf einem Blatt ist; ein zweidimensionaler Name an skalarer Position liefert #VALUE!, wie in Excel, und eine Funktion, die die Tabelle nicht kennt, bekommt von FunctionArgumentClass die Klasse 0, sodass ihre Namens-Argumente weiterhin voll aufgespannt werden. Die weiche Ordnung ist eine Präferenz, kein Garant: Ein reiner Scan-Kreis wird weiterhin in stabiler Reihenfolge ausgewertet und liest, was gerade gecacht ist, genau das Verhalten, das der Lookup-Scan-Artikel bewusst akzeptiert hat. Und das Ergebnis für die ganze Vorlage wird gegen ein unabhängiges Erwartungs-Skript verifiziert, nicht gegen eine andere Tabellen-Engine, denn die Referenz-Office-Suite hat die Neuberechnung der Original-Vorlage in einem 60-Sekunden-Budget nicht zu Ende gebracht. HotXLS ist eine native Delphi- und C++Builder-Tabellenkomponente, die XLS, XLSX, ODS und CSV liest, neu berechnet und schreibt, ganz ohne installiertes Excel; die Namensschnittmenge, die Argument-Klassen-Tabelle und die weiche Scan-Ordnung greifen in jedem Format, weil die Berechnungsengine geteilt ist, und die aktuelle Funktionsabdeckung listet die HotXLS Delphi Tabellenkomponente-Produktseite auf