Ein Erkennungs-Timeout von 5.000 ms bei einem In-Process-Tesseract-Aufruf heißt nicht, dass der Aufruf nach fünf Sekunden zurückkommt. Mit einem großen mehrsprachigen Modellset kann der aufrufende Thread deutlich über dieser Marke in der nativen Bibliothek stecken, denn der Progress-Monitor, der die Frist durchsetzt, wird gepollt, während Wörter erkannt werden, und Modellladen und Layout-Analyse passieren beide vor dem ersten Poll. Diese Lücke, ein Cancel-Callback, dessen C-Rückgabetyp ein einzelnes Byte ist, und ein Iterator, der Speicher aushändigt, den man niemals freigeben darf, sind die eigentliche Arbeit, die Tesseract-C-API an Delphi zu binden. Der Rest ist Klempnerarbeit
Die Tesseract-DLL in eine HotPDF-Textebene einbinden
HotPDF legt den In-Process-Pfad als HPDFCreateTesseractDLLOCREngine in der Unit HPDFTesseractRecognition offen. Die Factory lädt eine Tesseract-DLL, die die C-API exportiert, treibt TessBaseAPIInit2, TessBaseAPIRecognize und den Result-Iterator an und liefert ein IHPDFOCREngine zurück. THotPDF.ApplyLoadedOCRTextLayer nimmt diese Engine und legt über gescannte Seiten eine unsichtbare, durchsuchbare Unicode-Textebene, derselbe Aufruf, den jede HotPDF-OCR-Engine durchläuft
Die Factory validiert früh. Die DLL-Datei und das tessdata-Verzeichnis müssen existieren. Der Sprachbezeichner darf nur ASCII-Buchstaben, Ziffern, _ und + enthalten, und jedes Modell einer Kombination wie chi_sim+eng braucht eine passende .traineddata-Datei. Alle 21 geforderten Exporte müssen sich auflösen lassen, bevor Sie eine Engine zurückbekommen. Konfigurationsfehler werfen EArgumentException, ein fehlender Export oder Modell wird namentlich gemeldet; eine DLL, die sich nicht laden lässt, wirft EOSError mit dem Windows-Fehlercode und dem Hinweis, Architektur und Abhängigkeiten zu prüfen
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Eine Win64-Anwendung braucht eine 64-Bit-DLL; der Dateiname hängt vom Build ab,
  // und die Abhängigkeits-DLLs liegen im selben Ordner
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // verwendet THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Eine leere Seitenliste heißt alle Seiten; Seiten, die bereits Text tragen, werden übersprungen
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default setzt PageSegMode auf tpsAuto, EngineMode auf temDefault, TimeoutMilliseconds auf 60.000 und MaxPixels auf 16.777.216. Dieses Pixelbudget zubeißt früher, als man denkt. Eine US-Letter-Seite rendert bei den voreingestellten 300 DPI zu 2.550 × 3.300 Pixeln, rund 8,4 Millionen, und passt. Nehmen wir an, Sie setzen dieselbe Seite auf 600 DPI: Sie wird zu 5.100 × 6.600, etwa 33,7 Millionen Pixel, und die Engine weist sie mit Invalid Tesseract DLL OCR request or pixel budget zurück, bevor Tesseract das Bild überhaupt sieht. Entweder Sie erhöhen MaxPixels (die Obergrenze liegt bei 67.108.864), oder Sie bleiben bei 300 DPI, was für Fließtext reichlich ist; jede Seite ist zudem auf 32.767 Pixel begrenzt
Die DLL wird mit LoadLibraryEx und den Such-Flags für den eigenen DLL-Ordner plus die voreingestellten sicheren Verzeichnisse geladen. Die Bildbibliotheken, von denen Tesseract abhängt, dürfen deshalb daneben liegen, und Sie müssen PATH nie anfassen oder sich auf das aktuelle Verzeichnis verlassen. HotPDF bündelt oder lädt keine OCR-Runtime und kein Sprachmodell herunter; beides stellen Sie bereit
Was der DLL-Pfad gegenüber tesseract.exe ändert
Denselben Recognizer erreichen Sie auch über den externen tesseract.exe-Adapter, der ein BMP schreibt und TSV parst. Beide Adapter speisen dieselbe Textebenen-Pipeline, daher verhalten sich Koordinaten-Mapping, Confidence-Filterung und das Alles-oder-Nichts-Commit identisch. Anders ist, wie Pixel hineingehen, wie Wörter herauskommen und was passiert, wenn sich der Recognizer falsch verhält
| Aspekt | tesseract.exe-Adapter | Tesseract-DLL-Adapter |
|---|---|---|
| Factory | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Pixel rein | BMP-Datei in einem privaten temporären Verzeichnis | 8-Bit-Graustufen-Puffer im Speicher |
| Wörter raus | Wortweises TSV, begrenzt auf 64 MiB | Result-Iterator, UTF-8 pro Wort |
| Baselines | Nicht im TSV; die Pipeline schätzt sie | Durchgereicht aus TessPageIteratorBaseline |
| Seitensegmentierung und Engine-Modus | THPDFTesseractOptions-Overload, gesendet als --psm und --oem | THPDFTesseractOptions, übergeben an TessBaseAPISetPageSegMode und TessBaseAPIInit2 |
| Pixelbudget | MaxPixels, wenn Optionen übergeben werden | MaxPixels immer, plus 32.767 Pixel je Seite |
| Timeout | Hart: der Kindprozess wird terminiert | Kooperativ: Tesseract muss es selbst bemerken |
| Crash- und Speicherisolation | Separater Prozess | Keine, er teilt Ihren Adressraum |
Ein Kostenpunkt bleibt bei der DLL. Jeder Recognize-Aufruf erzeugt seine eigene API-Instanz und fährt TessBaseAPIInit2, die Sprachmodelle werden also für jede Seite initialisiert. Der Datei-Cache mildert das Neuladen, doch mit einem großen mehrsprachigen Modellset bleibt es der größte Fixkostenpunkt pro Seite, und er geht von der Erkennungsfrist ab. Die In-Process-RapidOCR-DLL-Engine entscheidet sich gegenteilig und hält ihre ONNX-Modelle über die Lebensdauer der Engine resident, während die Grenzprobleme (C-ABI, geliehene Buffer, native Arbeit, die man nicht unterbrechen kann) zur selben Familie gehören
Was gehört also in die Produktion? Für ein Desktop-Tool oder einen Batch-Job, der ein paar hundert Scans abarbeitet, ist die DLL die bessere Wahl: kein Prozessstart pro Seite, keine temporäre Bitmap auf der Platte und echte Baselines für krumme Zeilen. Ein dauerlaufender Server, der PDFs von Fremden annimmt, bleibt bei tesseract.exe, denn ein nativer Crash oder eine ausufernde Allokation reißt dort nur einen Kindprozess mit, nicht Ihren Dienst
Warum kann Delphi die Tesseract-Monitor-Struktur nicht kopieren?
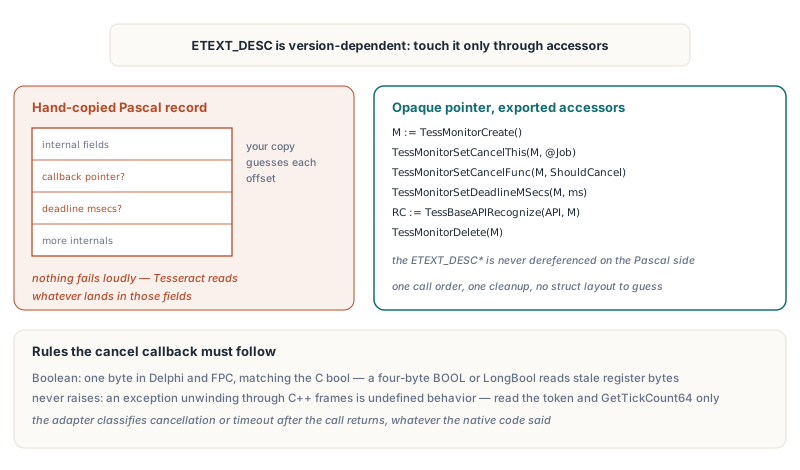
Delphi kann Tesseracts Progress-Monitor nicht gefahrlos spiegeln, denn ETEXT_DESC trägt interne Felder, die zwischen Tesseract-Builds variieren. Ein Record, der von Hand aus einem Header übersetzt wurde, legt den Cancel-Callback und die Frist auf genau die Offsets, die dieser Header verwendete. Läuft er gegen einen anderen Build, liest Tesseract Ihren Callback-Zeiger aus einem Feld, das inzwischen etwas anderes bedeutet, oder findet die Frist gar nicht, und die Erkennung läuft einfach bis zum Ende
Der HotPDF-Adapter behandelt den Monitor deshalb als opaken Zeiger und fasst ihn nur über exportierte Funktionen an: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs und TessMonitorDelete. Der Sketch unten ist Ihre eigene Bindungs-Codebasis, nicht HotPDF-API; seine Deklarationen entsprechen denen, die der Adapter per GetProcAddress auflöst
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, nie dereferenziert
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // Ihr eigener Job-Zustand, kein HotPDF-Typ
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Läuft auf Tesseracts Stack: ein Flag und die Uhr lesen, niemals auswerfen
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Verwendung, mit den per GetProcAddress aufgelösten Funktionszeigern:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Der Sketch tippt den Callback als Boolean, in Delphi wie in Free Pascal ein Byte, was zum C-bool in TessCancelFunc passt. Das vierbyteige Windows-BOOL und Delphis LongBool sehen austauschbar aus und sind ein anderer Typ: Schreibt die eine Seite ein einzelnes Byte und liest die andere vier, sind die oberen drei Bytes, was das Register vorher hielt, und ein false kann als true ankommen. TessPageIteratorBoundingBox liefert ein int, auf der Pascal-Seite als Integer deklariert; lesen Sie also den C-Typ jedes Rückgabewerts, statt eine Regel für die ganze API anzunehmen
Der Callback wirft außerdem nie. Eine Delphi-Exception, die durch Tesseracts C++-Frames unwindet, ist undefiniertes Verhalten. Der HotPDF-Callback liest nur das Abbruch-Token und einen monotonen GetTickCount64-Wert, und der Adapter macht aus dem Ergebnis nach der Rückkehr von TessBaseAPIRecognize eine Abbruch- oder Timeout-Diagnose. Er fährt diese Prüfung, egal ob der native Rückgabecode 0 war oder nicht
Welche nativen Zeiger besitzt die Delphi-Seite?
Der HotPDF-Tesseract-DLL-Adapter besitzt drei native Objekte pro Anfrage (die API-Instanz, den Monitor und den Result-Iterator) und leiht alles andere. Jeder Recognize-Aufruf erzeugt sein eigenes Set und gibt es in einem finally-Block in fester Reihenfolge frei: TessResultIteratorDelete, dann TessMonitorDelete, dann TessBaseAPIDelete. Das Freigeben der Engine-Schnittstelle ruft FreeLibrary auf der DLL auf
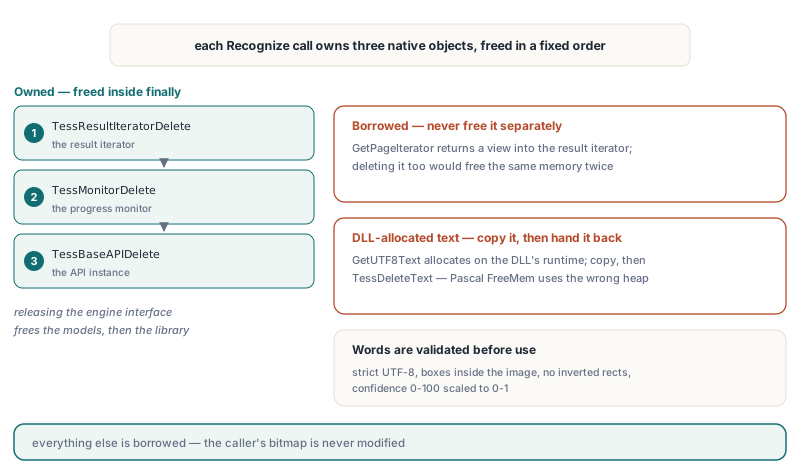
TessResultIteratorGetPageIteratorliefert eine Sicht in den Result-Iterator statt eines neuen Objekts. Der Adapter nutzt sie fürTessPageIteratorBoundingBoxundTessPageIteratorBaselineund gibt sie nie frei; sie zusätzlich zu löschen würde denselben Speicher zweimal freigebenTessResultIteratorGetUTF8Textliefert einen String, den die eigene Runtime der DLL alloziert hat. Der Adapter dekodiert ihn und reicht ihn in einemfinally-Block überTessDeleteTextzurück, denn Pascal-FreeMemwürde ihn auf dem falschen Heap freigeben- Worttext durchläuft zuerst strenge UTF-8-Dekodierung mit Längenprüfung. Ein Wort mit Steuerzeichen, kaputtem UTF-8, einer Box außerhalb des Bilds, einem invertierten Rechteck oder einer Confidence außerhalb 0–100 lässt die Anfrage scheitern; der Adapter flickt das nicht zurecht
- Text pro Anfrage ist auf 1.048.576 UTF-16-Codeeinheiten begrenzt, und die Wortanzahl muss in das Budget passen, das
ApplyLoadedOCRTextLayerjeder Seite mitgibt
Die Confidence kommt als 0–100 an und wird auf 0–1 skaliert, damit THPDFOCRTextLayerOptions.MinimumConfidence für jede Engine dasselbe bedeutet. Meldet Tesseract eine Baseline, werden beide Endpunkte durchgereicht, und bei einem überwiegend vertikalen Wort dient die Box-Breite als Texthöhe. Ohne Baseline fällt die Textebenen-Pipeline auf ihre geometrische Schätzung zurück, genau wie bei TSV-Eingabe
Enum-Optionen bereichsprüfen, bevor sie die DLL erreichen
Die Factory kopiert die rohen Bytes von PageSegMode und EngineMode in einen Integer, bevor sie sie bereichsprüft. Ein Compiler darf annehmen, dass eine Enum-Variable stets einen deklarierten Wert hält, also kann ein Test wie Ord(X) > Ord(High(T)), direkt gegen das Enum geschrieben, zu einem konstanten false gefaltet werden. Diese Ordinale erreichen die DLL als schlichte Integer: THPDFTesseractPageSegMode folgt Tesseracts Seitensegmentierungs-Nummerierung von 0 bis 13, THPDFTesseractEngineMode dessen Engine-Modus-Nummerierung von 0 bis 3. Ein Options-Record, der mit FillChar geleert, aus einem Stream gelesen oder aus C++Builder über einen Integer-Cast gefüllt wurde, kann ein Byte wie 200 tragen, und die Prüfung der Kopie macht daraus zur Factory-Zeit ein EArgumentException. Die Factory weist auch tpsOSDOnly und tpsAutoOnly zurück, die keine Wörter liefern, und verlangt osd.traineddata für tpsAutoOSD und tpsSparseTextOSD
Was garantiert die Erkennungs-Timeout tatsächlich?
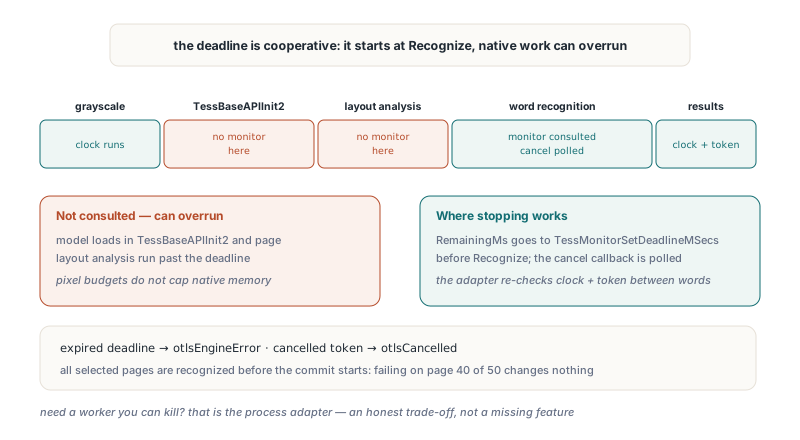
Das Tesseract-DLL-Timeout ist kooperativ: HotPDF kann die eigene Arbeit anhalten und Tesseract bitten, ebenfalls aufzuhören, aber es kann nativen Code nicht zur Rückkehr zwingen. Die Uhr startet, wenn Recognize beginnt, Graustufenkonvertierung und Modellinitialisierung zehren also vom selben Budget wie die Erkennung selbst. Der Adapter prüft verstrichene Zeit und das Abbruch-Token alle 64 Zeilen während der Graustufenkonvertierung, nach der Initialisierung und vor jedem Wort beim Durchwandern der Ergebnisse. Direkt vor TessBaseAPIRecognize reicht er die verbleibenden Millisekunden an TessMonitorSetDeadlineMSecs
Die Lücke steckt innerhalb der nativen Aufrufe. Tesseract befragt seinen Monitor nur während der Worterkennung, also kann innerhalb von TessBaseAPIInit2 oder der Layout-Analyse ein langsames Modellladen oder ein pathologisches Layout über die Frist hinauslaufen, bevor der Timeout gemeldet wird. Die Pixel- und Ausgabebudgets begrenzen den eigenen Speicherverbrauch der nativen Bibliothek ebenfalls nicht. Wenn Sie einen Worker brauchen, den Sie garantiert killen können, ist der Prozess-Adapter das Werkzeug dafür
Die Seitensegmentierung ist der Punkt, an dem sich der DLL-Adapter bei unangenehmer Eingabe auszahlt. Formulare, Etiketten und gescannte Tabellen mit verstreuten Feldern erkennen mit tpsSparseText oft besser als mit automatischer Segmentierung, die versucht, Spalten und Absätze zusammenzubauen, die gar nicht da sind. Das Timeout unten ist kurz für eine Formularseite und muss trotzdem die Modellinitialisierung abdecken
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // verstreute Felder, kein Spaltenzusammenbau
  TessOptions.EngineMode := temLSTMOnly;     // braucht LSTM-Modelle in tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // inklusive Modellinitialisierung
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Ein Timeout zeigt sich als otlsEngineError mit Tesseract DLL OCR timed out in der Diagnose. Ein über THPDFOCRTextLayerOptions.CancellationToken gesetztes Token zeigt sich als otlsCancelled. In beiden Fällen erkennt ApplyLoadedOCRTextLayer jede ausgewählte Seite, bevor es das Commit startet, ein Fehlschlag auf Seite 40 von 50 lässt das geladene Dokument also genau wie vorher. tpsSingleLine, tpsSingleBlock und tpsSparseText ändern nur die Segmentierung; keiner davon richtet einen krummen Scan auf
Free Pascal und Lazarus: veraltete Pixel und verlorenes Chinesisch
Beide Tesseract-Factorys funktionieren in Windows-Free-Pascal- und Lazarus-Builds für Win32 und Win64, sobald das Lazarus-Paket für die Zielarchitektur neu gebaut wurde; den allgemeinen Port deckt HotPDF auf Free Pascal und Lazarus Win64 ab. Bei der Eingabebehandlung zeigt FPC ein anderes Verhalten
Eine LCL-TBitmap, die über Scanlines beschrieben wird, kann ihr Raw-Image aktualisieren, ohne das Windows-Bitmap-Handle zu erneuern, daher liefert GetDIBits auf diesem Handle die alten Pixel. Das Symptom ist rätselhaft: Direkt auf eine Bitmap gezeichneter Text wird erkannt, eine über Scanlines gerenderte Seite liefert keine Wörter. Unter FPC liest der DLL-Adapter einen formatbewussten Snapshot über CreateIntfImage, der Pixelformat und Zeilenreihenfolge des Raw-Images respektiert. Der Delphi-Build behält den GetDIBits-Pfad auf einer privaten 24-Bit-Kopie, und kein Build verändert die Bitmap des Aufrufers
Der tesseract.exe-Adapter trifft ein anderes Problem. FPCs TStringList speichert ANSI-Strings, also fallen beim Zuweisen von dekodiertem UTF-8-TSV-Text an Lines.Text alle chinesischen oder Supplementary-Plane-Zeichen unter den Tisch, die die System-ANSI-Codepage nicht darstellen kann. Der FPC-Pfad behält das TSV als UTF-8-Bytes, streift das BOM auf Byte-Ebene und dekodiert jedes Wort selbst zu UnicodeString. Der DLL-Adapter trifft das Problem nie, weil er jedes Wort direkt aus dem Iterator dekodiert
Der Tesseract-DLL-Adapter kommt zusammen mit den Prozess-Adaptern und der eingebauten OCR-Engine in HotPDF für Delphi, C++Builder und Free Pascal. Editionen und Downloads listet die Seite HotPDF Delphi PDF Component