TerminateThread sieht aus wie der naheliegende Weg, einen OCR-Aufruf zu stoppen, der auf einer gescannten Seite schon länger vor sich hin werkelt, als Ihre UI warten will. Die Windows-Dokumentation erklärt, warum es keiner ist: Hält der Ziel-Thread den Process-Heap-Lock, wird dieser Lock nie freigegeben, und die nächste Allokation auf jedem anderen Thread kann für immer blockieren. Läuft OCR erst einmal im eigenen Prozess, ist der einzige sichere Stopp ein kooperativer, an Checkpoints zwischen den Inferenzstufen, und das ist der Preis dafür, die ONNX-Modelle einmal zu laden und warm zu halten
Die Alternative, die die meisten Delphi-Teams zuerst probieren, ist ein Kindprozess. Ein Python-Worker pro Seite lässt sich jederzeit killen, was verlockend ist, aber jeder Aufruf startet einen Interpreter, importiert seine Runtime und lädt Detection- und Erkennungsmodelle, bevor er ein Pixel liest. Nehmen Sie einen Archivjob mit 500 Seiten: Diese Startarbeit läuft 500 Mal, und das Deployment enthält nun eine Python-Umgebung neben einer nativen Executable
Durchsuchbares PDF aus Scans mit HPDFCreateRapidOCRDLLOCREngine
HotPDF fährt RapidOCR in-process über HPDFCreateRapidOCRDLLOCREngine, deklariert in der Unit HPDFRapidOCRRecognition. Die Factory lädt HotPDFRapidOCR.dll, initialisiert die ONNX-Modelle für Detection, optionale Winkelklassifikation und Erkennung einmal und gibt ein IHPDFOCREngine zurück. Diese Engine dockt an THotPDF.ApplyLoadedOCRTextLayer an wie jede andere OCR-Engine: Das Dokument rendert jede Seite, die DLL fährt darauf CPU-Inferenz, und das Ergebnis wird als unsichtbare Unicode-Textebene committet. Kein Python, kein Kindprozess. Der Adapter kommt für Delphi-, C++Builder- und Windows-FPC/Lazarus-Builds
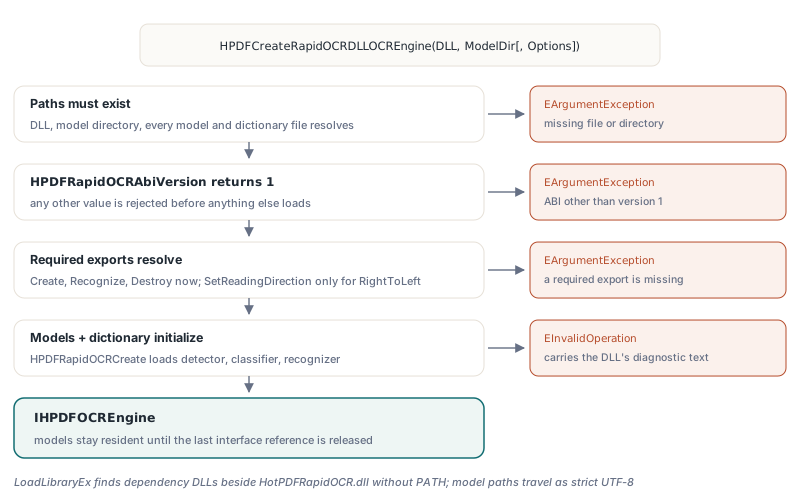
Die Validierung passiert in der Factory, bevor eine Seite angefasst wird. Jede Modell- und Wörterbuchdatei muss auflösbar sein, HPDFRapidOCRAbiVersion muss 1 zurückgeben, und die benötigten Exporte müssen existieren, ehe HPDFRapidOCRCreate die Modelle baut. Konfigurationsfehler werfen EArgumentException; ein Modell, das sich weigert zu laden, wirft EInvalidOperation mit der eigenen Diagnose der DLL, etwa einem Wörterbuch, das nicht zum Erkennungsmodell passt
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Die Modelle laden hier, außerhalb jeder Erkennungsfrist.
  // Relative Namen in THPDFRapidOCRDLLOptions.Default lösen
  // sich gegen das Modellverzeichnis auf.
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // leere Seitenliste = jede Seite; SkipPagesWithText ist standardmäßig True
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default nennt ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx und ppocr_keys_v1.txt, mit einem CPU-Thread, einem Eingabelimit von 16.777.216 Pixeln und einer Frist von 60.000 ms pro Erkennungsaufruf. Für andere Schriften hält THPDFRapidOCRDLLOptions.ForLanguage diese Defaults und tauscht <profile>/recognition.onnx plus <profile>/dictionary.txt für eines von neun Profilen ein, von Traditionellem Chinesisch und Kyrillisch bis Arabisch und Devanagari. Jede Engine liest eine Sprache; wählen Sie das Profil pro Seite oder pro Dokument. Warum Modell und Wörterbuch stets als Paar reisen, behandelt RapidOCR-Multilingual-Modelle und CTC-Wörterbücher in HotPDF
Die Engine meldet sich als RapidOCR (native DLL) in Info.EngineName. Loggen Sie diesen String. Läuft derselbe Dienst auch mit dem externen Tesseract-OCR-Prozessadapter oder der eingebauten Template-Matching-OCR-Engine, ist das der schnellste Weg festzustellen, welcher Recognizer eine schlechte Seite produziert hat
Warum spricht die C-ABI nur int32_t und UTF-8-Bytes?
Die HotPDFRapidOCR.dll-Grenze nutzt feste Breiten-Integer, rohe Zeiger und explizite Bytelängen, denn Delphi, C++Builder und Free Pascal teilen mit MSVC nichts außer der C-Aufrufkonvention. Ein std::string, ein std::vector oder eine C++-Exception trägt ein Speicherlayout und ein Unwinding-Modell mit sich, die zu einem Compiler und einer Runtime-Bibliothek gehören, und eines davon in Pascal-Code überqueren zu lassen endet in einem korrupten Stack oder einem Heap-Block, den der falsche Allokator freigibt
ABI-Version 1 ist eine kurze Regelliste. Jeder Export ist cdecl und liefert einen int32_t-Status zurück: 1 für Erfolg, 0 für Misserfolg. Jede Funktion, die scheitern kann, nimmt einen Diagnosepuffer in Aufruferbesitz samt seiner Größe in Bytes, und die DLL schreibt eine NUL-terminierte UTF-8-Nachricht, auf passende Länge gekürzt. Innerhalb der DLL sitzt jeder Exportkörper in einem try mit sowohl catch (const std::exception &) als auch catch (...). Ein ONNX-Runtime-Fehler, eine OpenCV-Assertion oder ein missgestaltetes Wörterbuch wird zu Status 0 plus Text
| Export | Rolle | Wann der Adapter ihn auflöst |
|---|---|---|
HPDFRapidOCRAbiVersion | Liefert 1; jeder andere Wert wird abgewiesen | Unmittelbar nach dem Laden der DLL |
HPDFRapidOCRCreate | Lädt Detection-, optionale Klassifikations- und Erkennungsmodelle und das Wörterbuch | In der Factory |
HPDFRapidOCRRecognize | Fährt eine Bitmap und feuert einen Callback pro Textzeile | In der Factory |
HPDFRapidOCRDestroy | Gibt die Modellinstanz frei | In der Factory |
HPDFRapidOCRSetReadingDirection | Optionale Rechts-nach-links-Zeilenreihenfolge | Nur wenn RightToLeft gesetzt ist |
Der Reading-Direction-Export wird mit Absicht träge aufgelöst, eine DLL ohne ihn bedient also weiterhin jede Links-nach-rechts-Anfrage. Der Adapter lädt die Bibliothek mit LoadLibraryEx und Suchflags, die den eigenen Ordner der DLL plus die Standard-Safe-Verzeichnisse abdecken; ONNX-Runtime- oder OpenCV-Abhängigkeiten neben HotPDFRapidOCR.dll werden gefunden, ohne PATH anzufassen. Modell- und Wörterbuchpfade reisen als UTF-8 über die Grenze, und die DLL konvertiert sie mit MultiByteToWideChar im Strict-Modus, bevor sie Dateien über Wide-Character-APIs öffnet. Ein Modellverzeichnis unter C:\Users\Łukasz oder ein kyrillischer Benutzername öffnet normal
Eine Regel lebt in den Build-Dateien statt im Header. Die DLL linkt ONNX Runtime und OpenCV statisch, und das CMake-Projekt nutzt die statische Release-CRT (/MT) als Default. Mischen Sie statische Bibliotheken, die gegen /MD kompiliert wurden, ein, bekommen Sie im besten Fall Link-Fehler und im schlechtesten zwei unabhängige Heaps. Stellen Sie Bibliotheken bereit, die zum CRT-Modus der DLL passen
Was passiert zwischen einer TBitmap und einer Textzeile?
HotPDF reicht der DLL eine unabhängige Top-Down-BGR-Kopie der gerenderten Seite, und die DLL reicht einen Callback pro erkannter Zeile zurück. Der Text in diesem Callback ist geliehen: Der Zeiger ist nur gültig, bis der Callback zurückkehrt, der Adapter kopiert ihn also sofort
Auf Delphi kommt der Snapshot aus einer privaten TBitmap, auf pf24bit erzwingt und mit GetDIBits über ein negatives biHeight gelesen wird. Das ergibt Top-Down-Zeilen mit Vier-Byte-Ausrichtung, und der Stride reist als explizites Argument zur DLL. Auf FPC liest der Adapter über CreateIntfImage. Die Bitmap des Aufrufers wird nie verändert. Größenprüfungen laufen, bevor der Kopierpuffer allokiert wird: höchstens 32.767 Pixel pro Seite, und insgesamt nicht mehr als MaxPixels, default 16.777.216 und bis 67.108.864 anhebbar
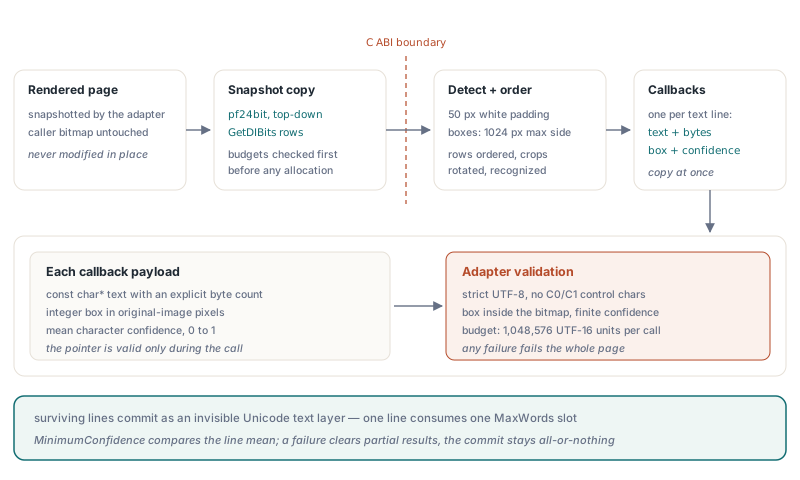
Innerhalb der DLL bekommt das Bild einen 50-Pixel-weißen Rand, Textregionen werden detektiert, wobei die längere Seite auf höchstens 1.024 Pixel skaliert wird, und die Boxen werden zu horizontalen Zeilen sortiert. Mit aktiviertem Winkelklassifikator wird ein Crop nur dann um 180 Grad gedreht, wenn der Kopf-über-Score 0,9 übersteigt, was schwache Vorhersagen davon abhält, kurze Wörter zu kippen. Jede Zeile kommt dann als const char*, eine Byteanzahl, eine Integer-Box in Pixeln des Originalbilds und die mittlere Zeichen-Confidence an. Der Adapter ist streng, was er akzeptiert:
- UTF-8 wird mit
MB_ERR_INVALID_CHARSdekodiert, eine missgebildete Bytesequenz lässt die Seite scheitern, statt Replacement-Zeichen in einer durchsuchbaren Ebene zu pflanzen - C0- und C1-Steuerzeichen werden abgewiesen; Zeilen aus reinem Whitespace werden übersprungen
- Die Box muss innerhalb der Bitmap liegen, und die Confidence muss ein endlicher Wert von 0 bis 1 sein
- Text zählt gegen das
MaxTextCodeUnitsder Anfrage, mit harter Obergrenze von 1.048.576 UTF-16-Einheiten pro Aufruf; Zeichen außerhalb der Basic Multilingual Plane kosten zwei Einheiten - Eine Pascal-Exception innerhalb des Callbacks wird dort gefangen, gespeichert und in eine 0-Rückgabe verwandelt, was die DLL stoppen lässt; die gespeicherte Nachricht wird zu
Info.Diagnostic
Zwei dieser Details zählen, wenn Sie die Ausgabe tunen. Die Einheit ist eine Zeile, kein Wort: Jede Zeile verbraucht einen MaxWords-Slot, Info.AcceptedWordCount und Info.DroppedWordCount zählen Zeilen, und ein Suchtreffer hebt die ganze Zeilenbox hervor. Und MinimumConfidence wird gegen die mittlere Zeichen-Confidence der Zeile verglichen, ein verschmiertes Zeichen unter zwanzig sauberen versenkt die Zeile also selten. Den Schwellwert auf 0,7 oder 0,8 zu heben, lässt ganze Zeilen fallen, nie einzelne Zeichen. Eine leere Seite gelingt mit null Zeilen, und jeder Ausfall verwirft Teilergebnisse, der Mehrseiten-Commit bleibt also Alles-oder-Nichts
Eine Engine, eine Modellkopie, ein Aufrufer zurzeit
Jede RapidOCR-DLL-Engine besitzt exakt eine Modellinstanz über ihre gesamte Lebensdauer, und Recognize-Aufrufe auf dieser Engine werden durch eine Critical Section serialisiert. Die IHPDFOCREngine-Referenz zu halten ist es, was die Modelle im Speicher hält, Batch-Arbeit sollte die Engine also einmal erzeugen und über jedes Dokument wiederverwenden
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // aufrechte Scans: kein Klassifikatormodell wird geladen
  Models.Threads := 4;                   // 1..64, begrenzt auf die aktiven Prozessoren
  Models.TimeoutMilliseconds := 120000;  // pro Recognize-Aufruf, kooperativ
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // letzte Referenz freigegeben: Modelle zerstört, dann wird die DLL entladen
Threads setzt sowohl die Intra-op- als auch die Inter-op-Threadanzahl jeder ONNX-Session in der Engine, und die DLL begrenzt sie auf die Anzahl aktiver Prozessoren. Zwei Threads, die sich eine Engine teilen, fahren nie parallel Inferenz; der zweite wartet. Dieses Warten ist kein blinder EnterCriticalSection-Aufruf. Der Adapter versucht den Lock mit TryEnterCriticalSection, schläft 25 ms zwischen den Versuchen und prüft jedes Mal das Abbruch-Token und die Frist, eine wartende Anfrage lässt sich also weiterhin abbrechen
Die Fristuhr startet, wenn Recognize betreten wird, bevor der Lock genommen wird. Zeit, die hinter einer anderen Seite in der Warteschlange verbringt, zählt gegen TimeoutMilliseconds. Mit vier Worker-Threads auf einer Engine und einer 60-Sekunden-Frist kann die vierte Seite abstehen, ohne je das Modell zu erreichen. Geben Sie jedem Worker stattdessen seine eigene Engine. Das kostet eine Modellkopie im Speicher pro Engine, und dieser Speicher kauft planbare Timeouts und echte Parallelität; eine Engine zu teilen ergibt nur Sinn, wenn Anfragen selten genug sind, dass sie fast nie in die Warteschlange geraten
Warum kann ein nativer OCR-Aufruf nicht mittendrin in der Inferenz gekillt werden?
Ein nativer RapidOCR-Aufruf lässt sich nicht mittendrin in der Inferenz killen, weil er auf Ihrem Thread läuft, innerhalb Ihres Prozesses, mitten in einer ONNX-Runtime-Session, die für einen laufenden Run keine Unterbrechungs-API hat. Abbruch im DLL-Adapter ist kooperativ. Die DLL ruft einen Abort-Callback vor und nach der Detection, nach der Klassifikation jedes Crops und nach jeder erkannten Zeile auf und stoppt am ersten Checkpoint, an dem der Callback 0 zurückgibt. Ein einzelner bereits begonnener Run wird zuerst fertig
Die forcierten Optionen sind schlechter als Warten. TerminateThread würde den CRT-Heap-Lock, den Thread-Pool der ONNX Runtime und jeden OpenCV-Zustand in dem Zustand zurücklassen, in dem sie sich gerade befinden. FreeLibrary aufzurufen, während ein Aufruf noch läuft, unmapped Code, der auf dem Stack liegt. Beides lässt sich nicht sicher machen, der Adapter versucht es also nie. Eine abgelaufene Frist kommt als otlsEngineError mit Timeout-Diagnose zurück; ein abgebrochenes Token als otlsCancelled:
// Das Token erzeugt der Aufrufer und teilt es mit dem UI-Thread,
// der Token.Cancel aufruft, wenn der Benutzer Stop drückt
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // angehalten an der nächsten Stufen- oder Zeilengrenze; Dokument unverändert
        Writeln('Cancelled');
      otlsEngineError:
        // eingeschlossen kooperativer Fristablauf und native Diagnosen
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // ein Seiten-, Pixel-, Wort- oder Inhaltslimit in Options wurde erreicht
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Das ist der echte Trade-off zwischen den Prozessadaptern und der In-Process-DLL, und keine Seite gewinnt jede Zeile:
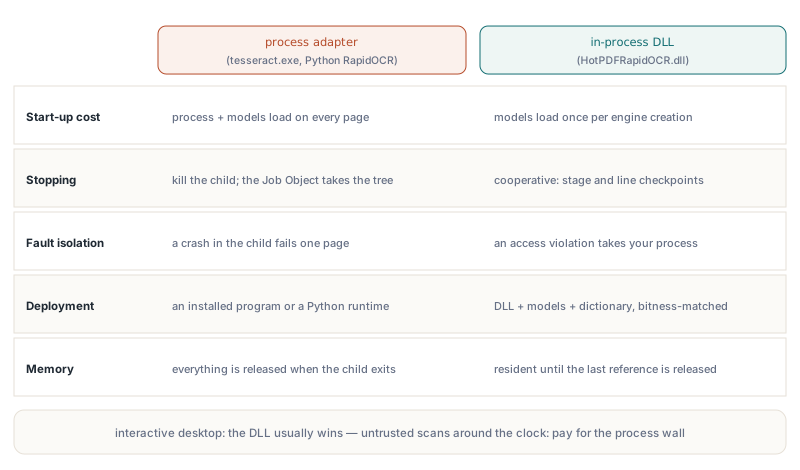
- Startkosten: Die Tesseract- und Python-RapidOCR-Adapter starten einen Prozess und laden Modelle für jede Seite; die DLL lädt die Modelle einmal pro Engine
- Stoppen: Ein Kindprozess lässt sich direkt terminieren, und der Python-Worker läuft in einem Kill-on-close-Job-Objekt, sodass sein ganzer Prozessbaum mitgeht; die DLL stoppt an Stufen- und Zeilen-Checkpoints
- Fehlerkontainment: Ein Crash in
tesseract.exeverliert eine Seite; eine Access Violation innerhalb der DLL reißt Ihren Prozess mit runter - Deployment: Prozessadapter brauchen ein installiertes Programm oder eine Python-Umgebung; die DLL braucht sich selbst, ihre Modelle und ihr Wörterbuch, passend zur Bitness der Anwendung
- Speicher: Ein Prozessadapter gibt alles frei, wenn das Kind endet; eine DLL-Engine hält ihre Modelle resident, bis die letzte Interface-Referenz verschwindet
Nehmen Sie die DLL für eine interaktive Desktop-Anwendung, die Seite für Seite OCR fährt und einen Stop-Knopf braucht, der innerhalb einer Inferenzstufe reagiert. Für einen Server, der rund um die Uhr nicht vertrauenswürdige Scans schluckt, zahlen Sie die Startkosten pro Seite und behalten die Prozessgrenze; ein zurechtgebogenes Bild, das einen Recognizer crashen lässt, soll eine Seite kosten, und mit einem Kindprozess tut es das
HotPDFRapidOCR.dll bauen und Modelle wählen
HotPDFRapidOCR.dll wird aus den C++-Quellen in Native/RapidOCR gebaut, mit MSVC, C++17, einem Windows SDK und CMake 3.20 oder später. Der Helfer tools/Build-HotPDFRapidOCR.ps1 nimmt die nativen Quell-, ONNX-Runtime- und OpenCV-Verzeichnisse plus -Platform Win32 oder Win64 und schreibt das Ergebnis nach Lib/Native/RapidOCR/<Platform>/. Bauen Sie beide, wenn Sie beide ausliefern. Eine 32-Bit-Delphi-Anwendung kann keine 64-Bit-DLL laden, und die bereitgestellten statischen Bibliotheken müssen sowohl zur Zielarchitektur als auch zum CRT-Modus passen
Modelle haben ihre eigenen Kompatibilitätsregeln. Der Detector ist ein DB-Text-Detector. Der Recognizer akzeptiert CTC-Modelle im NCHW-Layout mit fester Eingabehöhe 32 oder 48 und nutzt 48, wenn das Modell eine dynamische Höhe deklariert. Das Modellformat muss eines sein, das die statisch gelinkte ONNX Runtime versteht; neuere Exporte wie PP-OCRv5 können eine neuere Runtime brauchen, und ein unlesbares Modell scheitert an der Initialisierung mit einer Diagnose. tools/Install-RapidOCRModels.ps1 installiert PP-OCRv3- und PP-OCRv4-Pakete, verifiziert gegen festgenagelte SHA256-Hashes, mit geteiltem Detector und Klassifikator unter den Dateinamen, die Default erwartet. Bleiben Sie auf diesen Paketen, solange Sie nicht auch den Runtime-Build kontrollieren
Das Wörterbuch muss UTF-8 ohne BOM sein, in exakt der Zeichenreihenfolge des Modells, und seine Eintrageanzahl muss zu den Ausgabeklassen des Modells passen. CRLF-Zeilenenden sind fein. Bettet ein Modell seine eigene Zeichenliste in Metadaten ein, vergleicht die Modellinitialisierung jeden Eintrag und seine Position gegen die Wörterbuchdatei, ein Wörterbuch, das bloß die richtige Länge hat, scheitert also weiterhin. Die DLL lädt nie ein fehlendes Modell herunter
HotPDF bündelt den nativen RapidOCR-Adapter mit den prozessbasierten OCR-Adaptern, dem sie speisenden Seitenrenderer und dem Schreiber der unsichtbaren Unicode-Textebene, alles in einer nativen VCL-Komponente für Delphi und C++Builder. Für Capture- und Archivierungssoftware, die auf Maschinen ohne installiertes Python durchsuchbare PDFs produzieren muss, lässt die HotPDF Delphi PDF component nur die DLL und ihre Modelldateien zum Ausliefern übrig