Laufen Sie eine russische Rechnung durch einen Recognizer, der das kyrillische Modell lädt, aber weiter das chinesische Zeichwörterbuch liest, kommt eine Reihung tadellos gültiger Han-Zeichen heraus. Jede Zeile ist wohlgeformtes UTF-8, jede Zeile landet in der durchsuchbaren Textebene, und die Suche nach einem Wort, das klar auf der Seite steht, findet nichts. Das Modell hat seinen Job getan. Ein CTC-Recognizer gibt nie Zeichen aus, nur Klassennummern, und die Wörterbuchdatei ist das eine Ding, das Klasse 1.204 auf ein Glyph mappt
Drei verwandte Ausfälle liegen in der Nachbarschaft, und eine Demo in lateinischer Schrift zeigt keinen davon: Zeilen, die still ihr letztes Zeichen verlieren, englischer Text ohne Wortabstände und arabische Textboxen, die in Links-nach-rechts-Ordnung zurückkommen. Jeder Fall führt sich auf eine Wörterbuchregel, eine Schleifengrenze oder eine Sortierfolge zurück, die leicht fast richtig gerät. Alle vier beginnen am selben Punkt: dem Schritt, der einen Sprach-Tag in Modell und Wörterbuch übersetzt
RapidOCR-Sprachprofile in HotPDF: ein Tag, ein festgenageltes Paar
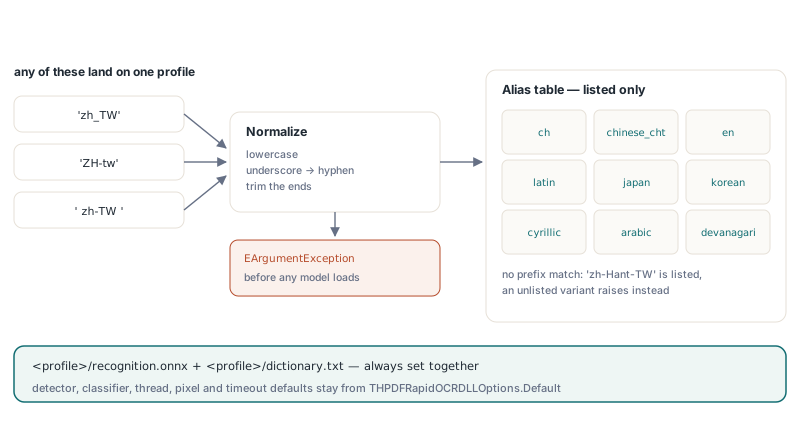
In HotPDF macht THPDFRapidOCRDLLOptions.ForLanguage aus einem Sprach-Tag Optionen, die auf <profile>/recognition.onnx und <profile>/dictionary.txt unter Ihrem Modellverzeichnis zeigen. Alles andere kommt aus THPDFRapidOCRDLLOptions.Default: der geteilte Detector, der optionale Winkelklassifikator, ein Thread, ein Budget von 16.777.216 Pixeln pro Anfrage und ein Timeout von 60 Sekunden. Der Tag wird kleingeschrieben, Unterstriche werden zu Bindestrichen, umgebender Whitespace wird getrimmt, 'zh_TW', 'ZH-tw' und ' zh-tw ' landen also alle auf demselben Profil
Das Matching läuft gegen eine explizite Aliasliste, ohne Präfix-Abgleich. 'zh-Hant-TW' und 'zh-MO' werden akzeptiert, weil sie gelistet sind; 'pt-AO' ist es nicht, und ForLanguage wirft EArgumentException, bevor irgendeine Datei geöffnet wird. Diese Strenge ist Absicht. Eine Präfix-Regel würde 'zh-Hant-SG' oder einen künftigen Tag still zu dem Profil schicken, das sich die ersten zwei Buchstaben teilt, und bei Chinesisch verraten die ersten zwei Buchstaben nicht die Schrift
| Profil | Sprachen | Beispiel-Tags | Boxreihenfolge in einer Zeile |
|---|---|---|---|
ch | Vereinfachtes Chinesisch und Englisch | zh, zh-CN, zh-Hans, chi_sim | Links nach rechts |
chinese_cht | Traditionelles Chinesisch | zh-TW, zh-HK, zh-Hant, chi_tra | Links nach rechts |
en | Englisch | en, en-US, en-GB, eng | Links nach rechts |
latin | Französisch, Deutsch, Spanisch, Portugiesisch, Italienisch, Niederländisch, Türkisch | fr, de, es-419, pt-BR, tr | Links nach rechts |
japan | Japanisch | ja, ja-JP, jpn | Links nach rechts |
korean | Koreanisch | ko, ko-KR, kor | Links nach rechts |
cyrillic | Russisch, Ukrainisch, Bulgarisch, Weißrussisch | ru, ru-RU, uk, bg | Links nach rechts |
arabic | Arabisch, Persisch, Urdu | ar, ar-SA, fa, ur | Rechts nach links |
devanagari | Hindi, Marathi, Nepali | hi, mr, ne | Links nach rechts |
Der Adapter lädt nie etwas herunter. Die Modelldateien werden einmal mit dem gebündelten Helfer bereitgestellt, etwa tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, oder mit -Language All für alle neun Profile. Der Helfer legt den geteilten Detector und Klassifikator unter den Root-Dateinamen ab, die Default erwartet, und jedes Profil in seinen eigenen Ordner. Engine-Erzeugung, die DLL-Grenze und Threading behandelt der Artikel zur In-Process-RapidOCR-DLL; mit den Dateien an ihrem Platz wird ein vereinfacht-chinesischer Scan so durchsuchbar
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, geteilter Detector und Klassifikator
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // Modelle laden hier; die Engine dokumentübergreifend wiederverwenden
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // leere Seitenliste = jede Seite; SkipPagesWithText lässt Textseiten in Ruhe
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Zwei Zahlen in dieser Ausgabe verlangen genaues Lesen. Die native Pipeline meldet ein Ergebnis pro erkannter Textzeile, AcceptedWordCount zählt hier also Zeilen, und MinimumConfidence wird gegen die mittlere Zeichen-Confidence der ganzen Zeile verglichen: Eine Zeile mit Durchschnitt 0,45 wird als Einheit verworfen. UniqueScalarCount ist die Anzahl unterschiedlicher Unicode-Skalare, die die Textebene in ihren Font und ihre ToUnicode-Tabelle mappen musste. Eine Seite chinesischen Fließtexts sollte diesen Wert weit über die paar Dutzend Skalare hinausdrücken, die eine lateinische Seite braucht; eine Zahl in lateinischen Gefilden bei einem chinesischen Scan bedeutet meist, dass das falsche Profil geladen ist
Warum produziert der Wechsel nur des Erkennungsmodells Datenmüll?
Weil Modell und Wörterbuch zwei Hälften einer einzigen Nachschlagetabelle sind, und nur das Wörterbuch weiß, was die Indizes bedeuten. Zeigen Sie RecognitionModel auf cyrillic/recognition.onnx, während CharacterDictionary noch die chinesische Datei nennt, gibt das Modell gültige kyrillische Indizes aus, die das alte Wörterbuch in zufällige Han-Zeichen übersetzt. ForLanguage setzt beide Felder stets zusammen. Handgebaute Optionen sollten derselben Regel folgen: nie das eine ohne das andere ändern
Die naheliegende Sicherung, die Wörterbuchgröße gegen die Modellausgabebreite zu vergleichen, ist nötig und reicht trotzdem nicht. Zwei Wörterbücher können dieselbe Anzahl Einträge in anderer Reihenfolge halten, und ein Off-by-one verschiebt jedes Zeichen um eine Position. Die HotPDF-RapidOCR-DLL prüft deshalb zweimal, während die Factory den Recognizer initialisiert. Die Ausgabeklassenanzahl des Modells muss den Wörterbucheinträgen plus zwei entsprechen. Danach wird, wenn die ONNX-Datei eine character-Metadatenliste einbettet, jede Wörterbuchzeile der Reihe nach damit verglichen. Jede Diskrepanz lässt HPDFCreateRapidOCRDLLOCREngine EInvalidOperation mit der nativen Diagnose werfen, der Fehler taucht also beim Start auf und nicht im Archiv eines Kunden
Das „plus zwei“ stammt aus dem Klassenlayout. Klasse 0 ist das CTC-Blank, die Klassen 1 bis N sind die Wörterbuchzeilen in Dateireihenfolge, und die letzte Klasse ist ein Leerzeichen. Manche Wörterbücher tragen zusätzlich einen eigenen Einzele-Leerzeichen-Eintrag, und diese Zeile muss exakt so bleiben, wie sie ist. Hier richtet ein wohlmeinendes Trim echten Schaden an: Es macht aus dem Leerzeichen-Eintrag einen leeren String und verschiebt oder bricht die Tabelle. Die DLL entfernt nur einen abschließenden Wagenrücklauf, damit CRLF-Dateien laden, und weist eine UTF-8-Byteordnungsmarke, eine leere Zeile oder einen Eintrag mit Tab oder streunendem Wagenrücklauf ab
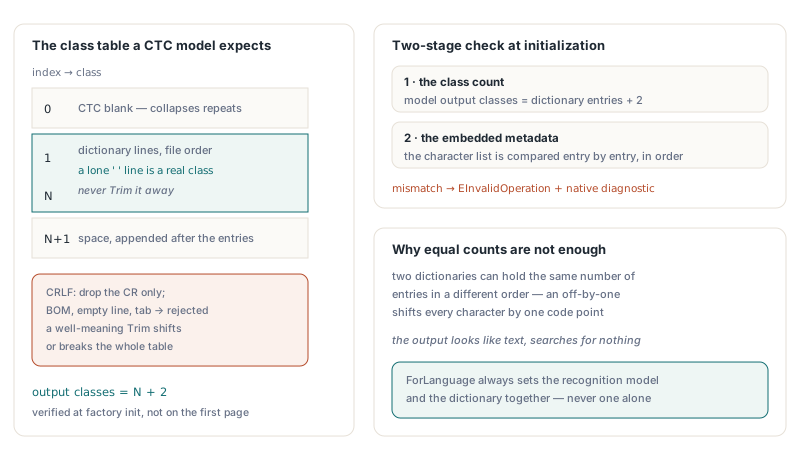
Wer eigene Wörterbücher pflegt, fängt diese Probleme mit einem Pre-Flight-Check im Build- oder Deployment-Skript ab, bevor die Engine sie sieht. Die Funktion unten ist Ihr eigener Code, geschrieben, um die Regeln oben abzubilden
// Eigener Helfer, keine HotPDF-API: baut die Klassentabelle auf, die ein CTC
// Recognizer erwartet, und weist die Wörterbuchdefekte ab, die auch die DLL ablehnt
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // Zeilenumbruch am Dateiende
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // Klasse 0: CTC-Blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: nur das CR wegnehmen
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // nie Trim: ' ' ist eine Klasse
  end;
  Result[Last + 2] := ' ';                       // letzte Klasse: Leerzeichen
  // Length(Result) muss der Ausgabeklassenanzahl des Modells entsprechen
end;
Greedy-CTC-Decoding und seine drei Grenzfallen
Greedy-CTC-Decoding wählt an jedem Zeitschritt die höchstbewertete Klasse, kollabiert aufeinanderfolgende Wiederholungen zu einem Zeichen und verwirft das Blank. Das Blank ist es, was ein echt verdoppeltes Zeichen überleben lässt. Ein Erkennungsmodell liest eine Textzeile als Folge schmaler vertikaler Scheiben und gibt für jede Scheibe eine Wahrscheinlichkeit pro Klasse aus. Eine Zeile mit AA中 könnte die Argmax-Folge A A blank A 中 space produzieren: Die ersten zwei A-Schritte kollabieren zu einem, das Blank trennt ihn vom nächsten A, und die Ausgabe ist AA中 mit intaktem nachgestelltem Leerzeichen. Ohne die Blank-Regel würden book und bok identisch dekodiert
Ein zu kurzer Dekoder lädt zu Off-by-one-Fehlern ein, und jeder Fehler produziert sein eigenes wiedererkennbares Symptom. Stoppen Sie die innere Argmax-Schleife eine Klasse zu früh, kann die Leerzeichen-Klasse nie gewinnen, und jede englische oder lateinische Zeile kommt als ein langes Wort zurück, die Phrasensuche arbeitet nicht mehr. Stoppen Sie die äußere Schleife einen Zeitschritt zu früh, verschwindet das letzte Zeichen jeder Zeile, bei einem zweizeichigen Etikett die Hälfte des Texts. Vergessen Sie, dass ein Blank den Wiederholungswächter zurücksetzt, kollabieren Doppelzeichen: Das ll in hello oder das reduplizierte 谢谢. Wer einen Dekoder für eine eigene Pipeline schreibt, hat mit diesen drei Fällen eine kompakte Testmenge. Der HotPDF-Dekoder deckt die letzte Klasse und den letzten Schritt ab, behält durch Blanks getrennte Wiederholungen und weist Scores ab, die nicht endlich sind oder außerhalb 0 bis 1 liegen, dazu jede Klassenanzahl, die nicht zum Wörterbuch passt
// Illustration für Ihre eigene Pipeline, keine HotPDF-API: Greedy-CTC
// Decoding mit korrekten Grenzen. Scores hält Steps * Classes
// Wahrscheinlichkeiten, eine Zeile pro Zeitschritt
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // Klasse 0 ist das CTC-Blank
  for Step := 0 to Steps - 1 do             // den letzten Zeitschritt einschließen
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // die letzte Klasse einschließen (Leerzeichen)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // ein Blank setzt den Wiederholungswächter zurück
  end;
end;
Beam Search mit einem Sprachmodell kann einige mehrdeutige Scheiben auflösen, die Greedy-Decoding falsch entscheidet, echter Aufwand in Geschwindigkeit und ein zweiter Satz Dateien, die versioniert wollen. Für gedruckte Dokumente bei 300 DPI ist Greedy-Decoding die richtige Voreinstellung, und der Dekoder ist der falsche Ort, um zu kompensieren, was das Modell nicht sehen kann. Dasselbe gilt für Zeichen-Substitutionstabellen. Liest ein Modell einen akzentuierten Buchstaben als seinen Grundbuchstaben, repariert eine Ersetzungstabelle eine Sprache und bricht eine andere. Ein falsches Zeichen in einer durchsuchbaren Ebene ist schlimmer als ein fehlendes, denn die Suche findet das falsche Dokument statt keines, deshalb geht der erkannte Text exakt so, wie das Modell ihn produziert hat, ins PDF
Wie werden Textzeilen für rechts-nach-links-Arabisch geordnet?
Die DLL sortiert erkannte Textboxen von oben nach unten, gruppiert Boxen zu einer Zeile, wenn sie vertikal um mindestens die halbe Höhe der kleineren Box überlappen, und ordnet jede Zeile von links nach rechts, oder von rechts nach links, wenn RightToLeft gesetzt ist. Die Zeichen innerhalb einer erkannten Zeile werden nie umgedreht. Die Zeilengruppierung zählt, denn Detector zerschneiden eine visuelle Zeile oft in mehrere Boxen, etwa ein Label und ein Wert, getrennt durch eine breite Lücke, und eine reine Top-Koordinaten-Sortierung würde sie mit der Nachbarzeile verschachteln, sobald sich ihre Tops um ein, zwei Pixel unterscheiden
Das arabische Profil ist das einzige, bei dem ForLanguage RightToLeft := True setzt, was die DLL jede Zeile an den rechten Kanten der Boxen ordnen lässt, beginnend am rechten Rand. Das ist die gesamte Wirkung. Der Text, den das Modell für eine Zeile zurückgibt, ist bereits in Unicode-Logischer Reihenfolge, der Reihenfolge, in der ein arabischer Leser liest und tippt, und das ist auch die Reihenfolge, die PDF-Textextraktion und Suche erwarten. Den String umzudrehen, damit er im Delphi-Debugger „richtig aussieht“, würde Suche, Kopieren und Einfügen sowie Screenreader brechen. Bidirektionale Anzeige und Glyphenformung sind Sache des PDF-Viewers
Eine Engine bedient ein Sprachprofil, und es gibt keine automatische Schriftenerkennung. Ein Dokument, das Schriften mischt, braucht eine Engine pro Profil, jedes angewandt auf seine eigenen Seiten. ApplyLoadedOCRTextLayer nimmt eine explizite Seitenliste und committet jeden Aufruf als eigene Transaktion, ein Fehler auf den arabischen Seiten rollt also diesen Aufruf zurück, ohne die bereits geschriebene chinesische Ebene anzutasten
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // wirft EArgumentException für einen nicht gelisteten Tag, bevor irgendein Modell lädt
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // Raum für A3-Seiten bei 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // chinese_cht-Profil
  Arabic := CreateRapidEngine('ar-SA');   // arabic-Profil, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
Die MaxPixels-Zeile steht da mit Grund. Das Default-Budget von 16.777.216 Pixeln pro Anfrage deckt A4 und US Letter bei 300 DPI mit Luft. Ein A3-Blatt bei 300 DPI kommt auf rund 3508 mal 4961 Pixel, gut 17,4 Millionen, die Anfrage wird also abgewiesen, und Info.Diagnostic meldet eine ungültige Anfrage oder ein Pixelbudget. Heben Sie MaxPixels bis zur Obergrenze von 67.108.864 an, oder senken Sie THPDFOCRTextLayerOptions.DPI für große Formate. Die Rechts-nach-links-Ordnung läuft über den DLL-Export HPDFRapidOCRSetReadingDirection, den der Adapter nur nachschlägt, wenn RightToLeft gesetzt ist; ein DLL-Build ohne diesen Export bedient weiterhin die Links-nach-rechts-Profile, und eine arabische Engine damit zu erzeugen, wirft EArgumentException mit dem Namen des fehlenden Exports
Festgenagelte Modellpakete und was ein eigenes Paar bestehen muss
Die HotPDF-RapidOCR-DLL linkt eine statisch gebaute ONNX Runtime und liest damit genau die ONNX-Dateiformatversionen, die diese Runtime versteht, nichts Neueres. Neuere Modell-Exporte können auf ein neueres Format zielen; so eine Datei wird bei der Engine-Erzeugung mit einer nativen Diagnose abgewiesen. Dieses Pairing ist der Grund, warum jedes Sprachpaket auf einen konkreten Recognizer und ein Wörterbuch zeigt, die unter der gebündelten Runtime laden und die Klassenprüfungen bestehen, und warum die Pakete nie „latest“ sind
Install-RapidOCRModels.ps1 erzwingt das Paaring auf der Platte. Jede Datei in seinem Manifest trägt einen SHA256-Hash. Eine existierende Datei mit anderem Hash stoppt die Installation und bleibt liegen, um sie zu verschieben oder zu löschen, und jeder Download wird unter einem temporären Namen geschrieben und rückt erst an seinen Platz, wenn sein Hash passt. Das blockiert die stille Variante des Wörterbuchproblems: Jemand kopiert von Hand ein neueres recognition.onnx in einen Profilordner, die Klassenanzahl passt zufällig, und das erste Trouble-Signal ist ein Kunde, der meldet, dass die Suche Wörter nicht findet, die er klar sehen kann. Installieren Sie mit -SkipClassifier, setzen Sie UseAngleClassifier := False in den Optionen, denn Default erwartet die Klassifikatordatei, und die Engine-Erzeugung prüft, dass sie existiert
Der Recognizer prüft außerdem die Eingabeform des Modells beim Laden. Er akzeptiert NCHW-Float-Eingabe mit fester Höhe von 32 oder 48 Pixeln oder eine dynamische Höhe, die er mit 48 fährt. Ein Modell mit jeder anderen festen Höhe scheitert an der Engine-Erzeugung mit „Unsupported recognition model input or output shape“
Für eine Schrift, die keines der neun Profile abdeckt, können RecognitionModel und CharacterDictionary auf eigene Dateien zeigen, und jede Prüfung oben gilt weiter. Ein unpassendes Paar scheitert an der Engine-Erzeugung, im Testlauf. Für Seiten, auf die kein RapidOCR-Profil passt, dockt der Tesseract-Adapter für durchsuchbare PDFs an denselben ApplyLoadedOCRTextLayer-Aufruf an, und für maschinengedruckte ASCII-Formulare braucht die eingebaute Template-Matching-OCR-Engine gar keine Modelldateien
Die Sprachprofile, der native RapidOCR-Adapter und die OCR-Textebene sind alle in der HotPDF Delphi PDF Component für Delphi-, C++Builder- und Windows-FPC/Lazarus-Projekte enthalten