Eine Pipe, die nie Dateiende meldet, ist ein seltsamer Bug, dem man in einem OCR-Feature nachjagt. Ein Thread in Ihrer Anwendung liest die Standardausgabe eines Hilfsprogramms und wartet darauf, dass ReadFile mit ERROR_BROKEN_PIPE failt. Ein anderer Thread startet tesseract.exe über CreateProcess mit bInheritHandles auf True, denn so reicht man einem Kindprozess eine Datei für dessen Standardfehler weiter. Das Pipe-Schreibende des Helfers war vererbbar, Tesseract besitzt also jetzt eine Kopie, und der lesende Thread hängt, bis Tesseract seine Seite fertig hat — was bei einem 300-DPI-Scan mit zwei geladenen Sprachmodellen nicht schnell geht
Ein externer Recognizer bringt mehr als das Hängen mit: was das Kind sehen kann, was man mit halbgültiger Ausgabe tut, und wie aus Pixelboxen durchsuchbarer PDF-Text wird. Die eingebaute Template-Matching-OCR-Engine deckt absichtlich maschinengedruckte ASCII-Buchstaben und Ziffern ab. Akzentuierte Namen, chinesische Verträge und gemischtsprachige Archive brauchen trainierte Sprachmodelle, und Tesseract ist der übliche Kandidat, weil es ein Kommandozeilenprogramm ist, das man neben die eigene Executable installieren kann
Tesseract in die HotPDF-OCR-Textebene einhängen
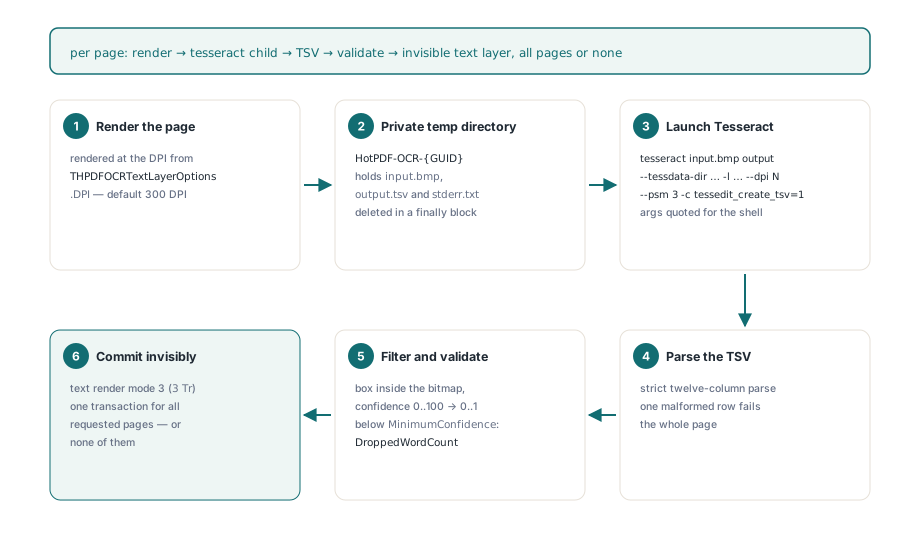
HotPDF wickelt eine lokal installierte Tesseract-Executable als IHPDFOCREngine über HPDFCreateTesseractOCREngine in der Unit HPDFTesseractRecognition ein. Sie geben diese Engine an THotPDF.ApplyLoadedOCRTextLayer weiter, das jede angeforderte Seite rendert, Tesseract einmal pro Seite fährt, die Wörter filtert und für jede angeforderte Seite eine unsichtbare Unicode-Textebene in einer Transaktion schreibt — oder für keine. Koordinaten-Mapping, Rotation, Confidence-Filterung und das Commit sind die Pipeline, die die eingebaute Engine bereits nutzt; nur die Erkennung ändert sich
Die Factory wirft EArgumentException, bevor eine Seite angefasst wird. Die Executable und das tessdata-Verzeichnis müssen existieren, das Timeout muss zwischen 1 und 3.600.000 Millisekunden liegen, und die Sprache darf nur ASCII-Buchstaben, Ziffern, _ und + enthalten, denn sie landet auf einer Kommandozeile: eng+chi_sim ist legitim, ein Wert mit Anführungszeichen oder Leerzeichen eine Injektion, die nur darauf wartet. Ein zweites Overload nimmt einen THPDFTesseractOptions-Record. Sein Default liefert --psm 3, --oem 3, 60 Sekunden pro Seite und eine Kappe von 16.777.216 Pixeln, und er weist tpsOSDOnly und tpsAutoOnly zurück, die beiden Modi ohne Wortausgabe
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16.777.216 px
  TessOptions.TimeoutMilliseconds := 120000;    // gilt je Seite
  // wirft EArgumentException bei fehlender Executable oder fehlendem tessdata-Ordner,
  // einem schlechten Sprachbezeichner oder Optionen außerhalb ihrer Bereiche
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // Modelle mit '+' verbunden
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // eine leere Seitenliste heißt alle Seiten; Seiten mit Text werden übersprungen
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Machen Sie die Pixel-Arithmetik einmal. Eine A4-Seite bei 300 DPI ist etwa 2.481 mal 3.508 Pixel, rund 8,7 Millionen, und passt. Eine A3-Seite bei derselben Auflösung ist etwa 3.508 mal 4.961, nahe 17,4 Millionen, sie failt also mit einer Pixelbudget-Diagnose, und der Lauf endet als otlsEngineError. Das Overload, das nur ein Timeout nimmt, setzt überhaupt keine Pixelkappe. Für einen Dienst, der Dateien von außen annimmt, bleiben Sie beim Options-Overload und erhöhen MaxPixels (bis 67.108.864) oder senken THPDFOCRTextLayerOptions.DPI bewusst, wenn große Formate zu erwarten sind
Pro Seite legt die Engine ein privates HotPDF-OCR-{GUID}-Verzeichnis unter dem Temp-Pfad an, speichert die Bitmap als input.bmp und fährt tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, mit --oem, wenn ein Engine-Modus gesetzt ist. Pfade werden nach den Windows-Regeln für Backslashes und eingebettete Anführungszeichen quotiert, und --dpi trägt die Render-Auflösung, Tesseract rät sie also nie. Tesseract und seine .traineddata-Dateien werden nicht mitgeliefert; sie bereitzustellen ist Sache der Anwendung. Auf unseren eigenen Linux-Testmaschinen läuft der Recognizer aus einem Bundle auf Benutzerebene aus Binary, seiner Shared-Library-Closure und dem tessdata-Ordner, denn ein Rückgriff auf /usr/bin/tesseract funktioniert nur dort, wo jemand das Systempaket installiert hat
Warum leert eine einzige kaputte TSV-Zeile die ganze Seite?
Der Tesseract-Adapter lässt die ganze Seite an der ersten kaputten Zeile scheitern, denn eine teilweise geparste Wortliste produziert eine Textebene, die mit dem Bild nicht übereinstimmt, und nichts im gespeicherten PDF sagt, welche Wörter fehlen. Die Ausgabe muss als strenges UTF-8 ohne eingebettete NULs dekodierbar sein. Die erste Zeile muss Tesseracts Zwölf-Spalten-Header entsprechen, level bis text, nach dem Absstreifen eines optionalen Byte-Order-Marks. Jede Zeile muss sich in exakt zwölf Felder teilen, und die Teilung stoppt nach dem elften Tab, ein Tab im erkannten Text landet also im Textfeld, statt eine dreizehnte Spalte zu erzeugen, die die Steuerzeichen-Prüfung unten ohnehin zurückweisen würde
Nur Level-5-Zeilen sind Wörter; Seiten-, Block-, Absatz- und Zeilenzeilen werden übersprungen, ebenso Wörter, die leer oder reiner Whitespace sind. Ein Wort, das ein Steuerzeichen enthält (unter U+0020, oder U+007F bis U+009F), lässt die Seite scheitern. Der Rest braucht Integer-Geometrie, eine mit invarianter Formatierung geparste Confidence, damit eine Anwendung im deutschen Locale auch 93.5 liest, eine Box vollständig innerhalb der Bitmap und eine Confidence von 0 bis 100. Ein gültiges Wort, gefolgt von einer kaputten Zeile, ergibt null Wörter
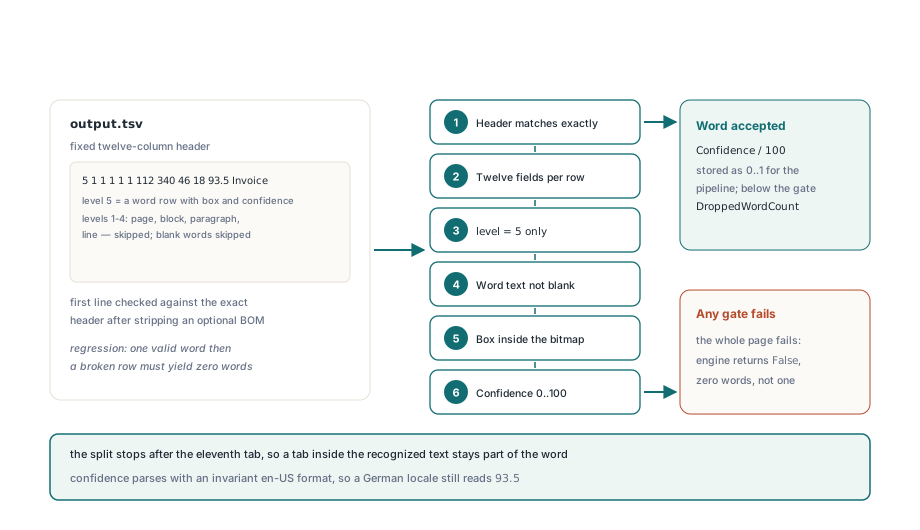
Eine einzige kaputte Zeile lässt den ganzen Lauf also scheitern und lässt jede Seite unangetastet. Das ist der richtige Trade. Ein erneuter Lauf ist billig; ein durchsuchbares PDF, in dem die Suche nach einer Rechnungsnummer genau die eine Seite verfehlt, die zählt, taucht erst Monate später auf — in den Händen von jemand anderem
Der letzte Schritt trifft zudem auf eine Voreinstellung, mit der man nicht rechnet. Tesseract meldet die Confidence von 0 bis 100, die Pipeline teilt durch 100, und THPDFOCRTextLayerOptions.MinimumConfidence liegt als Voreinstellung bei 0,5, jedes Wort unter 50 landet also in Info.DroppedWordCount statt auf der Seite. Auf einem sauberen Scan ist diese Schwelle vernünftig. Auf einem verrauschten Fax kann sie einen großen Teil des Texts entfernen; vergleichen Sie Info.ReceivedWordCount mit Info.AcceptedWordCount, bevor Sie sie senken
OCR erneut auf einer Datei fahren, die bereits Text hat
SkipPagesWithText steht als Voreinstellung auf True, und das erwischt Leute beim zweiten Mal. Angenommen, ein Batch wurde mit eng verarbeitet und braucht jetzt eng+deu: Jede Seite trägt bereits unsichtbaren Text, Info.SkippedPageCount entspricht also der Seitenanzahl. HotPDF markiert den Content-Stream, den es schreibt, als eigene OCR-Ebene, und ReplaceExistingOCRTextLayer nutzt diese Markierung, um diese Seiten erneut zu erkennen, die alte Ebene fallen zu lassen und den ursprünglichen Seiteninhalt zu behalten
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // unsere frühere Ebene ersetzen
Options.UseOptionalContentGroup := True;      // Ebene namens 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Eine Datei, die der Scanner-Treiber durch OCR gejagt hat, trägt keine solche Markierung, ihre Seiten gelten weiter als Seiten mit Text. SkipPagesWithText abzuschalten würde eine zweite unsichtbare Ebene über die erste stapeln, und jeder Suchtreffer erschiene doppelt. Lassen Sie diese Dateien in Ruhe
Was erbt der Tesseract-Kindprozess?
Der Tesseract-Kindprozess erbt von HotPDF exakt zwei Handles: eines, das auf NUL für Standard-Eingabe und -Ausgabe geöffnet ist, und eines für stderr.txt im privaten Verzeichnis. Das Pipe-Hängen von oben kommt aus CreateProcess selbst: bInheritHandles = True ist nötig, um Standard-Handles zu reichen, und allein reicht es jedes vererbbare Handle im Host weiter, auch Pipes, Dateien und Events, die fremder Code geöffnet hat. HotPDF nutzt STARTUPINFOEX mit einer Attributliste, die PROC_THREAD_ATTRIBUTE_HANDLE_LIST und das Flag EXTENDED_STARTUPINFO_PRESENT trägt. bInheritHandles bleibt True, aber nur die gelisteten Handles wechseln die Seite
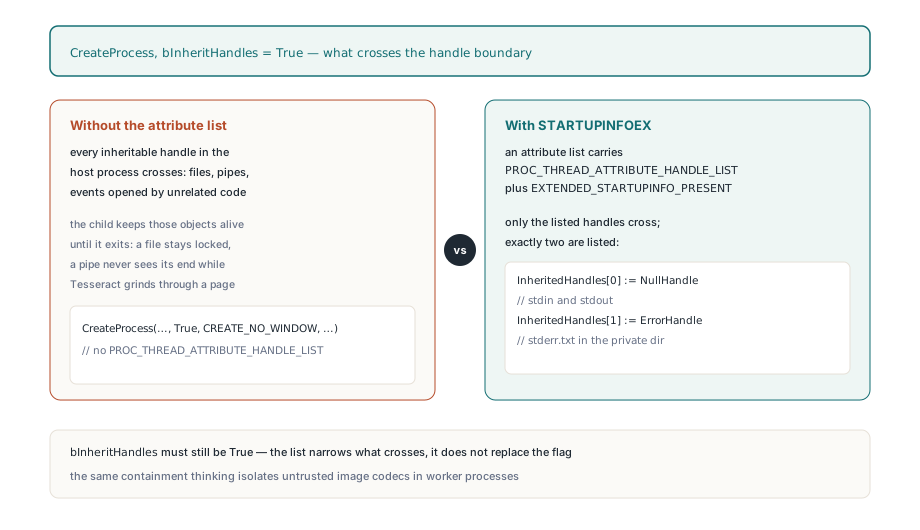
Dasselbe Muster gehört in jeden anderen Kindprozess, den Ihre Anwendung startet, denn ein einziger Launcher, der alles erbt, genügt, um jeden Pipe-Leser im Prozess hängen zu lassen:
// Muster für Ihre eigenen CreateProcess-Aufrufe (Fragment: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir und ProcessInfo sind anderswo deklariert).
// Ältere Delphi-RTLs deklarieren die Attributlisten-Funktionen nicht; ergänzen Sie
// eigene external-Deklarationen aus kernel32, wenn der Compiler sie nicht findet
// Prüfen Sie jedes BOOL-Ergebnis in Produktionscode
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // erzeugt mit bInheritHandle = True
  HandleList[1] := ErrorHandle;        // ebenso
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... dwFlags und hStdInput / hStdOutput / hStdError wie üblich setzen ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // auch mit Handle-Liste verlangt
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // nach dem Ende des Kindprozesses: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Bridge-Skripte ergänzen ein weiteres Windows-Detail. Ein Python-Launcher kann einen zweiten Interpreter-Prozess starten, und den Prozess, den Sie erzeugt haben, zu terminieren, lässt jenen laufen. Bekommt die Engine einen Skript-Pfad, wie der RapidOCR-Adapter unten, startet HotPDF das Kind suspended, weist es einem Job-Object mit JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE zu und setzt es dann fort; das Schließen des Jobs beendet also den ganzen Baum. Denselben Eindämmungsgedanken verfolgt die Isolation von PDF-Image-Codecs in Worker-Prozessen, wo das Kind nicht vertrauenswürdig ist; hier ist das Kind vertrauenswürdig, aber Ihr Prozess ist nicht der einzige Code, der Handles in ihm hält
Abbruch, Timeouts und das Alles-oder-Nichts-Commit
IHPDFOCREngine.Recognize liefert ein einzelnes Boolean, und False deckt sowohl „Tesseract gescheitert" als auch „der Nutzer hat Abbruch gedrückt" ab. Der Adapter pollt das Token und sein Timeout alle 25 Millisekunden, während Tesseract läuft, und räumt bei Abbruch auf und liefert False. Wörtlich genommen würde das als otlsEngineError gelesen, also prüft ApplyLoadedOCRTextLayer das Token zuerst, wann immer Recognize False liefert. Erkennung und Content-Aufbau schließen für jede angeforderte Seite ab, bevor die Dokumenttransaktion geöffnet wird, ein Abbruch auf Seite 40 von 50 meldet also otlsCancelled und lässt alle 50 Seiten geladen, wie sie waren. Die übrigen Grenzen folgen demselben Stil:
- Das Timeout läuft ab dem Start jedes
Recognize-Aufrufs, der 60.000-ms-Default ist also ein Limit pro Seite - Ein Kind, das bei Timeout oder Abbruch noch läuft, wird terminiert und bis zu 5 Sekunden abgewartet; das private Verzeichnis wird in einem
finally-Block entfernt, mit bis zu einer Sekunde wiederholtem Löschen, denn Ausgabedateien können kurz nach dem Prozessende noch gesperrt sein output.tsvist auf 64 MiB gekappt,stderr.txtauf 1 MiB, geprüft während das Kind läuft und nach seinem Ende- Wörter und UTF-16-Code-Einheiten pro Seite werden durch das Restbudget von
MaxWordsPerPage,MaxTotalWordsundMaxTextCodeUnitsbegrenzt; ein Überschreiten lässt den Lauf scheitern, statt die Liste zu stutzen - Ein Exit-Code ungleich null kommt mit bis zu 4.096 Zeichen aus
stderr.txtzurück, der schnellste Weg zu erfahren, dass eine.traineddata-Datei fehlt
Wie die unsichtbare Textebene innerhalb der Seite aussieht
HotPDF schreibt die Wörter mit Text-Rendering-Modus 3 (weder Füllung noch Strich, ISO 32000-1 §9.3.6), der Scan bleibt also sichtbar, während Suche und Kopie auf den Wörtern arbeiten. Der Content-Stream öffnet BT mit 3 Tr; jedes Wort bekommt eine Tm-Matrix an seiner Grundlinie, eine Fontgröße aus Boxhöhe in Pixeln mal 72 durch die Render-DPI, und eine Tz-Skalierung, die den Lauf auf die Boxbreite dehnt. Diese Dehnung hält ein Such-Highlight auf dem Wort im Bild
Das TSV hat Boxen, aber keine Baselines, also wird jede Grundlinie ein Fünftel der Boxhöhe über der Unterkante platziert. Zwischen benachbarten Wörtern auf einer Links-nach-rechts-Zeile in Leerzeichen-getrennten Schriften wie Latein oder Kyrillisch füllt ein gestrecktes Leerzeichen die Lücke, kopierter Text behält also seine Wortgrenzen; Chinesisch bekommt keine. Glyphen laufen über einen gemeinsamen nicht eingebetteten Type0-Font mit Identity-H-Encoding und einer generierten ToUnicode-CMap, ein CID pro unterschiedlichem Unicode-Skalar, so überleben Chinesisch, akzentuiertes Latein und Supplementary-Plane-Zeichen Kopie und Suche. Ein Lauf hält bis zu 65.535 verschiedene Skalare, und weil ISO 19005 eingebettete Fonts verlangt, braucht PDF/A-Ausgabe einen separat eingebetteten konformen Font. Um ein Ergebnis zu prüfen: speichern, neu laden und den gewöhnlichen Pfad aus Text aus einem geladenen PDF in Delphi extrahieren fahren; kommen die erwarteten Wörter auf den erwarteten Seiten zurück, ist die Ebene echt
RapidOCR und die native DLL auf demselben Vertrag
Für vereinfacht-chinesische Scans verwendet HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) denselben Prozess-Runner und TSV-Parser. Der Bridge-Skript-Pfad folgt der Python-Executable, und die Sprache ist auf chi_sim festgelegt. HotPDF liefert die Bridge als tools/OCR/rapidocr_tsv.py; sie braucht die Pakete rapidocr und onnxruntime, lokale ONNX-Modelle und eine Fontdatei, weist automatische Downloads zurück und schreibt TSV im Tesseract-Format; ein THPDFRapidOCROptions-Overload setzt Modelldateien, Thread-Zahlen und eine Pixelkappe. Die generische Factory hinter beiden Adaptern, HPDFCreateLocalTSVOCREngine in HPDFLocalTSVRecognition, nimmt jedes Programm an, das die Tesseract-artigen Argumente nimmt und die Zwölf-Spalten-TSV schreibt, und sie erbt Handle-Liste, Timeout, Abbruch und Budgets
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) lädt die Tesseract-C-API stattdessen in-process, meldet Tesseract (native DLL), prüft vorab, dass jede angeforderte .traineddata-Datei existiert, und mappt Abbruch und Timeout auf Tesseracts eigenen Progress-Monitor. Sie spart einen Prozessstart und einen BMP-Rundlauf pro Seite; die Executable hält die Crashes und das Speicherwachstum des Recognizers aus Ihrem Adressraum heraus. Für ein Desktop-Tool, das auf den Scans des Nutzers arbeitet, ist die DLL in Ordnung. Für einen Dienst, der Dokumente von Fremden aufnimmt, ist die Kommandozeilen-Engine die sicherere Wahl. In beiden Fällen läuft die Erkennung unter Windows, eine Seite nach der anderen, auf der gerenderten Bitmap — entzerren und säubern Sie schwierige Scans, bevor sie die Engine erreichen
Die OCR-Adapter, der Textebenen-Writer, der Renderer, der sie speist, und die Extraktion, die die Ausgabe prüft, leben in einer nativen VCL-Komponente für Delphi und C++Builder. Wenn Ihre Capture- oder Archivierungsanwendung durchsuchbare PDF-Ausgabe braucht, deckt die HotPDF Delphi PDF Component alles ab außer der OCR-Engine, die Sie selbst installieren