In einer TrueType-Schrift, die die standardmäßige Macintosh-Glyphenreihenfolge hält, kann das Wort „Total“ in einem PDF-Content-Stream als <0037005200570044004F> Tj stehen. Diese fünf Zweibyte-Werte sind Glyphennummern innerhalb der eingebetteten Schrift, und nichts am String sagt, dass sie T, o, t, a und l zeichnen. Liest man diese Bytes als UTF-16, erhält man den String 7RWDO, während die Seite selbst Total auf dem Bildschirm zeigt, denn eine Glyphe zu zeichnen braucht nur die Code-zu-Glyphe-Zuordnung, Text zurückzubekommen braucht eine Code-zu-Unicode-Zuordnung, die die Datei nie mitgebracht haben muss
Warum kommt beim Extrahieren Zeichensalat heraus?
Ein Content-Stream speichert Zeichencodes, und ihre Bedeutung liegt vollständig in der Schrift. Die Operatoren Tj und TJ (ISO 32000-1 §9.4.3) tragen Byte-Strings, interpretiert durch die Schrift, die das vorangehende Tf ausgewählt hat: Byte 0x41 ist unter WinAnsi der Buchstabe A, in einer Subset-Schrift eine beliebige Glyphe oder in einer zusammengesetzten CJK-Schrift die Hälfte einer Zweibyte-CID. ISO 32000-1 §9.10 behandelt Textextraktion als genau dieses Decodierungsproblem, das jeden Code anhand dessen, was das Schrift-Dictionary bereitstellt, auf Unicode zurückmappt, und sagt klar, dass eine konforme Datei nicht verpflichtet ist, genügend Informationen dafür mitzuliefern
Hinter dieser Klausel steckt jeder Fehlerbericht der Art „Kopieren und Einfügen aus diesem PDF liefert Müll“. Ein Erzeuger, der eine Subset-Schrift ohne /ToUnicode-Tabelle einbettet, hat eine gültige Datei geschrieben, die korrekt rendert. Die Glyphen sind alle da. Was fehlt, ist die umgekehrte Zuordnung, die ein Extraktor aus Sekundärbefunden rekonstruieren muss: der deklarierten Encoding der Schrift, den Glyphennamen, den von Adobe veröffentlichten Zeichensammlungen, der cmap-Tabelle im eingebetteten Font-Programm. Wie viele dieser Quellen eine API probiert und was sie herausgibt, wenn alle scheitern, unterscheidet in der Praxis Extraktionsbibliotheken
Extraktion im Lesefluss mit ExtractLoadedPageText
HotPDF Delphi Component liefert den Lesefluss-Text einer geladenen Seite über function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Seitenindizes sind nullbasiert, das Ergebnis ist ein nativer Delphi-UnicodeString, und die Funktion gibt False zurück, wenn die Seite keinen lesbaren Content-Stream hat, statt eine Exception auszulösen. Sie arbeitet mit jedem PDF, das Sie laden: der Rechnung, die ein Kunde gemailt hat, dem Bericht, den ein Scan-Dienstleister geliefert hat, dem Vertrag, den Software produziert hat, die heute niemand mehr benennen kann
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // liefert die Seitenzahl
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Für das ganze Dokument als ein String nimmt ExtractLoadedPagesText(PageRange, PageSeparator) einen 1-basierten Bereich wie '1,3-5,7-' entgegen (ein leerer String heißt alle Seiten) und setzt PageSeparator, standardmäßig einen Form Feed #12, zwischen die Seiten. Große Dokumente laufen besser über ExtractLoadedPagesTextToStream, das seitenweise UTF-8 in einen TStream schreibt und zurückgibt, wie viele Seiten es verarbeitet hat
Der Text hält, was die Seite zeigt. Glyphen, deren Box-Mittelpunkt außerhalb des sichtbaren Bereichs liegt (des Crop Box innerhalb des Media Box), bleiben außen vor, sodass Druckermarken einer beschnittenen Seite nicht in Ihren Index gelangen. Text in Form XObjects, die die Seite malt, wird einbezogen, geclippt auf die /BBox jedes Form. Ein Zeichen, das an derselben Stelle zweimal gemalt wird, der alte Trick, ein Fake Bold vorzutäuschen, wird einmal gelesen; Fake Bold und doppelte Glyphen in der Textextraktion führt durch, wie dieser Fall erkannt wird
Zeilenumbrüche folgen einer schlichten geometrischen Regel. Eine neue Zeile beginnt, wenn der Glyphen-Ursprung die Schreibrichtung um mehr als die halbe Texthöhe überschreitet, gemessen als die größere der Box-Höhen von Oberlänge bis Unterlänge dieser Glyphe und der vorherigen Glyphe in Seiteneinheiten. Die Glyphenbox statt des Tf-Größenoperands zu messen ist der entscheidende Teil: Viele Producer dimensionieren Text über die Textmatrix und übergeben an Tf eine 1, und eine Schwelle, die auf diesem Operanden basiert, würde bei jedem hochgestellten Index brechen und jedes Zeichen rotierten Texts auf eine eigene Zeile stellen. Wortabstände funktionieren nach derselben Logik. Trennt ein Producer Wörter, indem er die Textposition per TJ-Justierung oder Td verschiebt, statt ein Leerzeichen anzuzeigen, wird ein Leerzeichen eingefügt, sobald der Abstand nach der eigenen Breite der vorherigen Glyphe 0,15 der Glyphenhöhe überschreitet, und nie zwischen zwei chinesischen, japanischen oder koreanischen Zeichen. Codes, die der Decoder nicht auflösen kann, werden zu Leerzeichen, sodass Wortgrenzen überleben, selbst wenn einzelne Glyphen es nicht tun. Horizontaler Text kommt in Content-Stream-Reihenfolge heraus; vertikale CJK-Läufe werden zu Spalten neu gruppiert, gelesen von rechts nach links, von oben nach unten. Wortabstände und Zeilenumbrüche im Seitentext behandelt diese Schwellenwerte
Raster, Spalten oder Struktur-Reihenfolge
Wenn die Position Bedeutung trägt (Tabellen, Formulare, Code-Listings, alles, was Sie per Diff vergleichen, mit grep durchsuchen oder spaltenweise parsen wollen), ist ExtractLoadedPageTextLayout der bessere Aufruf. Er gruppiert Glyphen zu Grundlinien, sortiert jede Grundlinie nach X und bildet horizontalen und vertikalen Weißraum auf einem Zeichenraster in Festbreite nach, das aus dem Median der Glyphenvorschübe und der Schriftgröße der Seite dimensioniert wird. Breite Lücken auf einer Grundlinie werden zu Leerzeichen-Folgen, große Abstände zwischen Grundlinien zu Leerzeilen
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Spalten, Einrückung und Tabellenausrichtung überleben als
  // Leerzeichen und Leerzeilen auf einem Zeichenraster
end;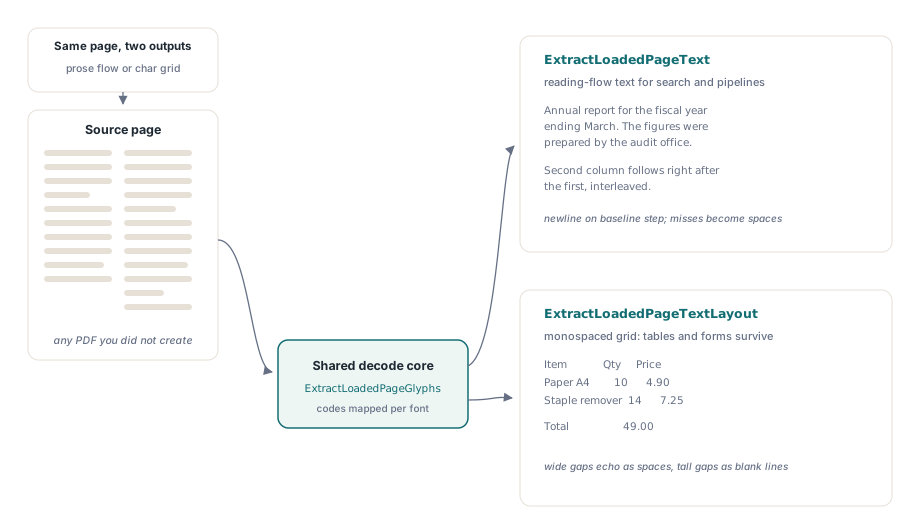
Beide Aufrufe decodieren über dieselbe Mechanik, die Wahl kostet also nichts an Genauigkeit. Was das Raster nicht tut, ist Fließtext umzubrechen: Ein zweispaltiger Artikel kommt als beide Spalten nebeneinander heraus, originalgetreu, richtig für einen Diff, falsch für einen Summarizer. Zwei weitere Aufrufe schließen diese Lücke. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) teilt jede Zeile, wo der Abstand zwischen benachbarten Glyphen das Vielfache des Median-Vorschubs übersteigt (standardmäßig 3.0), und trennt die Stücke mit einem Tabulator. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) läuft durch den Strukturbaum eines getaggten PDF (ISO 32000-1 §14.8.4) und liefert die Marked-Content-Läufe in Autorenreihenfolge; es gibt False zurück, wenn die Seite keinen brauchbaren Strukturbaum hat, und UntaggedGlyphCount verrät, wie viele Glyphen es nicht einordnen konnte
Für Text, den ein Mensch oder ein Sprachmodell lesen soll, probiert man zuerst die Struktur-Reihenfolge und fällt auf ExtractLoadedPageText zurück. Der Strukturbaum ist die eine Reihenfolge, die der Autor mit Absicht festgelegt hat, und jede geometrische Methode ist dagegen eine Schätzung. Das Raster behält man für die Jobs, bei denen Spalten Daten sind. Textextraktion in Struktur-Reihenfolge hat die Details, wie Marked Content dem Baum zugeordnet wird
Wie decodiert HotPDF Zeichencodes zu Unicode?
HotPDF Delphi Component löst jeden Zeichencode über eine nach Priorität geordnete Fallback-Kette auf, und eine Strategie, die nicht antworten kann, reicht den Code an die nächste weiter. Die /ToUnicode-CMap der Schrift (ISO 32000-1 §9.10.3) kommt zuerst, denn sie ist die eine Zuordnung, die der Erzeuger speziell für die Extraktion geschrieben hat. Danach kommen Glyphennamen aus einem /Encoding-/Differences-Array, gelesen über die Adobe Glyph List; dann die /Encoding-CMap selbst, als Stream eingebettet oder benannt, wobei ein Uni…-UTF16-Name bedeutet, dass der Code bereits UTF-16 ist. Zusammengesetzte Schriften laufen weiter durch die Adobe-Zeichensammlungen (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) von CID zu Unicode, dann durch /CIDToGIDMap in die cmap-Tabelle des eingebetteten Font-Programms, rückwärts gelesen von Glyphe zu Unicode. Einfache Schriften fallen auf die Tabellen WinAnsi, MacRoman, Standard und MacExpert zurück und schließlich auf dieselbe eingebettete cmap. Ein Code, der die Kette erschöpft, löst zu 0 auf
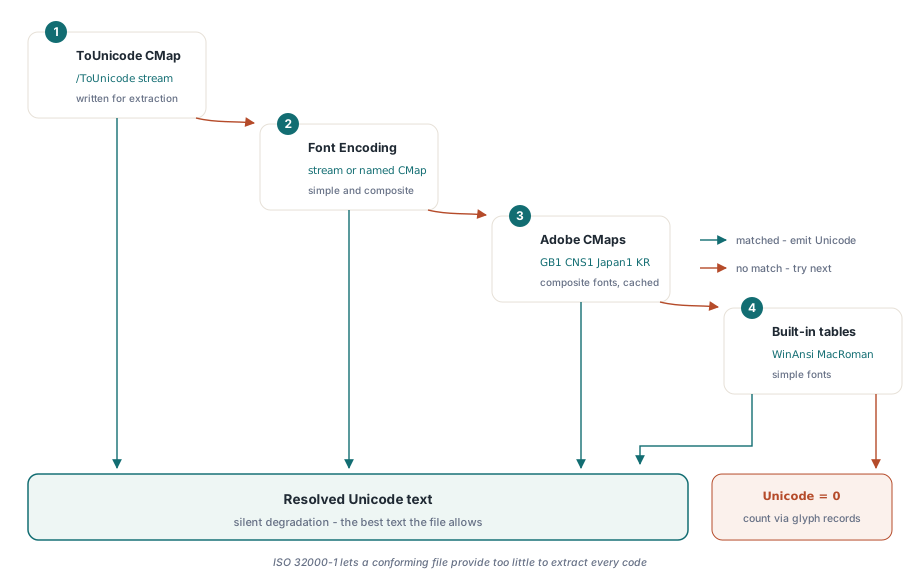
Der Embedded-CMap-Schritt ist es, der viele Subset-Schriften ohne /ToUnicode rettet: Das Font-Programm enthält meist noch seine eigene Unicode-cmap, und rückwärts gelesen bringt sie den größten Teil des Texts zurück. Es ist trotzdem eine Rekonstruktion. Zwei Unicode-Zeichen, die sich eine Glyphe teilen, kommen beide als diejenige zurück, die die cmap auflistet; behandeln Sie den wiederhergestellten Text also als gut für Suche und Indexierung und prüfen Sie ihn, bevor Sie ihn als juristischen Datensatz verwenden
Die Adobe-Sammlungsdaten liegen auf dem Datenträger. HotPDF liefert die CMap- und cid2code.txt-Dateien unter seinem Ordner resources\CMap mit, parst jede Datei höchstens einmal pro Prozess und cacht das Ergebnis; allein die Adobe-GB1-Map ist grob 2 MB Text, den man nicht pro Seite parsen will. Die vordefinierten CMaps existieren zusätzlich als eingebaute Tabellen, also decodiert eine Schrift mit benannter CMap wie UniGB-UTF16-H auch ohne den Ordner. Die CID-zu-Unicode-Tabellen für Identity-H-CJK-Schriften brauchen ihn dagegen. Die Eigenschaft CMapResourcePath benennt den Ordner mit den Sammlungsunterordnern; leer gelassen, sucht HotPDF nach resources\CMap neben der ausführbaren Datei und ein bis zwei Ebenen darüber
Pdf := THotPDF.Create(nil);
try
  // Ordner mit Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Setzen Sie den Pfad in jedem Dienst, ISAPI-Modul oder Plugin-DLL explizit. In diesen Hosts benennt ParamStr(0) den Host-Prozess, was selten der Ordner ist, in den Sie deployt haben, und ein fehlender Ordner wirft nichts; CJK-Seiten kommen einfach mit Lücken zurück, wo die Sammlungstabellen hätten auffüllen sollen. Text-Shaping für komplexe Schriftsysteme mit HotPDF trifft beim Schreiben auf dieselbe Code-gegen-Glyphe-Trennung
Zwei CMap-Syntaxfallen, die man kennen sollte
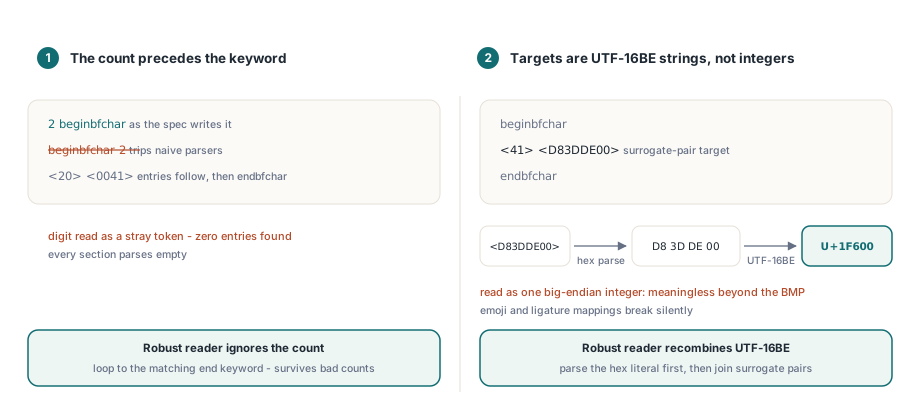
CMap-Dateien sehen trivial parsebar aus, und zwei Details bringen die meisten ersten Versuche zu Fall. Die Datensatzanzahl steht vor dem Abschnittsschlüsselwort: Ein Abschnitt lautet 2 beginbfchar, nie beginbfchar 2. Ein Parser, der die Anzahl nach dem Schlüsselwort erwartet, verschluckt die Zahl als verirrtes Token und findet dann in jedem Abschnitt null Einträge. HotPDFs Reader ignoriert die Anzahl komplett und iteriert bis zum passenden endbfchar oder endbfrange, was als Bonus reale Dateien toleriert, deren deklarierte Zählwerte schlicht falsch sind
Die zweite Falle: Die Ziele von bfchar und bfrange sind UTF-16BE-Strings. Das Ziel <D83DDE00> bedeutet U+1F600, ein Surrogatpaar, das zu einem Codepunkt wieder zusammengesetzt werden muss, und das Lesen dieser vier Bytes als Big-Endian-Ganzzahl liefert bei jedem Zeichen außerhalb der Basic Multilingual Plane einen bedeutungslosen Wert, Emoji inklusive. HotPDF parst das Hex-Literal zuerst zu rohen Bytes und setzt dann die UTF-16BE-Codeeinheiten wieder zusammen, was auch die mehrstelligen Ziele abdeckt, die Ligaturzuordnungen erzeugen, etwa ein fi-Glyph, der zu zwei Buchstaben mappt
Hinab auf Glyphenebene mit ExtractLoadedPageGlyphs
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) legt die Glyphen-Records unterhalb der Textaufrufe als THPDFGlyphArray offen. Jeder THPDFGlyphRecord trägt den rohen Code, seine CodeByteWidth (1, 2 oder 4, entschieden durch die codespacerange der CMap), den aufgelösten Unicode-Codepunkt plus eine UnicodeSequence für Ligaturen, den aktiven FontKey und FontSize, den X- und Y-Ursprung im Benutzerraum, den Advance, ein Glyphen-Quadrat mit vier Ecken und GlyphEndX / GlyphEndY, das Ende der eigenen Breite der Glyphe, von dem aus die Wortabstandsregel misst. Das reicht für positionierte Hervorhebung oder einen eigenen Layout-Algorithmus
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Das Zählen der Unicode = 0-Records ist der ehrliche Weg, ein Dokument zu beurteilen, bevor Sie seinem Text nachgelagert vertrauen. Rechnen Sie damit, dass die Zählung leicht von dem abweicht, was die Textaufrufe sehen. Dieser Aufruf liefert jede Glyphe im eigenen Content-Stream der Seite, auch solche außerhalb des Crop Box und Doppelte, die für Fake Bold gemalt wurden, und steigt nicht in Form XObjects hinab. Jeder Record speichert außerdem TokenIndex, ItemIndex und ByteOffset, die das Zeichen an seinen Quelloperanden zurückbinden; Suche und Ersetzung in einem vorhandenen PDF baut auf diesen drei Feldern auf
Manche Dateien haben keinen Text herzugeben. Eine gescannte Seite ist ein einziges großes Bild ohne Textoperatoren, die Extraktion liefert also korrekt einen leeren String, und der Weg weiter führt über OCR, beginnend mit dem Extrahieren der Seitenbilder aus dem geladenen PDF. Verschlüsselte Dokumente extrahieren normal, sobald sie mit LoadFromFile(FileName, Password) geöffnet wurden, denn die Streams sind entschlüsselt, bevor der Interpreter sie liest. Font- und Content-Streams werden über dieselbe Filterkette decodiert wie der Rest des geladenen Dokuments, und ein /ToUnicode-Stream, der sich nicht decodieren lässt, fällt zur nächsten Strategie zurück, während der Rest der Seite weiter extrahiert. Derselbe Objekt-Reader trägt auch das Bearbeiten von Metadaten in geladenen Dokumenten, eine Eingangs-Pipeline kann also in einem Durchgang Text lesen und Metadaten korrigieren
Lesefluss-, Raster-, Spalten- und Struktur-Reihenfolge-Extraktion samt Zugriff auf Glyphenebene gehören alle zur HotPDF Delphi Component für Delphi und C++Builder, als pures Object Pascal ohne externe DLLs oder Textdienste des Betriebssystems, sodass Sie bei einer seltsamen Datei in der Warteschlange in den Decoder hineinsteppen und sehen können, welche Strategie für welchen Code geantwortet hat