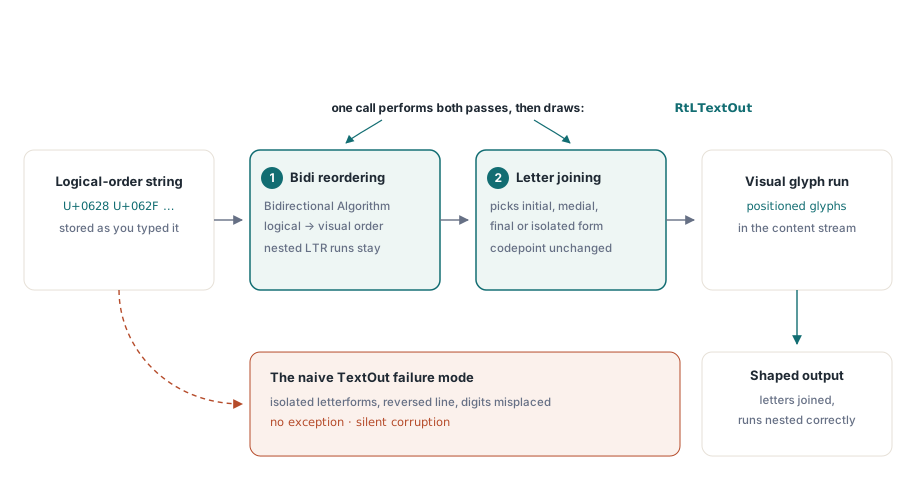
Übergeben Sie die arabische Wendung يوضح ملف PDF an TextOut und öffnen Sie das Ergebnis. Die Buchstaben laufen in die falsche Richtung, und jeder steht in seiner isolierten Form mit einer sichtbaren Lücke vor dem nächsten, als hätte jemand Englisch rückwärts getippt und zwischen jedem Zeichen die Leertaste gedrückt. Keine Ausnahme wurde ausgelöst. Keine Warnung ausgegeben. Die Ausgabe ist schlicht falsch, und sie ist falsch, weil zwei getrennte Umformungen, auf die Arabisch angewiesen ist, nie stattgefunden haben. Zu wissen, welche zwei Umformungen das sind und welcher Aufruf sie ausführt, ist fast alles, worauf PDF-Ausgabe für komplexe Schriften hinausläuft
HotPDF ist eine native VCL-PDF-Komponente für Delphi und C++Builder, und sie erledigt die Arbeit von rechts nach links über einen eigenen Aufruf. An ein paar bestimmten Stellen hört sie auch auf, und die sollten Sie kennen, bevor Sie sich auf eine Locale festlegen; dieser Text kartiert daher die Begriffe und die ehrlichen Grenzen, während die praktische Einrichtung des Aufrufs selbst im Referenzartikel zu RtLTextOut steht
Warum eine korrekte Zeichenkette dennoch falsch gedruckt wird
Unicode hält Text in logischer Reihenfolge, also in der Reihenfolge, in der Sie ihn tippen und laut lesen. Ein Renderer muss Glyphen in visueller Reihenfolge setzen. Bei Schriften von links nach rechts fallen beide Reihenfolgen zusammen, und niemand denkt darüber nach. Bei Arabisch und Hebräisch tun sie das nicht, und wenn eine einzelne Zeile Richtungen mischt, etwa ein arabischer Satz mit dem lateinischen Token „PDF“ oder ein in Ziffern geschriebener Preis, entscheidet der bidirektionale Algorithmus von Unicode (UAX #9) genau, wie sich die Abschnitte von links nach rechts in die Zeile von rechts nach links einbetten. Das ist die erste Umformung, die Umordnung, und sie zu überspringen kippt die Zeile
Die zweite ist die kontextabhängige Formung. Ein arabischer Buchstabe wird je nach Stellung im Wort anders gezeichnet: am Anfang, in der Mitte, am Ende oder allein stehend. Der Codepunkt bleibt dabei derselbe; nur die Glyphe wechselt. Eine Pipeline, die jeden Codepunkt direkt an seine Standardglyphe reicht, erzeugt genau die zusammenhanglose Ausgabe in isolierten Formen aus dem ersten Absatz. Hebräisch überspringt diesen Schritt, weil seine Buchstaben sich nicht verbinden, doch die Umordnung braucht es dennoch. Arabisch braucht beides, und darum ist Arabisch und nicht Hebräisch die Zeichenkette, mit der Sie testen
Auf dem Desktop ist all das nicht Ihr Problem. Wenn ein VCL-Formular Arabisch in ein TEdit zeichnet, ordnet und formt der Textstapel des Betriebssystems im Stillen, und genau deshalb kommt die Zeichenkette, die auf dem Bildschirm perfekt aussieht, in einem naiven PDF kaputt heraus. Ein Content-Stream speichert keinen editierbaren Text. Er speichert positionierte Glyphen, also erbt derjenige, der den Stream ausgibt, die Formungsarbeit, die früher das Betriebssystem übernahm. RtLTextOut ist der Aufruf, der diese Arbeit zurückholt
Was RtLTextOut für Sie formt
HotPDF hält den lateinischen Pfad und den Pfad für komplexe Schriften als zwei verschiedene Methoden. TextOut druckt, was Sie ihm geben, in der Reihenfolge, in der Sie es geben. RtLTextOut führt zuerst beide Umformungen aus — bidirektionale Umordnung über die ganze Zeile, kontextabhängige Analyse für die verbindenden Schriften — und druckt dann. Welche Schriftregeln gelten, kommt über den Zeichensatz der Schrift herein und nicht über den Aufruf selbst, sodass die Richtung an jeder Aufrufstelle eine ausdrückliche Wahl ist statt einer Vermutung aus den Zeichen. Die Einrichtung Parameter für Parameter, die Zeichensatzwerte, die Schritte zur Schriftregistrierung und ein vollständiges übersetzbares Beispiel stehen alle im Referenzartikel zu RtLTextOut; dieser Text bleibt dabei, was die Umformungen bedeuten, wo sie enden und wie Sie belegen, dass sie funktioniert haben
Eine Nutzungsregel zählt schon auf dieser Flughöhe: Die Eingabe muss in logischer Reihenfolge vorliegen, denn RtLTextOut nimmt die Umkehrung selbst vor, und eine bereits von Hand gedrehte Zeichenkette kommt doppelt gedreht heraus — der Referenzartikel geht diese Falle und ihre Beseitigung durch. Erwähnenswert ist sie hier, weil sie das Testen übersteht. Eine doppelt gedrehte, rein arabische Zeichenkette kann völlig richtig aussehen und fällt erst auseinander, wenn eine Zeile ein lateinisches Wort oder eine Zahl trägt, weil sich diese eingebetteten Abschnitte nicht mehr so einbetten, wie UAX #9 es vorschreibt. Der Fehler steckt nicht in der Darstellung, sondern darin, dem Algorithmus bereits halb verarbeiteten Text zu füttern
Dasselbe Verhalten bei gemischter Richtung bringt Prüfer öfter aus dem Tritt als den Code. Innerhalb einer Zeile von rechts nach links lesen sich Ziffern und eingebettete lateinische Wörter weiterhin von links nach rechts. Wer noch nicht mit bidirektionalem Satz gearbeitet hat, schaut auf eine gesetzte Rechnung, sieht die Kontonummer relativ zum umgebenden Arabisch in die „falsche“ Richtung laufen und meldet das als Fehler. Es ist das normgerechte Ergebnis. Eine kurze Notiz in Ihren Abnahmekriterien, geschrieben vor dem ersten Durchgang durch Muttersprachler, spart diese Schleife
Wann Umordnung und Verbindung genügen und wann nicht
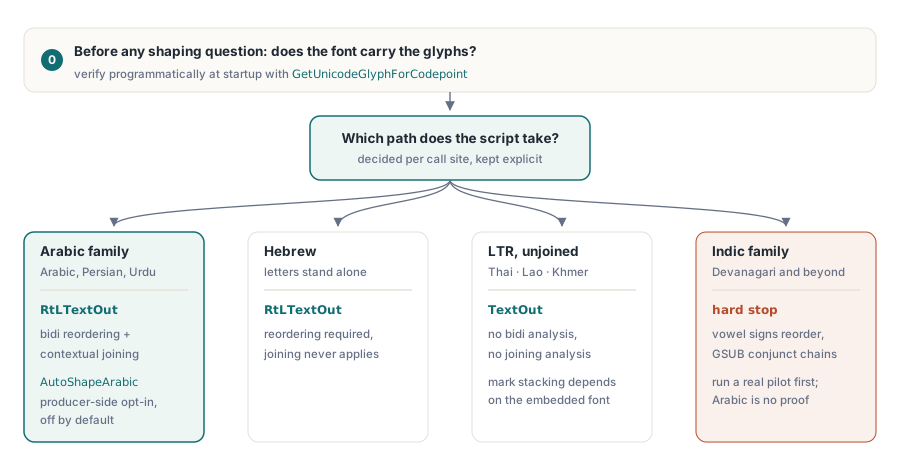
Für laufenden Text auf Arabisch und Hebräisch — Berichte, Rechnungen, Verträge, Briefe — sind Umordnung plus kontextabhängige Verbindung die ganze Arbeit, und RtLTextOut trägt sie allein. Die Grenze zeigt sich, wenn die Typografie mehr verlangt als Verbindung. Die Antwort von HotPDF auf der arabischen Seite ist ein zuschaltbarer Former auf der Erzeugerseite: Setzen Sie AutoShapeArabic := True, und die Komponente schreibt den Abschnitt in logischer Reihenfolge vor dem bidirektionalen Durchlauf in die Unicode-Präsentationsformen um, sodass Verbindungsformen gegen die logischen Nachbarn berechnet und Ligaturzusammenzüge in die Codepunkte eingebacken werden, die das PDF tatsächlich trägt, statt sie einem Viewer zu überlassen. Der Schalter steht standardmäßig auf aus, und solange er aus bleibt, ist die Ausgabe bytestabil; ihn einzuschalten ist also eine bewusste Entscheidung je Dokumentpipeline und kein globales Upgrade. Dasselbe Zuschaltmodell gilt für die übrigen verbindenden Rechts-nach-links-Schriften, die HotPDF formt: Syrisch, N'Ko, Adlam und Hanifi Rohingya haben jeweils ihr eigenes Auto-Shape-Flag, das dem arabischen entspricht
Optionale OpenType-Features sind wiederum ein anderer Mechanismus. Fakultative Ligaturen und ähnliche Einzelersetzungen laufen über GetSingleSubstituteGlyph(GID, 'liga'), das eine Ersetzung nach der anderen auflöst — zuerst die Eingabeglyphen-ID, dann das Feature-Kürzel — und die Eingabeglyphe unverändert zurückgibt, wenn das Feature nicht greift. Das genügt, um eine bekannte, endliche Ligaturliste zu treiben, die Sie selbst pflegen. Es ist keine vollständige GSUB-Engine, und genau an diesem Unterschied scheitern ehrgeizige Locale-Pläne: Eine Formungspipeline, die Arabisch makellos beherrscht, hat Umordnung und Verbindung nachgewiesen, mehr nicht
Abdeckung über die Schriften hinweg
Arabisch fordert beide Umformungen, weshalb es die Zeichenkette zum Testen ist und weshalb ein arabischer Durchgang der stärkste Einzelbeleg dafür ist, dass die Pipeline funktioniert. Hebräisch braucht die Umordnung, aber nicht die Verbindung, da seine Buchstaben allein stehen; wenn Hebräisch richtig erscheint und Arabisch zusammenhanglos, ist die bidirektionale Hälfte in Ordnung und die kontextabhängige lief nie. Persisch und Urdu reiten auf der arabischen Schrift und erben ihr Verhalten, wobei die Vorliebe des Urdu für den Nastaliq-Stil eine Schriftentscheidung mit Folgen für die Lesbarkeit ist, die ein Muttersprachler beurteilen sollte
Thai steht ganz auf der anderen Seite der Linie. Es läuft von links nach rechts, braucht also keine bidirektionale Arbeit, und seine Buchstaben verbinden sich nicht, braucht also keine kontextabhängige Analyse; Thai-Zeichenketten gehen wie lateinische den gewöhnlichen Weg über TextOut. Was Thai dagegen hat, sind gestapelte Zeichen — Vokale und Tonzeichen über und unter dem Grundkonsonanten — und ob die richtig sitzen, hängt daran, ob die Schrift ihre kombinierenden Zeichen so baut, dass sie ohne Hilfe einer Formungs-Engine stapeln. Die meisten eigens für Thai gebauten Schriften tun das. Testen Sie mit genau der Schrift, die Sie einbetten werden, nicht mit einer ähnlich aussehenden
Devanagari und der Rest der indischen Familie sind der ehrliche harte Stopp. Ihre Vokalzeichen ordnen sich um Konsonantengruppen um, und ihre Ligaturen entstehen über Ketten kontextabhängiger Ersetzungen, also volles GSUB-Gebiet, jenseits von Umordnung und Verbindung. Steht eine indische Locale auf der Landkarte, fahren Sie einen echten Pilotversuch mit echten Kundentexten, bevor Sie sie zusagen — dass Arabisch läuft, ist kein Beleg dafür, dass Devanagari laufen wird. CJK-Zeichenketten, Vietnamesisch mit seinen gestapelten Diakritika und gemischter europäischer Text nehmen alle den gewöhnlichen Weg ohne bidirektionale Analyse, und es zahlt sich aus, die beiden Wege im Berichtscode körperlich getrennt zu halten, eine Routine für RTL-Abschnitte und eine für alles andere, sodass die Locale-Logik an der Aufrufstelle sichtbar ist statt hinter einem Flag versteckt, das jemand zu setzen vergisst
Die Glyphenabdeckung entscheidet sich, bevor die Formung überhaupt läuft
Die Formung sucht Glyphen aus einer Schrift heraus. Trägt die Schrift sie nicht, gibt es nichts auszusuchen, und darum ist der klassische Fehlschlag bei der Auslieferung — makellos auf der Entwicklermaschine, leere Kästchen auf dem Server des Kunden nach einer stillen Schriftersetzung — ein Abdeckungsproblem und kein Formungsproblem. Die praktische Kur, eine mitgelieferte Schrift zu registrieren statt dem zu vertrauen, was auf einer Maschine installiert ist, geht der Referenzartikel Schritt für Schritt durch. Der begriffliche Punkt ist, dass die Abdeckung feststehen muss, bevor irgendeine Formungsfrage überhaupt sinnvoll ist, und dass sie sich programmatisch feststellen lässt statt durch Hinsehen auf die Ausgabe
// Nach RegisterUnicodeTTF die Abdeckung für die Codepunkte
// prüfen, die Ihre Daten tatsächlich verwenden
GID := Pdf.GetUnicodeGlyphForCodepoint($0628);  // U+0628 ARABIC LETTER BEH
LogGlyphAudit($0628, GID);
Die Registrierung selbst bringt zwei Bedingungen mit — eine Untergrenze von PDF 1.5 für die Behandlung eingebetteter Unicode-Schriften und die Einbettungsrechte der Schrift —, beide zusammen mit den Einrichtungsschritten im Referenzartikel zu RtLTextOut behandelt. Hierher gehört die Prüfgewohnheit: GetUnicodeGlyphForCodepoint ist Ihr Frühwarnsystem. Laufen Sie beim Start des Dienstes die Codepunktbereiche ab, die Ihre Daten tatsächlich verwenden, und protokollieren Sie, welche Glyphen-IDs zurückkommen. Eine Lücke in der Abdeckung erscheint dann während der Einführung als Zeile in einem Startprotokoll und nicht als fehlende Zeichen in einer Rechnung, die schon beim Kunden liegt
Die Leserichtung gehört dem Dokument, nicht den Glyphen
Jede Glyphe richtig zu setzen lässt immer noch eines offen. ISO 32000-1 §12.2 definiert eine Viewer-Einstellung namens /Direction, die die übergreifende Leserichtung des Dokuments angibt. Sie rührt keine Glyphe an. Sie sagt einem Viewer, wie er Doppelseiten anordnet, von welcher Seite ein Layout mit gegenüberliegenden Seiten beginnen soll und wohin sich die Lese-Oberfläche neigen soll. Nichts davon zeigt sich auf einer einzelnen Seite, und genau deshalb wird sie vergessen
// Leserichtung von rechts nach links auf Dokumentebene erklären
Pdf.Direction := RightToLeft;  // ergänzt vpDirection in ViewerPreferences
Direction zu setzen ist die ganze Arbeit: Der Setter der Eigenschaft ergänzt vpDirection in den ViewerPreferences des Dokuments, sodass eine Zeile die Einstellung in die Datei trägt. Geht der Text über RtLTextOut hinaus, bekommen Sie das gratis, denn der Aufruf kippt die Dokumentrichtung als Nebenwirkung — der Referenzartikel behandelt, wann ein gemischtes Dokument das rückgängig braucht. Selbst setzen müssen Sie es bei einem Dokument von rechts nach links, das auf irgendeinem anderen Weg entstanden ist, etwa aus Eingaben, die Sie weiter oben vorgeformt und über den gewöhnlichen Weg gezeichnet haben. Lassen Sie es dort weg, sieht der Einzelseitenbeleg, den Sie anstarren, so oder so gleich aus; dann druckt jemand eine beidseitige Broschüre, die Doppelseiten kommen gespiegelt heraus, und die Ursache ist eine fehlende Zeile von vor Wochen
Geformte Ausgabe prüfen
Prüfen Sie von Ende zu Ende, denn eine Seite kann richtig aussehen und für alles Nachgelagerte dennoch unbrauchbar sein. Drei Prüfungen finden die meisten Probleme. Kopieren Sie den Text aus Acrobat heraus und vergleichen Sie die Codepunkte mit Ihrer Ausgangszeichenkette. Lassen Sie die Suche des Viewers im Dokument ein Wort finden, das Sie auf der Seite sehen. Und öffnen Sie die Ausgabe auf einer Maschine ohne Ihre Entwicklungsschriften, also auf der, die eine Ersetzung am ehesten sichtbar macht. Nichts davon ersetzt einen Muttersprachler, der ein echtes Dokument ansieht, denn der findet Dinge, die kein künstliches Korpus zeigt. Setzen Sie diese Durchsicht in den Kalender, bevor das Format ausgeliefert wird
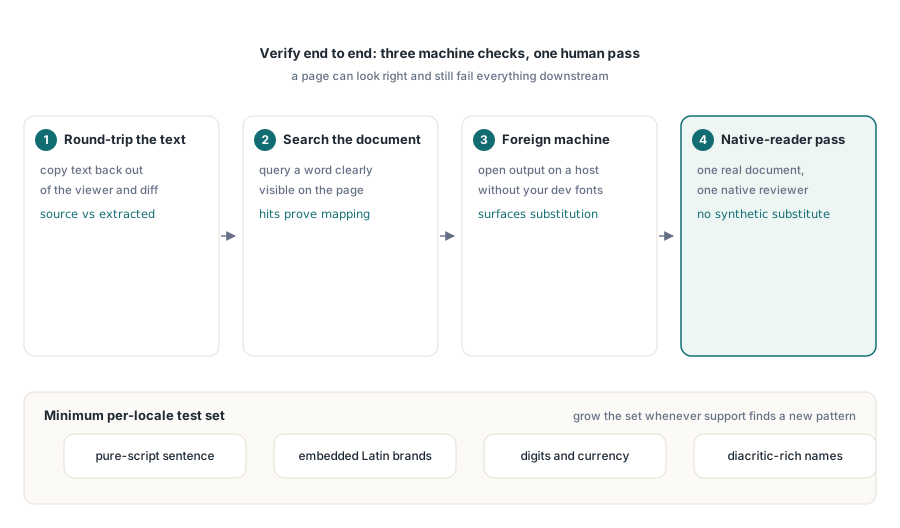
Wählen Sie Testzeichenketten mit Absicht, statt zu recyceln, was ein Übersetzer letztes Jahr geschickt hat. Ein brauchbares Minimum je Locale: ein Satz in reiner Schrift, ein Satz mit eingebetteten lateinischen Markennamen, eine Zeile mit Ziffern und Währung sowie Namen mit Diakritika oder kombinierenden Zeichen. Echte Kundennamen brechen Annahmen, die Blindtext unangetastet lässt, lassen Sie den Regressionssatz also jedes Mal um eine Zeichenkette wachsen, wenn ein Supportfall ein Muster zutage fördert, das Sie noch nicht gesehen hatten
Schriftregistrierung, Subsetting und die alltägliche API zum Textzeichnen behandelt der Artikel zu Berichtsausgabe, Schriften und Bildern mit HotPDF. Wenn dieselben Dokumente auch Profile für Barrierefreiheit erfüllen müssen, setzen die Regeln zu Sprachauszeichnung und Struktur aus dem Artikel zur PDF/A- und PDF/UA-Validierung auf der Formungsarbeit hier auf
Die oben beschriebenen APIs für Rechts-nach-links-Text und Unicode-Schriften kommen mit der HotPDF Delphi Component für Delphi und C++Builder; die Produktseite verlinkt die vollständige Referenz zur Textausgabe