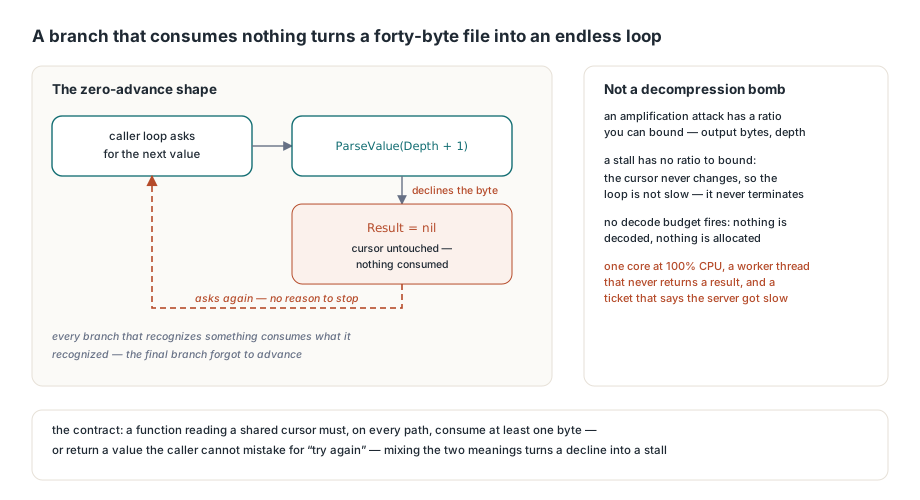
Ein Parser hängt an einer kaputten PDF, wenn irgendein Zweig ein Byte liest, es nicht behandelt und zurückkehrt, ohne den Cursor zu bewegen. Die Aufruferschleife sieht weder Fortschritt noch einen Grund anzuhalten und dreht sich endlos. Genau diesen Defekt lieferte HotPDF in drei unabhängigen Parsern aus, und alle waren über Eingaben unter fünfzig Bytes erreichbar
Das ist eine eigene Klasse von Denial-of-Service, die man benennen sollte, weil sie nicht wie die aussieht, vor der alle schon schützen. Kein Dekomprimieren, kein wachsender Speicherverbrauch, kein Druck auf den Speicher, der einen Watchdog auslösen könnte. Der Prozess sitzt nur auf einem Kern bei hundert Prozent CPU, mit ein paar Bytes im Puffer. Wenn Sie nach der Lektüre über verschachtelte Filterverstärkung und PDF-Bomben ein Decode-Budget eingebaut haben, greift es hier nicht: Es wird nichts dekodiert und nichts allokiert. Anderer Fehler, anderer Fix
Warum kostet eine Vierzig-Byte-Datei mehr als eine Dekompressionsbombe?
Weil die Kosten gar kein Verhältnis zur Eingabegröße haben. Ein Verstärkungsangriff hat eine Ratio, die man eingrenzen kann: Deckel auf die Ausgabebytes, Deckel auf die Rekursionstiefe, und der Worst Case wird endlich. Eine Zero-Advance-Schleife hat keine Ratio, die man eingrenzen könnte. Die Schleifenbedingung hängt an einem Cursor, der sich nie ändert, also ist sie nicht langsam, sondern nicht terminierend, und keine größenbasierte Grenze stromaufwärts fängt sie. Das macht sie betrieblich auch besonders übel. Ein Absturz liefert Ihnen einen Stack, Out-of-Memory eine Logzeile, und ein festgefahrener Parser einen Worker-Thread, der nie ein Ergebnis liefert, eine Anfrage, die nie ein Timeout bekommt, weil stromabwärts niemand weiß, dass sie gestartet ist, und ein Ticket, das sagt, der Server sei am Dienstag langsam geworden. Die strukturelle Ursache hat immer dieselbe Form. Ein Tokenizer oder Wertparser hat eine Kette von Zweigen, die am aktuellen Byte hängen. Jeder Zweig, der etwas erkennt, konsumiert das Erkannte. Dann gibt es einen letzten Zweig oder eine Wache vor der Kette, die für die Bytes zurückkehrt, die niemand beansprucht hat, und der Autor behandelt sie als Fehlerpfad statt als Scan-Schritt. Fehlerpfade kehren zurück. Scan-Schritte rücken vor. Wenn eine Funktion beides sein muss, wird der Fortschritt vergessen
Der Objektparser: zwei Delimiter, die niemand konsumierte
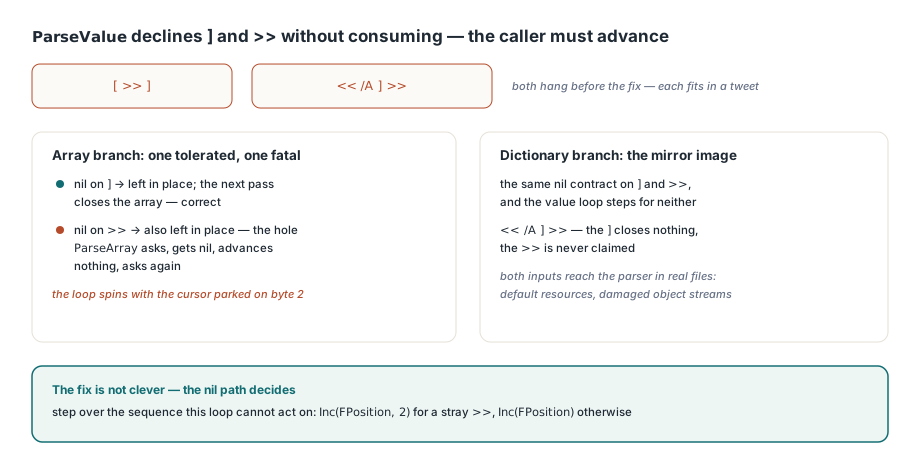
In HPDFParser beginnt THPDFSpanObjectParser.ParseValue damit, zwei Bytesequenzen kategorisch abzulehnen. Laut ISO 32000-1 Abschnitt 7.3 darf ein Wert nicht mit ] oder >> beginnen, denn die schließen einen Container, statt einen Wert zu öffnen, also gibt ParseValue für beide nil zurück, ohne sie zu konsumieren. Das ist der korrekte Vertrag, und er legt die gesamte Last des Vorankommens auf den Aufrufer. Der Array-Zweig erfüllte die Hälfte davon: Bei nil prüfte er auf ], ließ es für den nächsten Durchlauf an Ort und Stelle, um das Array zu schließen, und sprang über alles andere, nur war die Prüfung so geschrieben, dass ein verirrtes >> ebenfalls liegen blieb. Also hängt [ >> ], weil ParseArray nach einem Wert fragt, nil bekommt, nichts vorrückt und erneut fragt. Der Dictionary-Zweig hatte das spiegelbildliche Loch, und << /A ] >> hängt genauso. Beide Eingaben sind gültig genug, um den Parser zu erreichen, und kurz genug für einen Tweet
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Vor dem Fix kehrte keiner der beiden Aufrufe unten jemals zurück
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Der Fix ist nicht clever, und genau darum geht es: Der nil-Pfad muss explizit entscheiden, welche der beiden unkonsumierten Sequenzen die aktuelle Schleife verarbeiten kann, und über die andere hinwegspringen
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue gibt für ']' und '>>' nil zurück, ohne sie zu konsumieren.
  // ']' beendet das Array im nächsten Durchlauf, aber ein verirrtes '>>'
  // innerhalb eines Arrays muss übersprungen werden, sonst kommt der Parse nie voran
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Noch etwas verdient hier Aufmerksamkeit. THPDFSpanObjectParser.RecordError erhöht nur ErrorCount in THPDFParserViewStatistics; es begrenzt nichts. Der Parser setzt HPDFParserMaximumDepth auf 64, um die Verschachtelung zu begrenzen, hat aber keine vergleichbare Obergrenze für die Fehlerzahl, und ein Zähler, den niemand je liest, ist ein verpasster Circuit Breaker. Selbst mit wiederhergestelltem Vorrücken wird eine Eingabe, die pro Byte einen Fehler produziert, ein großes Objekt mit einer Rate durchkauen, die einen frühen Ausstieg verdient statt einer vollständigen Traversierung. Prüfen Sie nach jedem Parse Valid im Statistik-Record und behandeln Sie einen großen ErrorCount als Grund, dem Objekt nicht mehr zu trauen, nicht nur als Diagnose
Dieselbe Form im CMap-Tokenizer und im XFDF-Reader
HPDFCMapReader.NextToken trug den identischen Defekt in seinem Fallback-Zweig. Die Funktion gibt ein TCMapTok zurück und behandelt <, ( und / in eigenen Zweigen; alles andere fällt durch auf »lies bis Whitespace oder Delimiter«. Wenn das Startbyte selbst ein Delimiter aus der Menge von ISO 32000-1 Abschnitt 7.2.2 ist, läuft diese Schleife null Mal, das Token kommt leer zurück, und der Aufrufer fragt nach demselben Token erneut. Von den sechs Zeichen, die dort landen können, wurde nur [ vorher von der bfrange-Behandlung abgefangen, also reichte ein verirrtes ), >, ], { oder } irgendwo in einer ToUnicode-CMap, um die Textextraktion zu blockieren
// Schlüsselwort oder Zahl: lies bis Whitespace oder Delimiter
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Ein Delimiter, den keiner der Zweige oben beansprucht (ein verirrtes
// ')', '>', '[', ']', '{' oder '}'), würde P stehen lassen und ein
// leeres Schlüsselwort zurückgeben, sodass der Aufrufer endlos nach demselben Token fragte
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
Die XFDF-Seite hatte eine Variante mit anderer Herkunft und gleicher Wirkung. HPDFXFDFXml.ParseElement setzt Result := P ganz oben, während P noch auf das öffnende < zeigt, und erhöht erst danach seinen lokalen Cursor, sodass jeder folgende frühe Exit die Eintrittsposition zurückgibt, es sei denn, er überschreibt Result vorher. Eine Doctype-Deklaration nach XML 1.0 Abschnitt 2.8 oder irgendetwas anderes ohne parsebaren Tag-Namen wie <1a> nahm einen Exit, der Result nie aktualisierte, und die Kind-Element-Schleife bekam die Position zurück, die sie selbst übergeben hatte. Die Attributschleife hatte drei weitere dieser Fälle, denn ReadName, der Whitespace-Skip und die =-Behandlung lehnen alle ein Byte ab, das weder Namenszeichen noch Whitespace noch eines von =, >, / ist, und keiner von ihnen konsumierte es. Die benachbarte CDATA-Reparatur verschob eine Zuständigkeit, statt eine Wache einzubauen: Eine CDATA-Sektion nach XML 1.0 Abschnitt 2.7 beginnt mit <, also gab die Kind-Schleife sie früher an ParseElement ab, das dann einen Tag-Namen aus dem Sektionsinhalt las. Sie in der Kind-Schleife mit IsCDATAStart zu erkennen und Bytes bis IsCDATAEnd in den Textpuffer zu kopieren, ist die richtige Arbeitsteilung, und der alte Skip war auch ein Byte zu kurz, denn der Marker ist vom ! an gerechnet acht Bytes lang
Deklarierte Zählwerte, die die Daten überleben
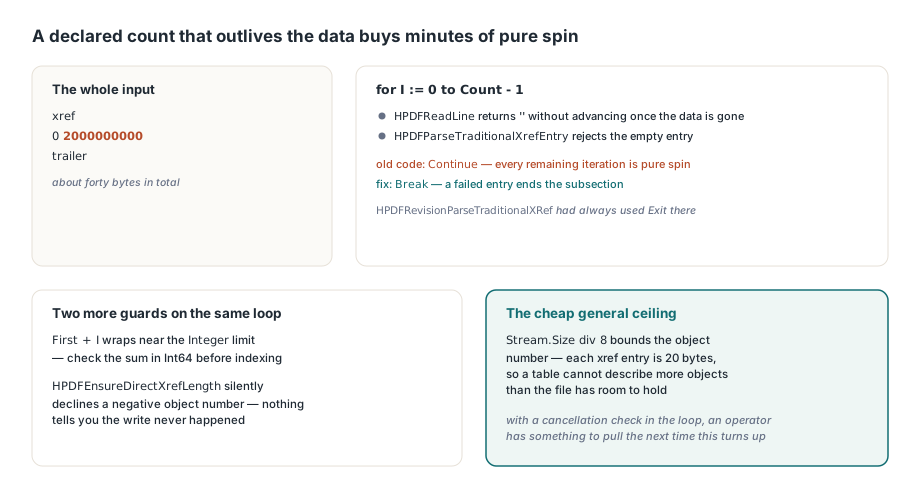
Ein späteres Release zeigte dasselbe Muster von der anderen Richtung, und das ist die Variante, die am ehesten auch in Ihrem eigenen Code steckt. Ein Cross-Reference-Subsection-Header nach ISO 32000-1 Abschnitt 7.5.4 ist ein first count-Paar, und beide HotPDF-Parser für traditionelle Xrefs schleiften for I := 0 to Count - 1 darüber und verwendeten Continue statt Break, wenn ein Eintrag nicht geparst werden konnte. Das liest sich wie Toleranz für eine kaputte Zeile. Ist es nicht: HPDFReadLine gibt eine leere Zeichenkette zurück, ohne vorzurücken, sobald die Daten erschöpft sind, und HPDFParseTraditionalXrefEntry lehnt einen leeren Eintrag sofort ab, also ist jede verbleibende Iteration des deklarierten Zählwerts reines Drehen. Die Arithmetik ist unbarmherzig, der Header xref\n0 2000000000\ntrailer plus ein minimaler Wrapper hat etwa vierzig Bytes, und er erkauft sich Dutzende Sekunden auf einem beschäftigten Kern, ohne dass irgendwo in der Schleife ein Abbruch geprüft wird. Der Hinweis lag in derselben Unit, denn HPDFRevisionParseTraditionalXRef hatte an dieser Stelle immer Exit verwendet. Wenn zwei Funktionen dieselbe Grammatik parsen und sich uneinig sind, ob ein fehlgeschlagener Eintrag die Subsection beendet, ist eine davon ein Fork, der die Fixes nicht mehr abbekam, dieselbe Signatur wie bei der Hybrid-Xref-Verarbeitung, wo eine traditionelle Tabelle und ein Stream dieselben Objekte beschreiben
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Ein deklarierter Zählwert größer als die Tabelle würde hier sonst
  // ohne verbleibende Daten drehen
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First kommt aus dem Subsection-Header, also läuft die Summe für
  // einen deklarierten Start nahe der Integer-Grenze über, und der
  // Wachstums-Helfer lehnt einen negativen Index stillschweigend ab
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... Eintrag aufzeichnen ...
end;
Die beiden Grenzen nach dem Break gehören zu derselben Reparatur. HPDFEnsureDirectXrefLength weigert sich, das Array für eine negative Objektnummer zu vergrößern, und sagt nichts dazu, und First + I läuft für einen deklarierten Start nahe der Integer-Grenze über, also erreicht ein negativer Index die Schreibzugriffe darunter. Die Objektnummern-Obergrenze von Stream.Size div 8 ist die billige generelle Antwort, denn keine traditionelle Cross-Reference-Tabelle kann mehr Objekte beschreiben, als die Datei Platz hat, und jeder Header, der etwas anderes behauptet, beschreibt eine Datei, die es nicht gibt. Wenn Sie eine beschädigte Tabelle von Hand reparieren, gilt dieselbe Überlegung von der anderen Seite, das ist das Gebiet der Notizen zum Diagnostizieren und Reparieren handbearbeiteter PDFs
Wie beweist man, dass ein Hang-Fix wirklich funktioniert?
Indem man den alten Code ausführt, nicht indem man ihn neu liest. Ein Stall ist eine der wenigen Defektklassen, bei denen sich ein Fix mit einem binären Signal und ohne Instrumentierung verifizieren lässt, denn der Prozess kehrt entweder zurück oder nicht, und über Kontrollfluss nachzudenken ist genau die Fähigkeit, die den Bug überhaupt erst produziert hat. Die Mechanik lohnt das Kopieren. Extrahieren Sie die Pre-Fix-Revision der geänderten Units in ein Scratch-Verzeichnis und kompilieren Sie dann eine kleine Probe, wobei der Unit-Suchpfad dieses Verzeichnis vor die echte Bibliothek setzt: dcc32 -U<scratchdir>;<Lib> probe.dpr. Der Compiler nimmt die alten Quellen für alles, was er zuerst findet, und die aktuellen Quellen für den Rest, also übt ein einziges Probe-Binary den alten Parser gegen den Rest der Bibliothek aus. Führen Sie es mit einem Timeout aus, vierzig Sekunden sind großzügig, und behandeln Sie Exit-Code 124 als Assertion. Dann ziehen Sie die Units einzeln aus dem Scratch-Verzeichnis zurück und bauen neu. Alle drei Stalls reproduzierten sich so, jeder einer bestimmten Unit zuzuschreiben, und alle drei verschwanden, sobald die korrigierten Quellen wieder im Pfad lagen, zum Preis von einem Compile pro Unit
Zwei Fallen lohnen das Wissen, bevor Sie es versuchen. Der Unit-Suchpfad ist stillschweigend nachsichtig: Geben Sie -U einen Unix-Stil-Pfad aus einer Shell wie $PWD, ignoriert der Compiler das Verzeichnis wortlos, und Ihre Probe kompilierte gegen die aktuellen Quellen und bestand aus dem falschen Grund. Konvertieren Sie den Pfad zuerst in native Windows-Form. Die zweite ist, dass das Scratch-Verzeichnis die Include-Dateien nicht mitführt, Sie also auch -I<Lib> für HotPDF.inc brauchen, sonst schlägt der Build auf eine Art fehl, die wie ein Quellproblem aussieht statt wie ein Pfadproblem. Und seien Sie ehrlich, was die Methode nicht liefert: Sie bestätigt, dass eine bestimmte Eingabe auf einem bestimmten Build nicht mehr hängt, und sagt nichts über die Eingaben, an die Sie nicht gedacht haben. Zero-Advance-Defekte findet man per Fuzzing oder indem man jeden Zweig jedes Tokenizers liest, nicht durch Regressionstests, die im Nachhinein geschrieben wurden
Was Sie in eigenen Parsern auditieren sollten
Die wiederverwendbare Regel ist ein Vertrag, kein Checklistenpunkt. Jede Funktion, die von einem gemeinsamen Cursor liest, muss auf jedem Pfad, einschließlich ihrer Fehlerpfade, entweder mindestens ein Byte konsumieren oder einen Wert zurückgeben, den der Aufrufer nicht für »versuch es nochmal« halten kann. Diese beiden Bedeutungen in ein einziges nil oder ein leeres Token zu mischen, ist das, was aus einer Ablehnung einen Stall macht. Auditen Sie also nach der Form statt nach dem Symptom. Finden Sie jede Schleife, deren Terminierung von einem Cursor abhängt, den eine andere Funktion besitzt, und fragen Sie, was passiert, wenn diese Funktion das aktuelle Byte ablehnt. Finden Sie jeden Fallback-Zweig, der als »lies bis X« geschrieben ist, und fragen Sie, was er tut, wenn der Cursor schon auf X sitzt. Finden Sie jede Schleife, die von einem Zählwert begrenzt wird, der aus der Datei kommt statt aus den Daten, und lassen Sie ein fehlgeschlagenes Element die Schleife beenden statt eine Iteration zu überspringen. Wo dieselbe Grammatik an zwei Stellen geparst wird, diffen Sie sie, denn eine davon wird einen Fix bekommen haben, den die andere nicht hat. Und bauen Sie in jede Schleife, die eine aufrufergelieferte Anzahl von Iterationen laufen kann, einen Abbruch-Check ein, damit ein Operator etwas zum Ziehen hat, wenn der nächste dieser Fälle in Produktion auftaucht
Die hier beschriebenen Parser sind im aktuellen HotPDF Delphi Component für Delphi und C++Builder enthalten, mit den Statistik-Records und Tiefengrenzen, die offengelegt sind, damit Ihre eigene Härtung darauf aufbauen kann