HotPDF kann ein geladenes Dokument in einer diagnostischen Form speichern, die für das Lesen und Bearbeiten durch einen Menschen gedacht ist, und die Datei anschließend reparieren, nachdem Sie sie bearbeitet haben. SaveLoadedDocumentDiagnostic schreibt das Dokument mit deterministischer Dictionary-Reihenfolge, jedes Objekt als normales indirektes Objekt, ohne Objektströme, ohne Cross-Reference-Stream und ohne Linearisierung. RepairDiagnosticDocument baut anschließend die Byte-Offsets, Stream-Längen, die Querverweistabelle und den Trailer neu auf, die Ihre Bearbeitung ungültig gemacht hat
Dieses Paar existiert für einen einzigen Arbeitsablauf: zu verstehen oder zu korrigieren, was tatsächlich in einem PDF steckt. Jeder Entwickler, der ein Rendering-Problem debuggt hat, wollte schon einmal die Datei öffnen, eine Zahl in einem Dictionary ändern und das Ergebnis betrachten. In einem normalen PDF ist das unmöglich, denn der Inhalt ist in Objektströme komprimiert, und jedes eingefügte Byte verschiebt Offsets, die eine Querverweistabelle exakt aufzeichnet
Was macht ein diagnostisches Speichern anders?
Sechs Einstellungen ändern sich gemeinsam. Dictionary-Schlüssel werden in deterministischer Reihenfolge geschrieben, sodass zwei Speicherungen desselben Dokuments vergleichbare Dateien erzeugen. Der diagnostische Ausgabemodus kommentiert die Struktur. Ein vollständiges Neuschreiben wird erzwungen, sodass nichts als unberührte inkrementelle Revision übernommen wird. Linearisierung ist ausgeschaltet, da eine linearisierte Datei für einen Web-Betrachter organisiert ist, nicht für einen Leser. Cross-Reference-Streams sind ausgeschaltet, sodass die Tabelle reiner Text ist. Und Objektströme sind ausgeschaltet, sodass kein Objekt in einem komprimierten Container versteckt ist
Das Ergebnis ist eine Datei, deren Header neben der üblichen %PDF--Signatur einen diagnostischen Marker trägt und deren Body Sie in jedem Editor durchblättern können. Objekte erscheinen nacheinander, Dictionaries sind lesbar, und Content-Streams liegen dort, wo Sie sie finden. Das Reparaturwerkzeug prüft auf diesen Marker und verweigert Dateien, denen er fehlt, denn die kompakte Struktur eines normalen PDFs sollte ein Byte-Bereichs-Reparaturwerkzeug gar nicht erst zu interpretieren versuchen

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Lesbar, ein Objekt pro Block, nichts in Objektströmen versteckt
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Warum bricht Bearbeitung die Datei, und was muss neu aufgebaut werden?
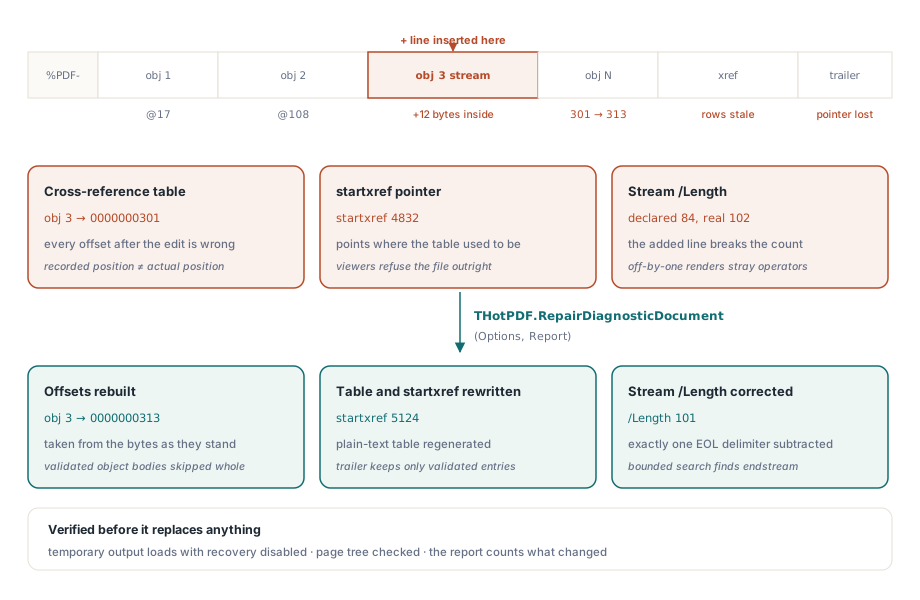
Drei Dinge in einem PDF kodieren Byte-Positionen oder Byte-Anzahlen. Die Querverweistabelle bildet jede Objektnummer auf einen Byte-Offset ab. Der startxref-Wert am Ende der Datei zeigt auf die Tabelle. Und jedes Stream-Dictionary trägt ein /Length, das angibt, wie viele Bytes der Stream-Body belegt
Ändern Sie irgendwo vor dem Dateiende ein einzelnes Zeichen, sind die Offsets danach falsch. Fügen Sie einem Content-Stream eine Zeile hinzu, ist auch dessen /Length falsch. Die meisten Betrachter verweigern die Datei, und diejenigen, die sie retten, tun dies durch Scannen, was den Fehler verbirgt, statt ihn zu beheben. Die Reparatur baut alle drei aus dem neu auf, was die Bytes jetzt tatsächlich aussagen
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // das Ergebnis vor dem Ersetzen laden

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Bytes kopieren, nicht neu serialisieren
Die Entwurfsentscheidung, die dieses Werkzeug vertrauenswürdig macht, ist, dass es das Dokument niemals lädt und wieder herausschreibt. Es kopiert die Byte-Bereiche der Objekte, die es validiert hat, ändert nur die /Length-Werte, die falsch sind, und baut die Tabelle, den Trailer und startxref darum herum neu auf
Laden und neu serialisieren wäre weit einfacher zu implementieren und würde still und leise Dinge verändern. Unbekannte Objektsyntax würde normalisiert, String-Escapes würden in der vom Writer bevorzugten Form neu geschrieben, und bereits kodierte Stream-Nutzdaten könnten neu kodiert werden. Für ein Debugging-Werkzeug ist das inakzeptabel: Sie haben eine Zahl bearbeitet, und der Diff sollte eine Zahl zeigen, nicht tausend beiläufige Formatierungsänderungen. Wenn Sie genau wissen wollen, was sich zwischen zwei Dateien geändert hat, ist das ein Vergleichsproblem, behandelt unter Vergleich zweier PDF-Dateien nach Struktur und Pixeln

Die zwei Parsing-Regeln, die falsche Objekte verhindern
Ein Byte-Bereichs-Scanner steht vor einer offensichtlichen Falle: Text, der wie ein Objekt-Header aussieht, kann innerhalb einer Stream-Nutzlast oder innerhalb eines Strings auftauchen. Ein naiver Scan würde eine Querverweiszeile erzeugen, die mitten in einen Content-Stream zeigt, und die entstehende Datei wäre auf eine neue, verwirrendere Weise kaputt
HotPDF vermeidet dies, indem es den gesamten Byte-Bereich jedes validierten Objekts anhand seines erfassten End-Offsets überspringt, sodass nichts innerhalb eines Objekt-Bodys jemals als Kandidat betrachtet wird. Zwischen Objekten sind nur PDF-Leerraum und Kommentare erlaubt; alles andere bedeutet, dass der Bereich nicht verstanden wird und seine Bytes nicht in die Ausgabe übernommen werden dürfen
Stream-Längen erfordern ebenso viel Sorgfalt. Die tatsächliche Nutzlastlänge schließt den Zeilenendetrenner aus, den ein Writer vor endstream einfügt. Landet die deklarierte Länge exakt auf dem Marker, wird diese Deklaration akzeptiert. Andernfalls führt die Reparatur eine begrenzte Suche nach dem Paar endstream und endobj durch und zieht genau einen Trenner ab, ein CR, ein LF oder ein CRLF. Ein Fehler von einem Byte hier erzeugt eine Datei, die sich öffnet und eine Seite mit einem verirrten Operator am Ende ihres Content-Streams rendert
Was der Trailer behalten darf
Der neu aufgebaute Trailer ist keine Kopie des alten. /Size, /Prev und /XRefStm beschreiben alle das vorherige Datei-Layout und werden neu berechnet oder verworfen. Nur Einträge, deren Ziele validiert wurden, überleben: /Info, /ID und /Encrypt. Und /Root muss sich zu genau einem Catalog-Objekt auflösen — nicht zu null und nicht zu mehreren, was eine Datei, die durch Kopieren und Einfügen von Objektblöcken zusammengesetzt wurde, gerne erzeugt
Die Ausgabesicherheit wird so gehandhabt, wie es sich für ein Werkzeug gehört, das mit Dateien arbeitet, an denen Menschen hängen. Das Ergebnis wird in eine temporäre Datei im Zielverzeichnis geschrieben und dann verifiziert, indem es über den normalen Pfad mit deaktivierter Querverweis-Wiederherstellung geladen wird, sodass eine Datei, die sich nur dank Wiederherstellung öffnen lässt, als Fehlschlag zählt. Erst wenn der Seitenbaum sich verifiziert, ersetzt die temporäre Datei atomar das Ziel. Eine fehlgeschlagene Reparatur überschreibt niemals eine bestehende Ausgabe
Budgets und ehrliche Fehlercodes
Drei Grenzen begrenzen die Arbeit: Eingabe-Bytes, Kandidatenobjektanzahl und maximale Objektnummer, standardmäßig 8 GiB, zwei Millionen und zwei Millionen. Die Obergrenze der Objektnummer ist wichtiger, als es aussieht, denn eine dünn besetzte Tabelle mit wenigen Objekten, die im Milliardenbereich nummeriert sind, würde die neu aufgebaute Querverweistabelle sonst enorm aufblähen. Klassische Querverweistabellen lehnen außerdem Offsets ab, die mehr als zehn Dezimalstellen benötigen würden, was eine Formatgrenze und keine Implementierungsentscheidung ist
Fehlschläge melden einen spezifischen Status statt eines Booleans: ungültige Argumente, Quelle zu groß, keine diagnostische Datei, Objektgrenze überschritten, ungültiges Objekt, doppeltes Objekt, fehlender Catalog, ungültiger Trailer, Ausgabefehler oder Validierung fehlgeschlagen. Jeder davon führt zu einer anderen Korrektur. Ein doppeltes Objekt bedeutet, dass Sie einen Objektblock zweimal eingefügt haben. Ein fehlender Catalog bedeutet meist, dass das Objekt mit /Type /Catalog beschädigt wurde. Validierung fehlgeschlagen bedeutet, dass die Struktur jetzt konsistent ist, der Seitenbaum aber nicht lädt, typischerweise ein /Kids-Array, das nicht im Gleichschritt mit seinem /Count bearbeitet wurde
Zwei praktische Hinweise schließen den Kreis. Bewahren Sie die diagnostische Datei auf, nicht nur die reparierte, damit die nächste Bearbeitung von einer lesbaren Basis ausgeht. Und liefern Sie diagnostische Ausgabe niemals an Endbenutzer aus: Sie ist größer als eine normale Speicherung, weil nichts in Objektströme komprimiert ist, und der Produktionsweg für eine kompakte Datei ist der gewöhnliche Speicherpfad, beschrieben unter Objektströme und inkrementelle Updates. Wenn das Ziel ist, herauszufinden, was falsch ist, statt es zu ändern, beantwortet der automatisierte Weg unter Preflight-Berichtsautomatisierung das schneller als das Lesen von Bytes
Diagnostisches Speichern, Reparatur, Preflight und Vergleich arbeiten alle auf demselben geladenen Dokumentmodell in Delphi und C++Builder; die vollständige Funktionsliste finden Sie auf der HotPDF-Delphi-PDF-Komponentenseite