Öffnen Sie ein PDF, das Microsoft Word oder Excel erzeugt hat, blättern Sie es durch, und nichts wirkt ungewöhnlich. Laden Sie es in ein Delphi-Programm, lesen Sie die Seitenzahl aus, und die Zahl stimmt. Speichern Sie es dann mit eingeschalteter Verschlüsselung neu, und der Auftrag scheitert mit einem EListError, oder die Ausgabe öffnet sich mit einer Warnung über eine beschädigte Querverweistabelle. Die Datei war nie defekt. Sie ist eine Hybrid-Referenz-Datei, und genau die Struktur, die einem fünfzehn Jahre alten Viewer das Öffnen erlaubt, ist die Struktur, die einen Loader besiegt, der zu früh aufhört zu lesen
Das ist einer der häufigsten Wege, auf denen eine PDF-Pipeline, die jeden internen Test bestanden hat, auf eine Datei trifft, die sie nicht verlustfrei durchreichen kann. Die Eingaben wurden alle intern erzeugt, also waren sie nie hybrid. Die erste Hybrid-Datei kommt an dem Tag, an dem ein Kunde eine aus einer Tabellenkalkulation exportierte Rechnung weiterleitet
Was Word und Excel tatsächlich schreiben
ISO 32000-1 beschreibt das Hybrid-Referenz-Layout in §7.5.8.4. Eine Anwendung, die PDF-1.5-Funktionen wie Objekt-Streams nutzen und trotzdem einem PDF-1.4-Reader das Öffnen der Datei erlauben möchte, schreibt die Querverweisinformationen zweimal. Es gibt eine klassische Querverweistabelle, die ASCII-Zeilen fester Breite, mit denen jedes PDF bis Version 1.4 endete, und es gibt einen Querverweis-Stream, der den Rest indiziert. Der Trailer des klassischen Abschnitts trägt einen /XRefStm-Eintrag, dessen Wert der Byte-Offset dieses Streams ist
Die Arbeitsteilung ist gewollt. Objekte, die ein alter Reader erreichen muss, darunter der Katalog und der Seitenbaum, sind über die klassische Tabelle adressierbar. Objekte, die in komprimierte Objekt-Streams gefaltet wurden, sind in der klassischen Tabelle als frei markiert, mit einem Eintrag vom Typ f, sodass ein 1.4-Reader direkt an ihnen vorbeigeht und nie über eine Struktur stolpert, die er nicht parsen kann. Ihre tatsächlichen Positionen stehen nur im Querverweis-Stream. Das Kennzeichen einer solchen Datei ist ihr Ende: ein kurzer klassischer Abschnitt, häufig nicht mehr als xref gefolgt von einem 0 0-Unterabschnittskopf, dessen Trailer auf den /XRefStm zeigt, wo die eigentlichen Wiederherstellungsdaten liegen
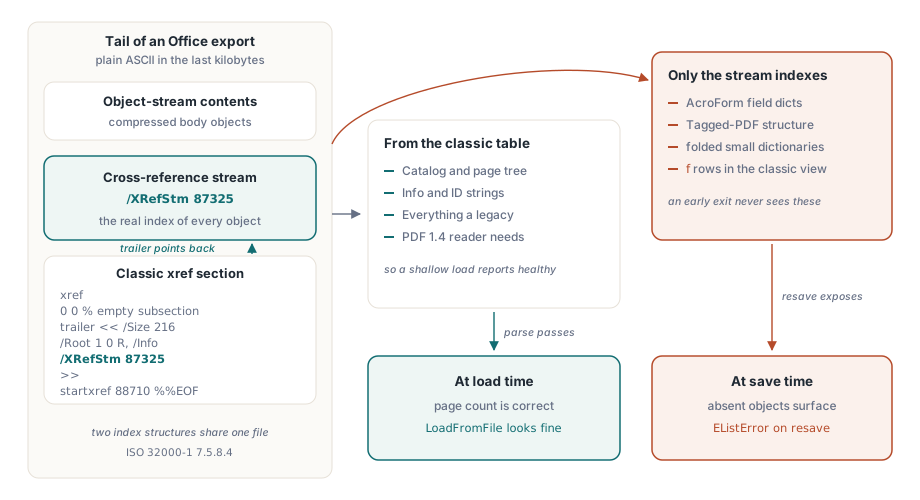
/XRefStm-Offset ist, während die Stream-Seite den echten Objektindex enthältWarum eine korrekte Seitenzahl nichts beweist
Weil Katalog und Seitenbaum absichtlich über die klassische Tabelle erreichbar sind, findet ein Loader, der nur diese Tabelle liest, /Root, durchläuft den Seitenbaum und meldet die richtige Seitenzahl. Alles, was ein alter Reader braucht, ist vorhanden, also wirkt die Datei gesund. Die Objekte, die fehlen, sind diejenigen, die in Objekt-Streams gepackt wurden: AcroForm-Feld-Dictionaries, Strukturelemente von getaggtem PDF, der lange Schwanz kleiner Dictionaries, die für einen Legacy-Viewer nie sichtbar sein mussten
Die Lücke fällt erst auf, wenn etwas diese Objekte berührt, und ein vollständiges Neuspeichern berührt sie alle. Das Dokument zu durchlaufen, um es neu zu verschlüsseln oder neu zu schreiben, ist genau die Operation, die der Reihe nach jede Objektnummer anfordert, weshalb das Symptom beim Speichern statt beim Laden auftaucht, weit entfernt von seiner Ursache
Die Falle ist ein Detektor, der xref sieht und aufhört
Der billige Weg, zu entscheiden, wie eine Datei indiziert ist, besteht darin, startxref zu folgen und die ersten Bytes zu prüfen, auf die es zeigt. Das Schlüsselwort xref bedeutet eine klassische Tabelle; ein Stream-Objekt bedeutet einen Querverweis-Stream. Dieser Test ist korrekt für jede Datei, die sich auf ein Schema festlegt. Er ist falsch für eine Hybrid-Datei, deren startxref einzig zur Zufriedenstellung alter Reader auf einen klassischen Abschnitt zielt, während der /XRefStm im Trailer dieses Abschnitts der Ort ist, an dem der Großteil des Dokuments tatsächlich indiziert ist. Ein Detektor, der beim ersten xref, dem er begegnet, „klassisch“ zurückgibt, liest /XRefStm nie, und jedes Objekt, das nur im Stream lebt, wird unsichtbar
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // Anzahl ist korrekt
    // das geladene Dokument hier prüfen oder bearbeiten
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // durchläuft jedes Objekt
  finally
    Pdf.Free;
  end;
end;
Mit dem vorzeitig abbrechenden Detektor sieht das Laden gut aus, und beim Neuspeichern melden sich die fehlenden Objekte. Die Lösung besteht nicht darin, am Anfang mehr Bytes zu lesen; sie besteht darin, den Hybrid-Trailer zu erkennen und /XRefStm zu folgen, bevor entschieden wird, dass die Datei fertig gelesen ist
Die Merge-Reihenfolge ist nicht verhandelbar
Sobald beide Indizes gelesen wurden, lassen sie sich nur in einer Richtung kombinieren. Der Querverweis-Stream muss zuerst zusammengeführt werden, und die klassischen Einträge werden um ihn herum ergänzt. Der Grund ist die kleine Täuschung im Kern des Formats. Eine Hybrid-Datei markiert ihre komprimierten Objekte in der klassischen Tabelle als frei, damit alte Reader sie ignorieren. Ein Loader, der eine First-seen-wins-Richtlinie befolgt und die klassische Tabelle zuerst liest, trägt diese Objektnummern als frei ein und verwirft dann die Stream-Einträge, die sie tatsächlich lokalisieren, weil die Slots bereits belegt sind. Kehrt man die Reihenfolge um, gewinnen die Typ-2-Einträge aus dem Stream, jeweils eine Objekt-Stream-Nummer plus ein Index, die Slots, die ihnen zustehen, und die klassischen Einträge ordnen sich um sie herum an
Dieselbe Disziplin schützt davor, dass eine ältere Revision ein gelöschtes Objekt wiederbelebt. Inkrementelle Updates verketten sich rückwärts über /Prev, und ein freier Eintrag vom Typ 0 ist ein Wächter dafür, dass ein neuerer Abschnitt eine Objektnummer außer Dienst gestellt hat. Ein späterer, älterer Abschnitt in der Kette darf diesen Wächter nicht mit einer veralteten Position überschreiben. Behandelt man First-seen bei Frei-Markierungen als maßgeblich, bleibt das gelöschte Objekt gelöscht; geht man nachlässig damit um, erweckt die eigene Historie einer Datei Inhalte wieder, die die neueste Revision entfernt hat
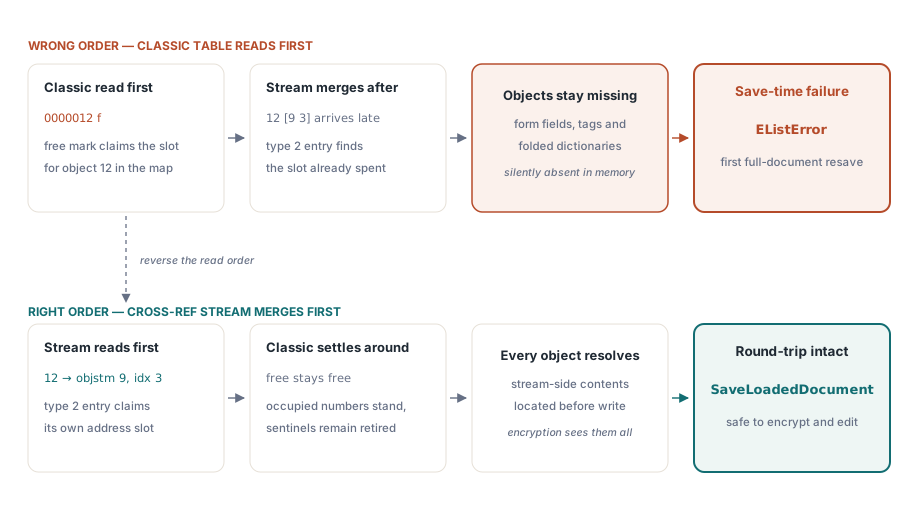
Was das in HotPDF bedeutet
Die Engine löst Hybrid-Referenz-Dateien für Sie auf, und zwar auf jedem Pfad, der die Querverweisdaten parsen muss. Laden Sie ein Dokument mit LoadFromFile oder LoadFromStream, nehmen Sie Ihre Änderungen vor und rufen Sie SaveLoadedDocument auf; oder führen Sie eine einmalige Operation wie EncryptFile aus, die eine Eingabe liest und eine Ausgabe schreibt. In beiden Fällen liest die Wiederherstellung /XRefStm, führt den Stream-Abschnitt vor den klassischen Einträgen zusammen und löst die in Streams lebenden Objekte auf, bevor das Schreiben sie aufzählt. Der AES-256-Verschlüsselungspfad ist der Ort, an dem sich das Problem zuerst zeigte, denn das Verschlüsseln eines Dokuments schreibt jedes Objekt neu und verlangt daher, dass jedes Objekt bereits lokalisiert wurde
// Einmalig: die Hybrid-Eingabe lesen, eine AES-256-verschlüsselte Kopie schreiben
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
Das Detail, das man mitnehmen sollte, liegt vor der API. Dateien, die aus Word, Excel, PowerPoint und einer langen Liste von „Als PDF speichern“-Pipelines kommen, sind routinemäßig hybrid, sodass ein Loader, den Sie nur gegen die Ausgabe Ihres eigenen Generators testen, im Test womöglich nie auf eine trifft. Bestücken Sie Ihre Testdaten mit Dokumenten, die aus echten Office-Anwendungen exportiert wurden, nicht nur mit Dateien, die Ihr eigener Code erzeugt hat
Eine verdächtige Datei prüfen
Zwei Prüfungen klären die Frage schnell. Öffnen Sie die Datei in einer Hex-Ansicht und lesen Sie die Bytes nach dem letzten startxref; eine Hybrid-Datei zeigt einen kurzen klassischen Abschnitt, dessen Trailer-Dictionary /XRefStm enthält. Oder vergleichen Sie die Objektanzahl, die ein vollständiges Parsen meldet, mit der höchsten Objektnummer, die /Size im Trailer deklariert. Eine große Lücke bedeutet, dass sich Objekte in Streams verstecken, die der Loader nicht geöffnet hat, und das ist dasselbe Defizit, das sich später in einen Fehler beim Speichern verwandelt
Das Ende eines typischen Excel-Exports macht die erste Prüfung konkret. Alles nach dem letzten xref-Schlüsselwort ist reines ASCII, sodass sich das Kennzeichen direkt aus einer Hex-Ansicht lesen lässt (Offsets beispielhaft, Anmerkungen ergänzt)
xref
0 0                          % leerer klassischer Unterabschnitt: gar keine Zeilen
trailer
<< /Size 216                 % eins über der höchsten verwendeten Objektnummer
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % Byte-Offset des Querverweis-Streams
>>
startxref
88710                        % zeigt auf den klassischen Abschnitt oben
%%EOF
Der 0 0-Unterabschnitt ist das verräterische Zeichen: Eine klassische Tabelle mit null Einträgen existiert nur, um den Trailer zu tragen, und der Trailer existiert hauptsächlich, um /XRefStm 87325 zu sagen. Ein Detektor, der beim Schlüsselwort xref aufhört, hat an diesem Punkt einen Index über nichts gesehen. Wenn Sie die Prüfung lieber skripten als mit bloßem Auge durchführen möchten: Der Marker sitzt immer innerhalb der letzten paar Kilobytes der Datei, sodass ein begrenztes Rückwärtslesen genügt
// Gibt den /XRefStm-Offset vom Dateiende zurück, oder -1, wenn der
// Marker fehlt (die Datei ist nicht hybrid oder gar kein PDF)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // der Trailer liegt am Dateiende
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // begrenztes Rückwärtslesen: max. 2 KB
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/XRefStm'), Tail);
  if P = 0 then
    Exit;                               // kein Hybrid-Marker am Dateiende
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // Leerraum nach dem Schlüssel überspringen
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Verwendung: ein nicht-negatives Ergebnis nennt das Byte, an dem der Stream beginnt
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Betrachten Sie die Sonde als Triage, nicht als Parser: Sie sagt Ihnen, welche Dateien in einem Stapel Aufmerksamkeit verdienen, bevor ein Neuspeicher-Auftrag läuft, und nicht mehr. Was ein Loader dann mit dem gefundenen Offset tun muss, der Abschnittskette folgen, die Stream-Einträge vor den klassischen zusammenführen, die Wächter für freie Einträge respektieren, wird Schritt für Schritt in unserem Begleitartikel zum Umgang mit Hybrid-Referenz-PDFs aus Office-Anwendungen durchgegangen
Die Schreibseite dieser Geschichte, wie Objekt-Streams und komprimierte Querverweise überhaupt erst erzeugt werden, wird in unserem Artikel über Objekt-Streams und inkrementelle Updates behandelt. Wenn die fragliche Hybrid-Datei zudem sehr groß ist, erlauben Ihnen die Ladetechniken in der Direct-File-API-Anleitung für große PDF-Workflows, sie zu untersuchen, ohne alles in den Speicher zu lesen. Beide passen natürlich zu der hier beschriebenen Wiederherstellung, die als Teil der HotPDF Delphi Component für Delphi und C++Builder ausgeliefert wird, neben den an anderer Stelle in diesem Blog behandelten APIs zum Laden, Bearbeiten, Verschlüsseln und Signieren