HotXLS Delphi Component porovnává dvě textové hodnoty jako Excel 16 od v2.384.67: bez rozlišení velikosti písmen, v pořadí „word sort“ uživatelského locale Windows, což je to, co vrací CompareStringW s příznakem NORM_IGNORECASE. Spojovníky a apostrofy první průchod vynechá a rozhodují jen remízy, takže ="a-b">"ab" je TRUE, zatímco jiné interpunkční znaky řadí před číslice a písmena, takže ="a~b"<"ab" je TRUE taky. Tím samým pořadím teď jedou srovnávací operátory, kritéria > / <, řazení oblastí i VLOOKUP
Nikdo nezakládá bug s názvem „nesoulad kolací“. Hlášení říkají, že COUNTIF(A:A,">M") na serveru počítá o dva řádky víc než v Excelu, že ceník seřazený reportovací službou dá X-100 někam, kam by ho Excel nedal, nebo že VLOOKUP("ABC",...) vrací #N/A, i když sloupec na první pohled obsahuje abc. Všechny tři vyvěrají z téže otázky: jsou-li oba operandy text, který je menší? Excel má přesnou odpověď, není to ta, kterou dává většina kódu v Delphi, a před v2.384.67 dával HotXLS tři různé odpovědi podle toho, která cesta v kódu se ptala
Jakým pravidlem Excel porovnává dva textové řetězce?
Excel porovnává text slovním řazením (word sort) uživatelského locale, bez ohledu na velikost písmen. Word sort je výchozí kolace srovnávacích funkcí Windows NLS: písmena se porovnávají podle svého lingvistického pořadí, ne podle kódových bodů, písmena s diakritikou sedí vedle svého základního písmene a dva znaky dostávají zvláštní zacházení. Spojovník - a apostrof ' první průchod ignoruje, takže co-op a coop přistanou vedle sebe a teprve když zbytek řetězců dá remízu, rozhodne jejich přítomnost o pořadí. Každý jiný interpunkční znak se počítá a řadí před číslice a číslice řadí před písmena
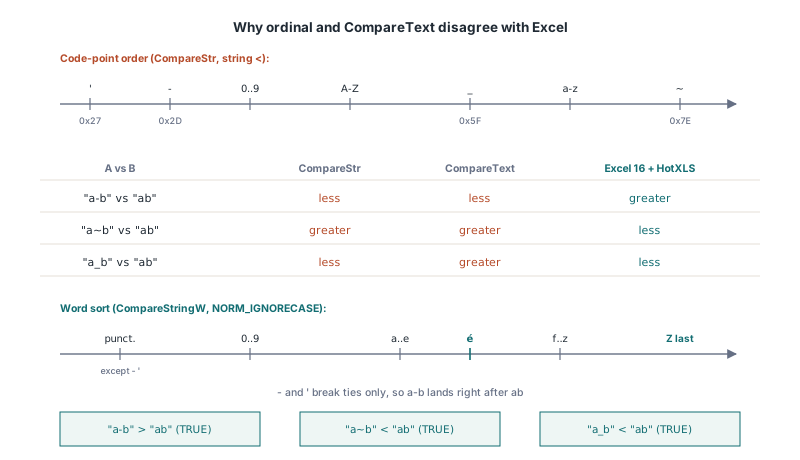
Tabulka ukazuje, co to znamená v praxi, vedle dvou srovnání, po kterých nejčastěji sáhne vývojář v Delphi. Sloupec Excel drží verdikty, které vrátil Excel 16 pro IF(A<B,...), a HotXLS je od v2.384.67 reprodukuje
| A vs B | Excel 16 / HotXLS | CompareStr (ordinální) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | větší | menší | menší |
"a'b" vs "ab" | větší | menší | menší |
"a~b" vs "ab" | menší | větší | větší |
"a_b" vs "ab" | menší | menší | větší |
"ab" vs "AB" | stejné | větší | stejné |
"é" vs "f" | menší | větší | větší |
"Z" vs "f" | větší | menší | větší |
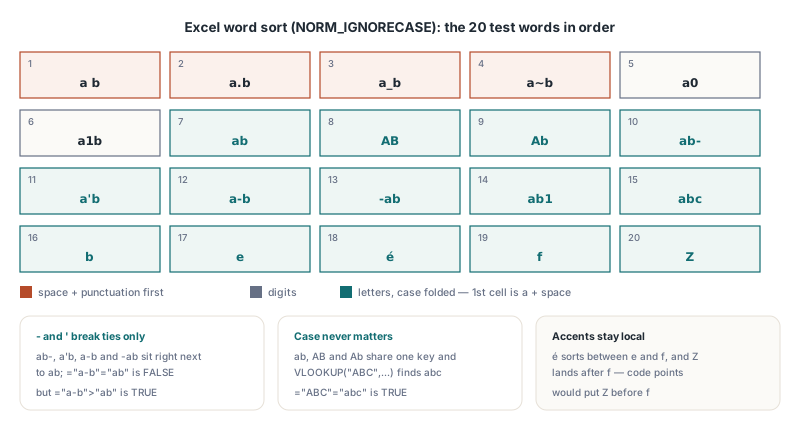
Dva důsledky se dají snadno minout. Zaprvé, dorovnávající role spojovníku znamená, že ="a-b"="ab" je FALSE: řetězce jsou v řazení těsní sousedé, přesto nejsou rovné. Zadruhé, rovnost ignoruje velikost písmen úplně, takže ab, AB a Ab jsou z hlediska jakéhokoli srovnání tentýž klíč. Seřadíte-li 20 testovacích slov přes Range.Sort Excelu, vypadne a b, a.b, a_b, a~b, a0, a1b, ab / AB / Ab, ab-, a'b, a-b, -ab, ab1, abc, b, e, é, f, Z; uvnitř skupiny ab rozhoduje pozice ignorovaného znaku
Jak se pořadí textu v Excelu vypátralo?
Pořadí textu v Excelu se zjistilo měřením, ne dokumentací, protože dokumentace Excelu kolaci jmenovitě neuvádí. Test vygeneroval 4 000 náhodných dvojic řetězců z ASCII interpunkce, číslic, obou velikostí písmen, mezer, é, ß, ä, čínských znaků, plných tvarů a nezalomitelné mezery, s délkami od 0 do 4, přičemž polovina dvojic se skládala jako páry lišící se jen na minimu míst. Excel 16 vyhodnotil pro každou dvojici IF(A<B,-1,IF(A=B,0,1)) a verdikty se porovnávaly se srovnávacím API Windows s různými sadami příznaků
- Samotné
NORM_IGNORECASE(výchozí word sort, uživatelské locale): žádný skutečný nesoulad. Jediných 7 rozdílů tvořily buňky, jejichž celý obsah byl', které Excel pohltí jako prefixový znak textu, takže šlo o artefakty vzorkování, ne o rozdíly kolace NORM_IGNORECASEsSORT_STRINGSORT: 41 neshod. String sort bere spojovník a apostrof jako obyčejné symboly, což je přesně to chování, které Excel nemá- Přidání
NORM_IGNOREWIDTH: špatně jiným způsobem, protože plné a poloviční tvary téhož písmene porovná jako rovné a Excel je drží oddělené
Druhá, ručně vybraná kontrola porovnala všech 190 dvojic složených z 20 záludných slov a výsledek Range.Sort Excelu nad tím samým sloupcem. Obojí se shodlo s prostým word sortem NORM_IGNORECASE a těch 190 verdiktů plus seřazené pořadí jsou dnes součástí regresní sady HotXLS, pouštěné přes klasické jádro TXLSWorkbook i nativní XLSX jádro TXLSXWorkbook
Proč se CompareText a ordinální srovnávání pletou?
CompareText a ordinální srovnávání se v Excelovském pořadí pletou, protože porovnávají kódové jednotky UTF-16 a pořadí kódových bodů rozestavuje interpunkci vůči písmenům libovolně. Spojovník je U+002D a apostrof U+0027, oba pod každým písmenem, takže ordinální srovnání prohlásí "a-b" za menší než "ab", místo aby spojovník bralo jako dorovnavače remíz. Vlnovka U+007E sedí nad každým písmenem, takže "a~b" vychází větší, přesný opak Excelu. CompareText v Delphi RTL převádí na velká písmena jen a..z a pak porovnává kódové jednotky, což přidává druhé zkreslení: podtržítko U+005F leží mezi velkými a malými písmeny, takže převod na velká písmena přesune "a_b" zpod "ab" nad něj. Ani jedna funkce neví, že é patří mezi e a f
Běžné nástroje z Delphi padají na obě strany hranice:
CompareStr, operátor<pro řetězce aTComparer<string>.Default(což voláCompareStr) jsou ordinální a citlivé na velikost písmen, takžeTArray.Sort<string>bez komparéru dáZpředfCompareTextaSameTextjsou ordinální po sklopení velikosti písmen jen v rozsahu ASCIIAnsiCompareTextaWideCompareTextv Delphi RTL na Windows volajíCompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...), též volání, které sedí na Excel. SeřazenýTStringLists výchozím nastavením (UseLocaleTrue,CaseSensitiveFalse) jde přesAnsiCompareTexta proto s Excelem taky souhlasí- Na POSIX cílech směruje Delphi RTL
AnsiCompareTextpřes ICU kolátor, což je jiný algoritmus s jinými interpunkčními pravidly, aAnsiCompareTextve Free Pascalu na Windows voláCompareStringApo převodu na ANSI kódovou stránku, čímž ztratí každý znak, který tamní stránka neumí
Takže locale-citlivé funkce RTL jsou na Windows správné díky implementaci, ne díky kontraktu, a kód, který potřebuje Excelovské pořadí, dělá líp, když zavolá API explicitně. HotXLS měl uvnitř stejnou směs. Srovnávací operátory převáděly oba řetězce na velká písmena a porovnávaly kódové body, větve > / < funkcí kritérií používaly Delphi Variant srovnání citlivé na velikost písmen a VLOOKUP / HLOOKUP pároval text tímže Variant srovnáním citlivým na velikost písmen, a proto VLOOKUP("ABC",A1:A20,1,FALSE) nemohla najít abc. Řazení oblastí už používalo WideCompareText. Tři cesty, tři pořadí
Co se změnilo v HotXLS v2.384.67?
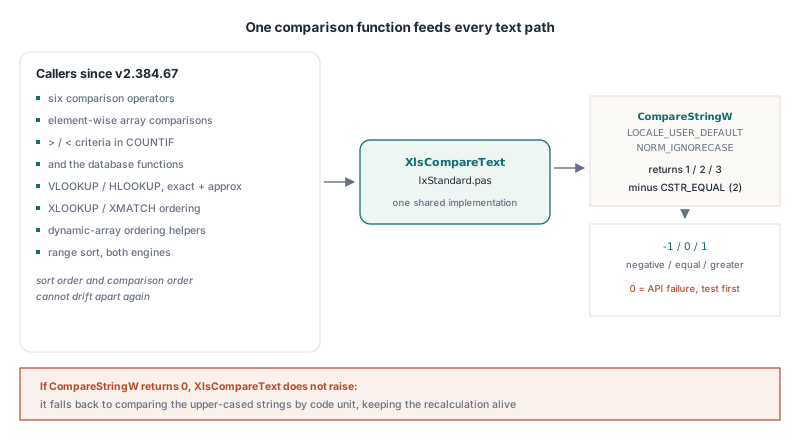
Od v2.384.67 jdou srovnání text-versus-text ve výpočetních a řadicích cestách HotXLS přes jedinou funkci, XlsCompareText v lxStandard.pas, která volá CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...) a odečte CSTR_EQUAL. Volajícími jsou šest srovnávacích operátorů, srovnání po elementech v maticových vzorcích, větve >, <, >= a <= kritérií ve stylu COUNTIF a databázových funkcí, VLOOKUP a HLOOKUP (exaktní i přibližné), pomocníci pořadí za maticovými funkcemi a XLOOKUP / XMATCH a řazení oblastí obou jader. To, že řazení oblastí jde touž funkcí, zaručuje, že se pořadí řazení a pořadí srovnávání nemůžou znovu rozejít, což záleží, protože přibližné VLOOKUP nad textem dává smysl jen tehdy, když byl sloupec seřazen v tom pořadí, ve kterém lookup porovnává
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // Calculate vyhodnocuje nad aktivním listem
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True: spojovník jen dorovnává remízy
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False: remíza rozbitá, nerovné
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True: interpunkce nejdřív
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True: velikost písmen ignorována
  finally
    Book.Free;
  end;
end;
Srovnání napříč typy jsou zvláštní pravidlo a nezměnila se: každé číslo je pod každou textovou hodnotou a každá textová hodnota pod každým booleanem, jak popisuje článek o srovnávacích řetězcích, prázdných operandech a SUMIF. Word sort se uplatní, jen když jsou oba operandy text. Zástupné znaky (wildcard) jsou taky samostatná věc: kritérium jako "a*" nebo "=ab" je test vzorku nebo rovnosti, pokrytý v průvodci Excel wildcardy v COUNTIF, MATCH a DSUM, a kolace probíraná zde rozhoduje jen o operátorech pořadí
Další příklad nahraje 20 testovacích slov do sloupce, seřadí ho přes TXLSXWorksheet.SortRange a zkontroluje počet kritérií a jeden lookup. Počty jsou ty, které vrátil Excel 16 nad tím samým sloupcem
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // Excel 16 nad týmž sloupcem: 11, 11, 14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // Před v2.384.67 #N/A: lookup porovnával s velikostí písmen
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // Jeden klíčový sloupec, vzestupně: a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;
TXLSXWorksheet.SortRange používá stabilní merge sort, takže ab, AB a Ab, která se srovnají jako rovná, si nechají relativní pořadí z doby před řazením. Prázdné buňky putují na konec v obou směrech, jako v Excelu
Jak vlastním kódem v Delphi dosáhnu Excelovského pořadí řazení?
Aby váš kód v Delphi seděl na Excelovské pořadí textu, volejte CompareStringW s LOCALE_USER_DEFAULT a NORM_IGNORECASE a nepřidávejte SORT_STRINGSORT ani NORM_IGNOREWIDTH. Návratová hodnota není znaménkový výsledek srovnání: API vrací CSTR_LESS_THAN (1), CSTR_EQUAL (2) nebo CSTR_GREATER_THAN (3) a 0, když volání selže. Odečtěte 2, abyste dostali obvyklou konvenci negativní / nula / pozitivní, a nejdřív testujte 0, protože selhání považované za výsledek se stane -2, tichým „menší než“
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// Pořadí textu Excelu: word sort uživatelského locale, bez velikosti písmen
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // 0 je selhání, ne výsledek srovnání
  Result := R - CSTR_EQUAL;    // 1/2/3 se stanou -1/0/1
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB (rovné, libovolné pořadí), a-b, -ab, abc
end;
TArray.Sort není stabilní, takže klíče, které se srovnají jako rovné, jako ab a AB, můžou vypadnout v libovolném pořadí; pokud na původním pořadí rovných klíčů záleží, seřaďte pole indexů s původní pozicí jako sekundárním klíčem. Přichází i opačný případ: někdy sloupec nesmí jít podle Excelovského pořadí, třeba kusovníková čísla, kde jsou X-100 a X100 odlišné kódy a mají se řadit podle kódových bodů. TXLSXWorksheet.SortRange má přetížení, které bere TXLSSortCompareEvent, metodu se signaturou function(const Left, Right: Variant): Integer of object, a použije ji místo vestavěného srovnání
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // Vlastní komparér dostává taky prázdné buňky (jako Null): umístěte je sami
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // ordinální, s velikostí písmen
end;

var
  Sheet: TXLSXWorksheet;   // naplněný list, řádky 2..501, sloupce A..D
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // klíč podle sloupce A, vzestupně
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;
Je-li dodán vlastní komparér, HotXLS vynechá vlastní zacházení s prázdnými a podá syrové klíčové hodnoty, takže se komparér musí vypořádat s Null. U sestupného klíče HotXLS neguje, co komparér vrátí, což navíc přesune prázdné nahoru, pokud to komparér neřeší. Mějte na paměti, že sloupec seřazený takhle už není v pořadí, které čeká přibližné VLOOKUP Excelu nebo XLOOKUP s binárním hledáním; úskalí těchto módů na datech seřazených jinak pokrývá průvodce binárními vyhledávacími módy XLOOKUP a XMATCH
Proč může ten samý sešit řadit na jiném stroji jinak?
Ten samý sešit může na jiném stroji řadit jinak, protože Excelovské pořadí textu závisí na uživatelském locale Windows a HotXLS za tou závislostí záměrně jde. Word sort je jazykově specifický: švédská kolace třeba staví ä za z, kde angličtina a němčina ho drží vedle a. Excel to dědí z locale, ve kterém běží, takže sešit přepočítaný kolegou ve Stockholmu může vrátit jiné COUNTIF(...,">y") než tentýž soubor na desktopu v Chicagu. HotXLS podává LOCALE_USER_DEFAULT, aby jeho výsledky na témže stroji odpovídaly Excelu; jakékoli fixní locale by zavinilo, že HotXLS bude s Excelem nesouhlasit na každém stroji s jiným nastavením
Pro serverovou generaci z toho plyne tři praktických důsledků:
- Locale, které se počítá, je to účtu, pod kterým proces běží. Služba Windows nebo aplikační pool IIS může mít jiný regionální formát než desktop vývojáře, takže výsledky pozorované v IDE nejsou automaticky to, co spočítá produkce
- Výsledky vzorců uložené do mezipaměti v souboru odrážejí locale generujícího stroje. Excel přepočítává se svým locale, takže hodnota se může změnit, když se soubor otevře jinde a přepočítá; to je chování Excelu, ne artefakt HotXLS
- Locale se nejvíc neshodují na písmenech s diakritikou, na kombinacích písmen, které některé jazyky berou jako jedno písmeno, a na ne-latinských písmech, takže testovací data omezená na prostá anglická slova problém neodhalí
Hranice platforem je prostá. HotXLS je Windows knihovna, stavěná pro Win32 a Win64 s Delphi a C++Builder a pro cíle win32 / win64 s Lazarus a Free Pascal, a všechny tyhle buildy volají totéž CompareStringW. Samostatná ne-Windows cesta kolace neexistuje. Jediný fallback je pro selhavší volání API: vrátí-li CompareStringW 0, porovná XlsCompareText řetězce převrstvené na velká písmena po kódových jednotkách, místo aby házela výjimku uprostřed přepočtu, což udrží výpočet v běhu, ale už negarantuje Excelovské pořadí
Rychlý přehled: srovnávání textu v Excelu v HotXLS
- Pravidlo: word sort uživatelského locale s
NORM_IGNORECASE, bezSORT_STRINGSORT, bezNORM_IGNOREWIDTH, v HotXLS od v2.384.67 -a'dorovnávají jen remízy:="a-b">"ab"je TRUE a="a-b"="ab"je FALSE- Jiná interpunkce se řadí před číslice, číslice před písmena:
="a~b"<"ab"i="a0"<"ab"je TRUE - Velikost písmen nikdy nerozhoduje:
="ABC"="abc"je TRUE aVLOOKUP("ABC",...)najdeabc - Pokryté cesty: srovnávací operátory, maticová srovnání, kritéria
>/<,VLOOKUP/HLOOKUP, pořadí dynamických polí,SortRangev obou jádrech - Tímto pravidlem nepokryté: smíšené typy (číslo < text < boolean) a wildcard kritéria, ta mají vlastní pravidla
- V kódu Delphi:
CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...), test na 0, odečístCSTR_EQUAL; vyhněte seCompareText,CompareStraTComparer<string>.Default, když má výsledek souhlasit s Excelem - Výsledky závisí na locale účtu, pod kterým kód běží, v Excelu i v HotXLS stejně
Obyčejná slova se seřadí stejně pod každým pravidlem, takže špatnou kolaci prozradí jen kódy se spojovníky, interpunkce a jména s diakritikou. HotXLS teď dává Excelovskou odpověď na všech z nich v obou jádrech, XLS i XLSX. Detaily o licencování, podporovaných verzích Delphi a C++Builder a zkušební stažení najdete na stránce komponenty HotXLS Delphi Excel