HotXLS Delphi Component vyhodnocuje =1<2<3 jako FALSE, tutéž odpověď, jakou dá Excel 16, protože od v2.384.3 skládá jeho formula parser srovnávací operátory zleva doprava: 1<2 se stane TRUE a TRUE<3 je FALSE, protože boolean se řadí nad každé číslo. Týž release udělá prázdný operand rovným současně 0 i "" a nechá SUMIF roztáhnout jednobuněčný součtový rozsah na tvar kritériového rozsahu. Každá z těchhle věcí vypadá jako blbost, dokud sešit spočítaný v Delphi nesouhlasí s tímže sešitem otevřeným v Excelu
Neshoda obvykle začíná vzorcem, který někdo napsal intuicí. Někdo napíše =0<B2<100, aby ověřil, že množství je v rozsahu, Excel potichu odpoví FALSE na každém řádku a list odjede s tímhle bugem zapečeným uvnitř. Výpočetní engine nemá opravovat úmysl uživatele; jeho prací je vyprodukovat hodnotu, kterou by vyprodukoval Excel, aby cachovaný výsledek, který HotXLS zapíše do souboru, odpovídal tomu, co Excel ukáže po přepočtu. Před v2.384.3 odpovídal HotXLS na tuhle kontrolu rozsahu na každém řádku TRUE, špatně opačným směrem, a report generovaný na serveru by si odporoval se stejným reportem otevřeným na desktopu
Proč vrací =1<2<3 v Excelu FALSE?
Excel vrací FALSE, protože čte řetězec porovnání jako (1<2)<3 a vnitřní TRUE pak v soutěži typového řazení prohraje s číslem 3. Starý parser HotXLS četl tentýž text jako 1<(2<3): TXLSSyntax.Parse_expr v lxFormula.pas vyparsoval jeden operand, uviděl srovnávací token a rekurzoval do Parse_expr pro pravou stranu, což z operátoru dělá right-associativní. Z toho vypadlo 1<TRUE a číslo je pod booleanem, takže výsledek byl TRUE. Chyba je symetrická: =3>2>1 je v Excelu TRUE a v HotXLS bylo FALSE a =1=1=TRUE je v Excelu TRUE a před opravou bylo FALSE. Regresní test CalculateFormula_ComparisonChainsFoldLeftToRight připíchá sedm takových vzorců proti hodnotám vráceným Excelem 16 a každý z nich pustí oběma engine architekturami, classic TXLSWorkbook a XLSX-nativní TXLSXWorkbook, přes metodu Calculate popsanou v Jádro vzorců HotXLS a vlastní funkce v Delphi
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Co vrací Excel 16:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate vyhodnocuje proti aktivnímu listu a
    // vrací Null, když sešit nemá vůbec žádný list
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;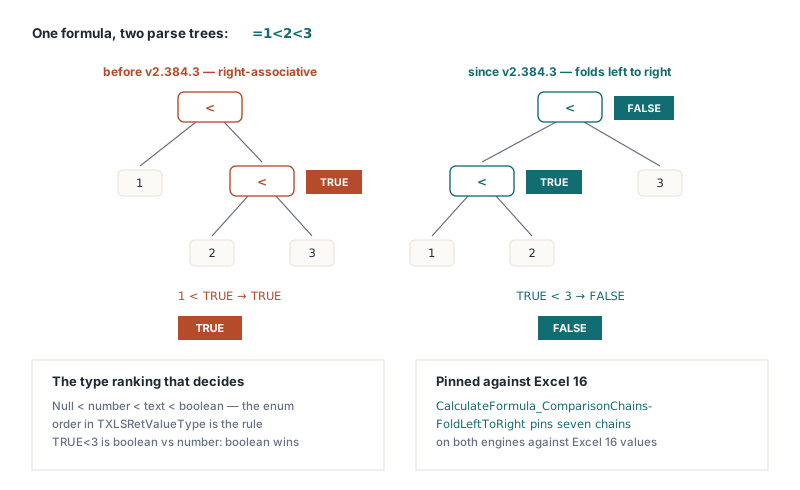
Oprava mění Parse_expr na smyčku téhož tvaru, jaký už Parse_expr1 používá pro +, - a &. První operand vyparsuje přes Parse_expr1 a dokud je další token jedno z =, <>, <, >, <= nebo >=, vytvoří srovnávací uzel, pověsí akumulovaný levý výsledek jako prvního potomka, vyparsuje další operand přes Parse_expr1 místo Parse_expr a udělá z nového uzlu levý výsledek pro další kolo. Dva detaily se při převodu rekurze na iteraci daly pokazit snadno a oba jsou v poznámkách maintainerů: akumulovaný uzel se musí předat v pořadí (lChild := Item; Item := nil) a chybová cesta musí po uvolnění napůl postaveného uzlu Exitnout, místo aby vypadla ze smyčky a vrátila visící strom
Jak řadí HotXLS čísla, text a booleovské hodnoty v porovnání?
HotXLS řadí míšené typy jako Excel: každé číslo je menší než každá textová hodnota a každá textová hodnota je menší než každý boolean. TXLSCalculator.CompareVariants v lxCalc.pas klasifikuje oba operandy přes GetRetValueType do výčtu TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue) a když se třídy liší, prostě porovná jejich ordinály, takže pořadí deklarace enumu je pravidlo napříč typy. Uvnitř jedné třídy je porovnání přirozené, s jedním excelovým twistem u textu: oba stringy projdou nejdřív lxUpperCase, takže ="abc"="ABC" je TRUE. Právě tohle řazení je důvod, proč se výsledek řetězce nedá rozumně uvažovat bez něj. TRUE<3 není konverze TRUE na 1, je to boolean porovnaný s číslem a boolean vyhrává. Data jsou pro engine seriální čísla (varDate se klasifikuje jako xlNumberValue), takže datum je vždy pod jakýmkoli textem, včetně textu, který náhodou vypadá jako datum
Čemu se rovná prázdná buňka v porovnání?
Prázdná buňka použitá jako srovnávací operand se rovná 0, když je druhá strana číslo, rovná se "", když je druhá strana text, a od v2.384.53 se rovná FALSE, když je druhá strana logická hodnota, takže s prázdným A1 jsou =A1=0, =A1="" i =A1=FALSE všechny TRUE. TXLSCalculator.CompareVarValues, které obsluhuje všech šest srovnávacích operátorů, nahradí prázdnou hodnotu dřív, než zavolá CompareVariants: pokud je Null právě jeden operand, stane se WideString(''), když je jeho partner string, False, když je jeho partner boolean, a jinak 0. Dvě prázdné hodnoty se pořád porovnají jako rovné bez substituce. Aritmetická cesta dělala z prázdné hodnoty 0 vždycky, proto =A1+1 dávalo 1, ale CompareVariants drží Null jako vlastní nejnižší hodnost, pod každým číslem, a srovnávací operátory tuto hodnost používaly přímo
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // A1 je záměrně ponechané prázdné

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: prázdná hodnota se porovná jako 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False; před v2.384.3 True
end;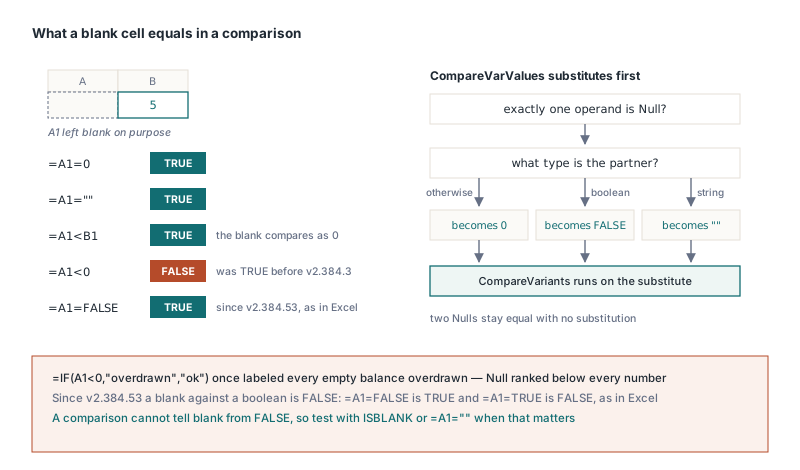
Poslední řádek je ten, který v praxi bolel. Pod starou hodností byla prázdná hodnota menší než každé číslo, včetně záporných, takže =IF(A1<0,"overdrawn","ok") označilo každou prázdnou buňku zůstatku jako přečerpanou a =A1=0 bylo FALSE u buňky, kterou by každý uživatel popsal jako nulu. Jedna hranice zůstala i po v2.384.3: substituce si vybírala jen mezi 0 a prázdným stringem, takže prázdná hodnota porovnaná s booleanem se stala 0, což se řadí pod TRUE i FALSE, a =A1=FALSE na prázdném A1 vyhodnotilo FALSE. Od HotXLS 2.384.53 se prázdná hodnota porovnaná s logickou hodnotou bere jako FALSE v obou engine, XLS i XLSX, stejně jako v Excelu: s prázdným A1 vrátí =A1=FALSE a =A1<TRUE TRUE a =A1=TRUE vrátí FALSE. To taky znamená, že porovnání nerozliší prázdnou hodnotu od FALSE, a to v Excelu i v HotXLS; když list tohle rozlišení potřebuje, testujte přes ISBLANK nebo =A1=""
Proč vracel SUMIF s jednobuněčným součtovým rozsahem 0?
SUMIF vracel 0, protože HotXLS clampoval iteraci na menší z obou rozsahů, zatímco Excel drží tvar kritériového rozsahu a součtový rozsah používá jen kvůli jeho levému hornímu rohu. =SUMIF(A1:A10,">5",B1) tedy v Excelu znamená B1:B10, pohodlí, na které se spoléhá spousta ručně poskládaných šablon. Sdílený worker TXLSCalculator.GetValueItemRange2 si dřív zmenšoval počty řádků a sloupců na ty hodnotového rozsahu, což příklad zredukovalo na jediný test A1 proti B1. v2.384.3 clamp odstraňuje: smyčka teď projde kritériovým rozsahem a čte každou hodnotu na stejném offsetu od levého horního rohu součtového rozsahu. Protože CalcSumIF i CalcAverageIF volají tenhle worker, dostává AVERAGEIF tutéž změnu rozměru a součtový rozsah větší než kritériový rozsah se ze stejného důvodu zkrátí na tvar kritérií. Prostřední argument kritérií je hodnotové třídy a vnější dva jsou referenční třídy — tenhle rozdíl rozebírá článek o implicitním průniku a třídách argumentů
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // kritériový sloupec: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // částky: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // jednobuněčný součtový rozsah
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // explicitní součtový rozsah
    if Book.Recalculate = lxOk then
      // D1 i D2 jsou 4000 (600+700+800+900+1000); D1 bylo před v2.384.3 0
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;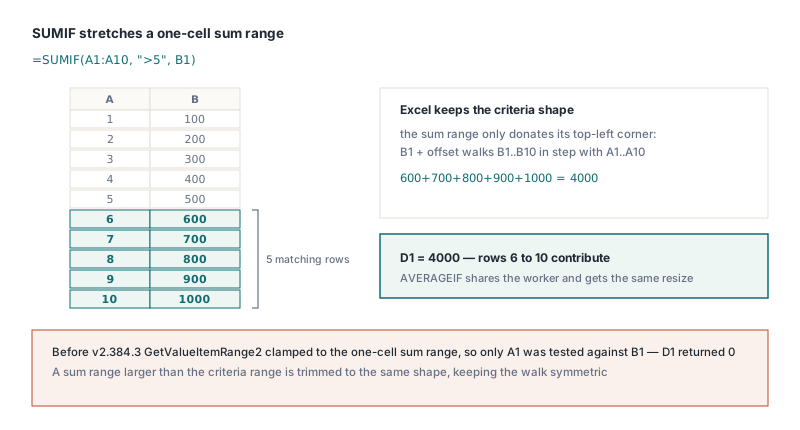
INDIRECT a YEARFRAC: dvě tišší korekce
INDIRECT nyní respektuje svůj druhý argument a text za validní referencí je chyba místo ignorace. S a1 FALSE se text parsuje jako absolutní R1C1, takže =INDIRECT("R2C3",FALSE) čte C2; starý kód flag ignoroval, četl "R2" jako sloupec R, řádek 2, a tiše vrátil špatnou buňku. Flag se dispatchuje podle variantního typu (boolean, číslo nebo text), protože přímá konverze string variantu na Double vyhodí výjimku. Relativní R1C1 text jako R[1]C[1] vrací #REF!, protože INDIRECT nemá původ vzorcové buňky, vůči které by ho vyřešil, a A1 text se závěrečnými znaky, "B2 junk", vrací #REF! taky. YEARFRAC se základem 0 nyní aplikuje NASD pravidla posledního února, která DAYS360 už implementovala: jsou-li obě data posledním dnem února, koncový den se stane 30 a pak se start na poslední den února stane 30. Od 2024-02-29 do 2025-02-28 je počet teď 360 dní, zlomek přesně 1, kde předchozí Days360US počítal 359
Co tyhle opravy garantují a jaká byla lekce?
Chování porovnávacích řetězců garantuje test, který porovnává oba engine s hodnotami změřenými v Excelu 16, a tenhle test existuje proto, že první popis opravy byl špatný. Release note v2.384.3 původně říkala, že skládání zleva doprava udělalo z =1<2<3 TRUE, což je přesně to, co produkoval starý right-associativní parser, a opak toho, co vracejí Excel i nový kód. Nikdo si příklad nevyhodnotil; byl napsaný z intuice „1 je menší než 2 je menší než 3". Note se opravila a sedmivzorcový test přidal follow-up commit a pravidlo, které z toho vzešlo, platí pro každého, kdo dokumentuje chování tabulek: pusťte příklad v Excelu, než si očekávanou hodnotu zapíšete. Substituce prázdného operandu i změna rozměru SUMIF následuje tutéž excelovou cestu, včetně případu prázdná-hodnota-versus-boolean od v2.384.53, a podmíněné agregáty, které musejí navíc vynechávat filtrované nebo skryté řádky, následují samostatná pravidla v článku o SUBTOTAL a AGGREGATE u skrytých řádků
HotXLS je nativní tabulková komponenta pro Delphi a C++Builder, která čte, přepočítává a zapisuje XLS, XLSX, ODS a CSV bez nainstalovaného Excelu a pravidla porovnávání, prázdných hodnot a SUMIF popsaná tady bydlí ve výpočetním engine, který sdílí obě architektury sešitů. Kompletní seznam funkcí a licenční volby najdete na produktové stránce komponenty HotXLS pro Excel v Delphi