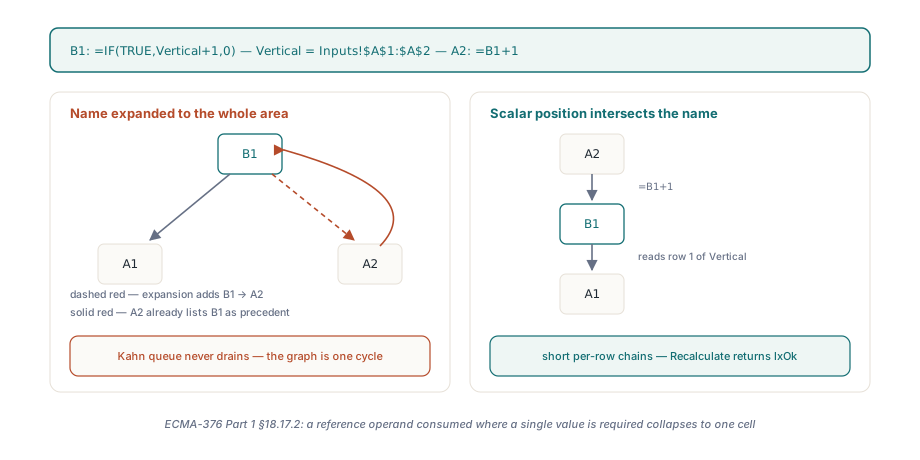
Definovaný název odkazující na celý sloupec přečte Excel jako jedinou buňku, když stojí ve skalární pozici: =Vertical+1 v řádku 7 znamená „buňku řádku 7 z Vertical", ne celou oblast. HotXLS Delphi Component aplikuje tenhle implicitní průnik ve v2.382.4 na dvou úrovních, během vyhodnocení i během extrakce závislostí, protože šablona půjčky s 4805 vzorci ukázala, že samotná správná hodnota nestačí. Když walker závislostí rozbalí název na celou oblast, vzorec níže, který krmí jakoukoli buňku té oblasti, zavře cyklus, který neexistuje, a TXLSXWorkbook.Recalculate odmítne celý sešit
Řeč je o sešitu s amortizací úvěru. Se všemi cached hodnotami otrávenými na 777 a plným během Recalculate vrátily obě architektury enginu 23, což je lxErrorRef, kód kruhové reference. 3842 z 4805 vzorců neodpovídalo nezávislému očekávání, B18 drželo #VALUE!, E18 bylo pořád 777 a počet plateb v J7 si přečetl placeholdery v nedokončeném sloupci zůstatku. Tři samostatné defekty se skryly za jediným návratovým kódem a tenhle článek každý z nich projde spolu se zdrojem, který ho opravil
Proč skalární reference na název sloupce vytvoří falešný cyklus?
Protože graf závislostí zná jen hrany a hrana od vzorce na oblast o 480 řádcích je 480 hran, z nichž jedna míří zpátky buňkou, která na vzorci závisí. Vezměte =IF(TRUE,Vertical+1,0) v B1 s Vertical definovaným jako Inputs!$A$1:$A$2 a =B1+1 v A2. Excel vyhodnotí B1 jako A1+1 a A2 jako B1+1, rovnou řadu. Walker, který zaznamená B1 jako závislé na A1:A2, udělá z A2 precedent B1, A2 už B1 mezi precedenty vede a Kahnova fronta, která řídí inkrementální přepočet v HotXLS, se nikdy nedočká, že by některý uzel klesl na vstupní stupeň nula. Tohle je přesně vzor, ze kterého jsou šablony půjček poskládané: každý řádek období odkazuje na pojmenované sloupce zůstatku, sazby a počtu plateb, každý název pokrývá celý plán a každý řádek zároveň zapisuje do těch sloupců. Rozbalte názvy a graf je jedna obrovská silně souvislá komponenta. Vyhodnoťte je s implicitním průnikem a graf je sada krátkých řad, jedna na řádek plánu, což je to, co ECMA-376 Part 1 §18.17.2 popisuje pro referenční operand konzumovaný tam, kde se vyžaduje jediná hodnota
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Skalární pozice: Vertical se smrskne na A1, protože vzorec stojí v řádku 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Název, jehož definicí je jiný název, taky proniká, takže tady vyjde A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argument referenční třídy: sčítá se celá oblast, žádný průnik
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Řádek 6 leží mimo A1:A2, průnik je prázdný a IFERROR to chytí
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Před v2.382.4 byla tahle větev nedosažitelná: B1 -> A2 -> B1 byl cyklus
    end;
  finally
    Book.Free;
  end;
end;
Jak HotXLS pozná, že argument je skalární?
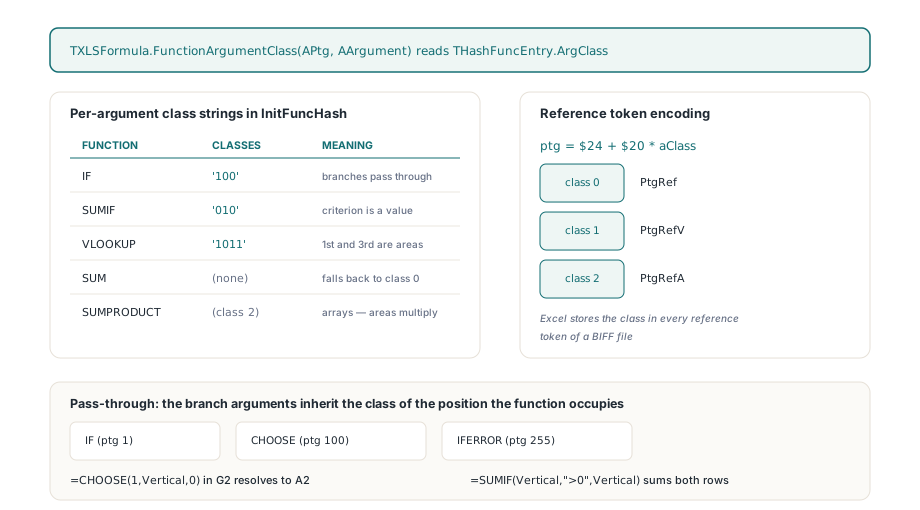
HotXLS čte odpověď z tabulky funkcí, ne z tvaru argumentu. Každá položka v TXLSFormula.InitFuncHash se registruje přes THashFunc.SetValue s volitelným řetězcem tříd argumentů: 'IF' nese '100', 'SUMIF' nese '010', 'VLOOKUP' nese '1011' a 'SUM' nenese nic, takže všechny jeho argumenty spadnou k třídní úrovni funkce 0. Nové TXLSFormula.FunctionArgumentClass(APtg, AArgument) vystavuje ten byte přes THashFuncEntry.ArgClass a výsledek 1 znamená třídu hodnoty. Jsou to ty samé tři třídy, které [MS-XLS] §2.2.2 přiřazuje operandovým tokenům, a kodér na nich už dávno závisí: když zapisuje referenci, počítá ptg jako $24 + $20 * aClass, což dá PtgRef pro třídu 0, PtgRefV pro třídu 1 a PtgRefA pro třídu 2. BIFF soubor psaný Excelem drží tu třídu v každém referenčním tokenu, takže engine, jehož tabulka odpovídá specifikaci, odpoví na otázku „je tenhle argument skalární" bez pohledu na data. Střední argument SUMIF je kritérium, hodnota; první a třetí jsou oblasti, reference. SUMPRODUCT je registrovaný s třídní úrovní funkce 2, pole, a proto =SUMPRODUCT(Vertical,Vertical) stále násobí celou oblast
Tři funkce se o vlastní položku tabulky neptají pro nic za prvním argumentem. IF (ptg 1), CHOOSE (ptg 100) a IFERROR (ptg 255) propouštějí skrz cokoli vyberou, takže jejich větvní argumenty dědí třídu pozice, kterou samotná funkce zaujímá. Toto jediné pravidlo dovoluje, aby se =CHOOSE(1,Vertical,0) v G2 rozřešilo na A2, zatímco =SUMIF(Vertical,">0",Vertical) vedle toho stále sečte oba řádky, a je to pravidlo, které amortizační plán prověřuje nejvíc, protože jeho buňky období opírají o IF test, zda je půjčka stále otevřená
Jak třída projde průchodem závislostí
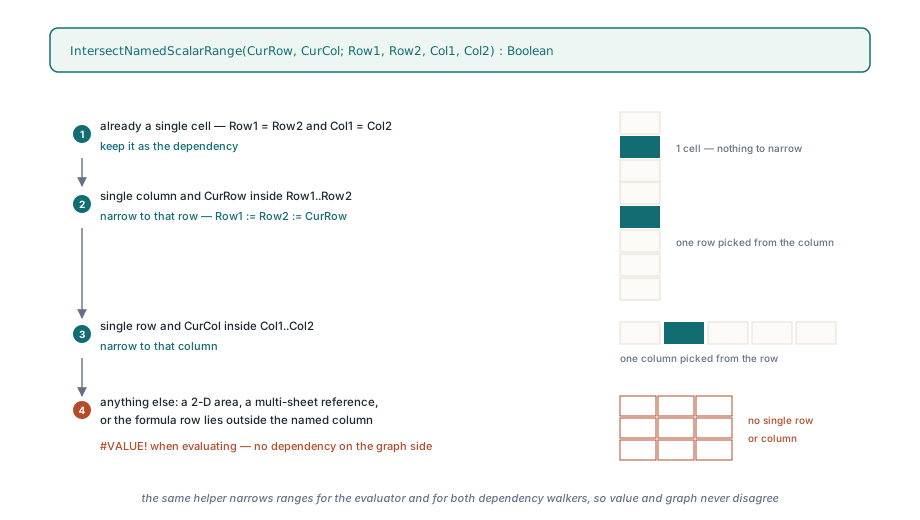
Extraktor závislostí v lxCalc.pas je rekurzivní Walk nad zkompilovaným syntaktickým stromem a existuje dvakrát, jednou v TXLSCalculator.ExtractDependencies pro graf na úrovni sešitu a jednou v ExtractWorkspaceDependencies pro graf mezi sešity. v2.382.4 dává oběma walkerům dva další parametry. AScalar začíná jako True v kořeni vzorce, přepočítává se pro každého potomka-funkci z FunctionArgumentClass a pro větvní argumenty ptg 1, 100 a 255 prochází beze změny. ANameRoot se stane True jen tehdy, když walker sestoupí do zkompilované definice názvu, a přežije jen skrz uzly SA_GROUP, závorky, takže název definovaný jako =A1:A2+1 se nespletou za prostou oblast. Když jsou oba příznaky True u uzlu SA_RANGE, AddResolvedRange zužuje oblast stejnou pomocnou funkcí, kterou používá vyhodnocovač, dřív než závislost zaznamená. Ta pomocná funkce je krátká na to, aby se citovala celá
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // už je buňka
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // jediný sloupec: vezmi tento řádek
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // jediný řádek: vezmi tento sloupec
    Result := True;
  end;
end;
Cokoliv, co pomocná funkce odmítne, dvourozměrná oblast, reference na více listů nebo vzorec, jehož řádek leží mimo pojmenovaný sloupec, dá na straně vyhodnocení #VALUE! a na straně grafu vůbec žádnou závislost, což je to, co Excel dělá u prázdného průniku. Strana vyhodnocení bydlí v TXLSCalculator.GetValueItemName: svlékne obálky SA_GROUP ze zkompilované definice a když je kořen SA_RANGE, zavolá GetRangeInfo, provede průnik a jednu buňku vytáhne přes FGetValue místo vyhodnocení celé definice. Externí reference zůstávají na staré cestě, protože nemají lokální řádek, proti kterému by se proniklo. Kde název bere svoje uložení a scope, to rozebírá článek o definovaných názvech a vzorcích přes listy; tady jde jen o to, co engine udělá, jakmile se název rozřeší
Proč MATCH nad napůl přepočítaným sloupcem četlo 777?
Protože argument vyhledávacího pole MATCH je scan reference a scan reference byly záměrně vyňaty z pořadí vyhodnocování. Článek o vyhledávacím skenu představil TXLSDepRange.LookupScan a zakončil sekcí „Co obětujete vynětím scan hran z uspořádání": vzorec s lookupem může běžet dřív, než se přepočítá každá buňka v jeho oblasti, a číst zastaralé hodnoty. V interaktivní relaci se to srovná v dalším průchodu. V dávkovém přepočtu otrávené šablony ne, a PaymentCount, definované jako =MATCH(0.01,Balances,-1)+1, přečetlo 777 placeholderů, které v sloupci zůstatků ještě seděly, a vrátilo počet období, který nemohl být správně
TXLSDepGraph.TopoOrder teď bere scan hrany jako měkké uspořádávající hrany. Vedle tvrdého vstupního stupně drží pole ScanInDeg, počítá špinavé scan precedenty na uzel a snižuje ho, jak se ty precedenty vypouštějí, přes seznamy ScanPrecedents, ScanDependents a ScanPrecedentCount, které starší změna už ukládala. V každé iteraci Kahnova fronta proskenuje svoje hotové okno po prvním uzlu s ScanInDeg nula a vymění ho na čelo; pokud každý hotový uzel pořád čeká na scan precedent, čelo se vypustí ve svém stabilním pořadí. Scan hrany nikdy nevstupují do tvrdého vstupního stupně, takže seodkazující VLOOKUP nad vlastním sloupcem zůstává legální, ale lookup, který může počkat na doběhnutelný precedent, teď počká. Regrese, která to přibije, LookupScan_WaitsForDirtyFormulaValues, otráví tři buňky zůstatků na 777 a očekává, že PaymentCount vrátí 3, pak překlopí vstup na nulu a očekává, že =IFERROR(PaymentCount,99) uvidí #N/A a vrátí 99
Odkud se vzalo oříznutí na čtyři desetinná místa?
Z aritmetiky Variant v Delphi a jen ve vnořených pozicích. Binární operátory v TXLSCalculator.GetValueItem už kopírovaly vrcholové + nebo - do dvou lokálních Double, takže =B1-A1 bylo v pořádku. Uvnitř =IF(TRUE,B1-A1,0) běželo totéž odčítání jako Value := Value - SubValue nad dvěma Variant a když byl jeden operand celočíselná hodnota buňky Int64 a druhý Double, výsledkem, který jsme viděli, byl Currency, pevná desetinná čárka se čtyřmi místy, takže 1066.1854641400994 minus 120 přišlo oříznuté na čtyři desetinná místa. V plánu, kde je každá splátka složena z předchozího řádku, ta chyba projde stovkami období, než dorazí k souhrnům
// TXLSCalculator.GetValueItem, větev binární aritmetiky (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Smíšená aritmetika Variant Int64/Double se může povýšit na Currency.
// Tabulková aritmetika musí zachovat plovoucí přesnost.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Ta pojistka běží před SA_ADD, SA_SUB, SA_MUL i SA_DIV a regrese Arithmetic_MixedInt64AndDoubleKeepsPrecision uloží Int64(120) do A1 a 1066.1854641400994 do B1, pak kontroluje vnořený rozdíl a součet na 1E-10 a součin a podíl na 1E-8 a 1E-12. HotXLS netvrdí, že zná každé pravidlo povyšování, které RTL aplikuje na smíšené Variant typy napříč verzemi kompilátoru; tvrdí, že tabulková aritmetika je IEEE double, a teď z obou operandů udělá double, než je uvidí operátor, čímž otázku sám zruší
Co oprava zaručuje a co ne
Po v2.382.4 vrátí obě architektury enginu pro otrávenou šablonu lxOk, všech 4805 cached hodnot sedí s nezávislým očekáváním řádek po řádku na 1E-7 a assertion, že cache doopravdy byly otrávené, že hash zdroje je beze změny a že každý vzorec stále existuje, všechny drží. K tomu nebyla zapnuta žádná iterace ani potlačen žádný chybový kód. Skutečný cyklus přes název, =B1 v A1 s B1 čtoucím stále Vertical, pořád vrací chybu a test NamedScalarRanges_IntersectWithoutFalseCycles končí právě tímto assertionem
Hranice stojí za to vyslovit naplno. Implicitní průnik se aplikuje jen na název, jehož zkompilovaná definice je po svlečení závorek jednosloupcová nebo jednořádková oblast na jednom listu; dvourozměrný název ve skalární pozici dá #VALUE!, jako v Excelu, a funkce, kterou tabulka nezná, dostane z FunctionArgumentClass třídu 0, takže její názvové argumenty se pořád rozbalují celé. Měkké uspořádání je preference, ne záruka: cyklus s výhradně scan hranami se pořád vyhodnotí ve stabilním pořadí a čte, co je v cache, což je chování, které článek o vyhledávacím skenu záměrně přijal. A výsledek celé šablony se ověřuje proti nezávislému očekávacímu skriptu, ne proti jinému tabulkovému enginu, protože referenční office balík nedokončil přepočet původní šablony v rozpočtu 60 sekund. HotXLS je nativní tabulková komponenta pro Delphi a C++Builder, která čte, přepočítává a zapisuje XLS, XLSX, ODS a CSV bez nainstalovaného Excelu; průnik názvů, tabulka tříd argumentů a měkké scan uspořádání platí pro všechny formáty, protože výpočetní engine je sdílený, a aktuální pokrytí funkcemi uvádí produktová stránka tabulkové komponenty HotXLS pro Delphi