HotXLS Delphi Component čte tentýž vzorový řetězec čtyřmi různými způsoby, protože to dělá i Excel 16. V COUNTIF a SUMIF je text a~b literál, pokud kritérium neobsahuje i * nebo ?; v MATCH a XLOOKUP ve wildcard módu je vlnovka vždycky escape, takže a~b najde ab; v DSUM a dalších databázových funkcích znamená prostý text „začíná na“; a celobuněčné Find se musí vracet zpět k poslední hvězdičce *. HotXLS se těmito odměřenými pravidly řídí od v2.384.52, v2.384.60 a v2.384.64
Bug reporty z téhle oblasti wildcardy nikdy nezmiňují. Říkají, že report generovaný na serveru počítá o pár řádků míň než tentýž soubor přepočítaný v Excelu, nebo že kusovníkové číslo obsahující vlnovku najde jedna formule a ta následující ho přehlédne. Příčinou je matcher, který předpokládá, že vzorec znamená všude totéž. Excel tak nefunguje, takže jádro, jehož výsledky v mezipaměti musí souhlasit s Excelem, taky nemůže. Před v2.384.52 pouštěl HotXLS každé kritérium přes DOS-ovskou souborovou masku, která měla běžné vzorce správně a okrajové případy potichu špatně
Proč znamená jeden vzorový řetězec v Excelu čtyři různé věci?
Jeden vzorový řetězec znamená čtyři různé věci proto, že Excel zdědil čtyři pravidla párování ze čtyř funkcí a nikdy je nesjednotil. Funkce kritérií (COUNTIF, SUMIF, AVERAGEIF a rodina *IFS) rozhodují u každého kritéria, zda se wildcardy uplatní vůbec. Vyhledávací funkce (MATCH s typem shody 0, XLOOKUP s match_mode 2) je aplikují vždycky. Databázové funkce (DSUM, DCOUNTA a kamarádi) následují Advanced Filter, kde holé slovo znamená prefix. Dialog Find má vlastní režimy celé buňky a části. Tabulka níže uvádí, které buňky se chytí na každý vzorec nad jedním sloupcem obsahujícím a~b, ab, AB, abc, abcb, a*b a axb, s každou funkcí ve výchozím režimu bez rozlišení velikosti písmen
| Vzor | COUNTIF / SUMIF | MATCH(…,0) / XLOOKUP mód 2 | Kritérium DSUM | Find, celá buňka, wildcardy zapnuté |
|---|---|---|---|---|
ab | ab, AB | ab, AB | ab, AB, abc, abcb | ab, AB |
a*b | a~b, ab, AB, abcb, a*b, axb | stejné jako COUNTIF | každá položka, abc včetně | stejné jako COUNTIF |
a~b | jen a~b | ab, AB | ab, AB, abc, abcb | ab, AB |
a~*b | jen a*b | jen a*b | jen a*b | jen a*b |
=ab | ab, AB | nepoužitelné | ab, AB | nepoužitelné |
Řádek a~b je ten, kde se COUNTIF a MATCH rozejdou, a kusovníková i ručně psaná čísla obsahují vlnovky častěji, než by kdokoli čekal. Řádek a*b ukazuje druhou past: abc se chytne pro DSUM, ale ne pro COUNTIF, protože databázová funkce potichu přilepí *. Položky DSUM pro ab, a*b a =ab se měřily přímo nad Excel 16; položka DSUM pro a~b plyne z téhož prefixového pravidla, protože přilepená hvězdička * udělá z kritéria wildcard vzorec, ve kterém je ~b escapované b
Kdy COUNTIF přepne do wildcard módu?
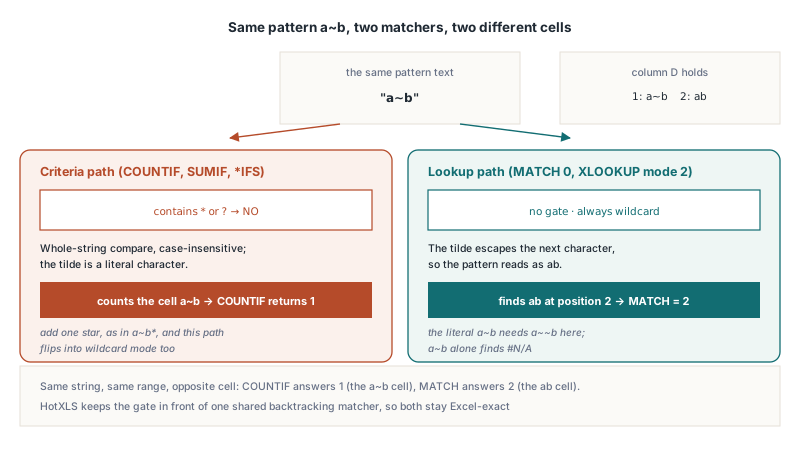
COUNTIF přepne do wildcard módu jen tehdy, když text kritéria obsahuje * nebo ?, escapované nebo ne. Bez ani jednoho z nich porovná Excel kritérium s každou buňkou jako celý řetězec, bez rozlišení velikosti písmen, a vlnovka je jen vlnovka, takže COUNTIF(A1:A7,"a~b") spočítá buňku, která doslova drží a~b. Přidejte jednu hvězdičku a význam se překlopí: v "a~b*" teď vlnovka escapuje b, vzorec se čte jako „ab následované čímkoli“ a buňka a~b se už nepočítá. HotXLS aplikuje tohle pravidlo v obou jádrech od v2.384.52, přes jeden matcher kritérií v lxCalc sdílený COUNTIF, SUMIF, AVERAGEIF, COUNTIFS, SUMIFS, AVERAGEIFS a databázovými funkcemi
Uvnitř wildcard módu jsou escape pravidla stejná jako všude jinde v Excelu: ~ udělá literál z dalšího znaku, ať už je jakýkoli, takže ~b znamená b a ~~ jednu vlnovku, a vlnovka na samém konci vzorce se zahodí, takže "a*~" se chová jako "a*". Hranaté závorky nejsou nikdy zvláštní. Kritérium "[x]" spočítá buňky držící tři znaky [x] a "[a-z]" nezahlédne nic na běžných datech. TXLSXWorkbook.Calculate vyhodnotí text formule nad aktivním listem a vrátí Variant, nejrychlejší cesta, jak tato pravidla ověřit na vlastních datech
uses
  System.Variants, lxHandleX;

const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;

  procedure Show(const Formula: string);
  begin
    Writeln(Formula, ' = ', VarToStr(Book.Calculate(Formula)));
  end;

begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Data');
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i, 1].Value := Names[i];
      Sheet.Cells[i, 2].Value := 1 shl (i - 1);  // 1, 2, 4 ... aby součet SUMIF jmenoval své řádky
    end;
    Sheet.Cells[8, 1].Value := 5;                // číslo; A9 zůstává prázdná

    Show('=COUNTIF(A1:A7,"a~b")');      // 1    žádné * ani ?: prostý text, buňka a~b
    Show('=COUNTIF(A1:A7,"a~b*")');     // 4    wildcard mód: ab, AB, abc, abcb
    Show('=COUNTIF(A1:A7,"a*b")');      // 6    wildcard přes celý řetězec, abc vynecháno
    Show('=SUMIF(A1:A7,"a*b",B1:B7)');  // 119  každý řádek kromě abc (8)
    Show('=COUNTIF(A1:A7,"a~*b")');     // 1    literál a*b
    Show('=COUNTIF(A1:A9,"<>ab")');     // 7    počítá se číslo 5 i prázdná A9
    Show('=COUNTIF(A1:A9,"<>")');       // 8    neprázdné buňky
  finally
    Book.Free;
  end;
end.
Co počítá „<>text“?
Kritérium "<>text" spočítá každou buňku, která není tím textem, a v Excelu 16 to zahrnuje čísla, booleany, chybové hodnoty a prázdné buňky. Holé "<>" je úplně jiná otázka: znamená „ne prázdná buňka“, takže vynechá prázdné buňky, ale spočítá každou hodnotu, včetně prázdného textu, který vrací formule jako ="". Starý kód HotXLS měl textové buňky správně, ale ne čísla: nerovnost Variant donutila Delphi převádět 'ab' na číslo, konverze hodila výjimku, handler ji spolkl jako „není shoda“ a číselné buňky potichu vypadly z počtu. Stranu prázdných buněk v tomhle příběhu, včetně toho, čemu se rovná prázdný operand v obyčejném srovnání, pokrývá jak HotXLS nakládá se srovnávacími řetězci, prázdnými buňkami a SUMIF
Proč MATCH najde ab, když hledáte a~b?
MATCH najde ab, když hledáte a~b, protože MATCH s typem shody 0 a XLOOKUP s match_mode 2 jsou ve wildcard módu vždycky, takže vlnovka je escape, i když vzorec neobsahuje žádné * ani ?. Excel 16 to potvrdí na dvoubuněčné oblasti držící a~b a ab: MATCH("a~b",D1:D2,0) vrátí 2 a na oblasti, která drží jen a~b, vrátí též volání #N/A. Chcete-li vyhledat doslovný text a~b, musíte napsat "a~~b". Mezitím COUNTIF(D1:D2,"a~b") nad těmiže dvěma buňkami vrátí 1 a spočítá tu druhou buňku. Tentýž řetězec, stejná oblast, opačná buňka
Proto HotXLS drží obě rozhodnutí odděleně, a ne za jediným vstupním bodem „najdi vzorec“. Matcher sám je sdílený: od v2.384.52 pouštějí MATCH, XLOOKUP i funkce kritérií tentýž backtracking matcher, se stejným zacházením s escapy a stejným pravidlem koncové vlnovky. Liší se jen brána před ním. Cesta kritérií se nejdřív ptá „obsahuje tenhle text * nebo ??“; cesta vyhledávání se neptá vůbec. Sloučení obou by spravilo jednu rodinu a rozbilo druhou a oba směry se kontrolují proti hodnotám Excel 16 v obou jádrech. Wildcard lookupy mají navíc vlastní podmínku: XLOOKUP odmítá wildcard párování kombinované s režimem binárního hledání, pravidlo popsané v průvodci HotXLS vyhledávacími módy XLOOKUP a XMATCH
Jak čtou DSUM a databázové funkce prosté textové kritérium?
DSUM a ostatní databázové funkce čtou textové kritérium bez úvodního =, < nebo > jako „začíná na“, s wildcardy stále aktivními. To je pravidlo Advanced Filter a záměrně se liší od COUNTIF. Měření nad Excel 16 se sloupcem Name držícím abc, ab, xab, AB, a~b a a*b: kritérium ab chytne abc, ab a AB; =ab chytne jen ab a AB; <>ab je nerovnost celé položky; a*b a a? jsou taky prefixové vzorce; >ab je obyčejné srovnání. Před v2.384.64 pároval HotXLS ab exaktně, takže DSUM nad těmi testovacími daty vrátila 10 tam, kde Excel vrací 11
Oprava si musela poradit s parserem podmínek, který smývá ab i =ab do stejné rovnostní podmínky. HotXLS proto prohlédne syrový text kritéria, dřív než věří rozparsované podmínce: textové kritérium, jehož první znak není =, < ani >, dostane přilepenou hvězdičku * a jde přes wildcard matcher, a všechno ostatní si nechá srovnání celé položky. Praktická poznámka, když stavíte oblasti kritérií v kódu: v XLSX jádru uloží přiřazení řetězce '=ab' do TXLSXCell.Value text, zatímco klasické jádro TXLSWorkbook zkompiluje hodnotu začínající na = jako formuli, nepředřadíte-li apostrof
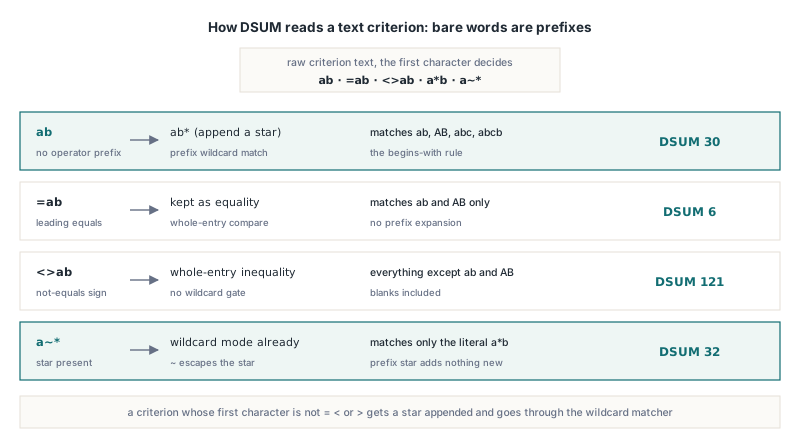
const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
  Criteria: array [0..4] of string = ('ab', '=ab', '<>ab', 'a*b', 'a~*');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Db');
    Sheet.Cells[1, 1].Value := 'Name';
    Sheet.Cells[1, 2].Value := 'Val';
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i + 1, 1].Value := Names[i];
      Sheet.Cells[i + 1, 2].Value := 1 shl (i - 1);
    end;
    Sheet.Cells[1, 4].Value := 'Name';            // hlavička kritérií v D1
    for i := 0 to High(Criteria) do
    begin
      Sheet.Cells[2, 4].Value := Criteria[i];     // zůstává textem v XLSX jádře
      Writeln(Criteria[i], ' -> ',
        VarToStr(Book.Calculate('=DSUM(A1:B8,"Val",D1:D2)')));
    end;
    // ab   -> 30   ab, AB, abc, abcb (začíná na)
    // =ab  -> 6    ab, AB (celá položka)
    // <>ab -> 121  všechno kromě ab a AB
    // a*b  -> 127  a*b* chytne všech sedm, abc včetně
    // a~*  -> 32   jen literál a*b
  finally
    Book.Free;
  end;
end;
Jeden příbuzný rozdíl přežil prefixovou opravu a občasí se na starších buildech. Textová srovnání jako >ab používala pořadí kódových bodů, zatímco Excel staví interpunkci před písmena, takže "a~b">"ab" je v Excelu FALSE a v HotXLS bylo TRUE. Od v2.384.67 užívají kritéria > a <, spolu s obyčejným srovnáváním textu a řazením, kolaci word sort Excelu pod aktuálním uživatelským locale a obě strany si zase rozumí
Proč celobuněčné Find minulo abcb?
Celobuněčné Find minulo abcb, protože matcher se zastavil v okamžiku, kdy se vzorec vybral, místo aby se vrátil zpět k poslední hvězdičce *. Matcher částečné shody za Replace končí, jakmile se vzorec vyčerpá; celobuněčné Find ho znovu použilo a pak vyžadovalo, aby shoda pokryla celou buňku: a*b nad abcb skončilo po ab, požralo 2 ze 4 znaků a bylo odmítnuto. Od v2.384.60 je celobuněčný matcher samostatná implementace, která bere „vzorec skončil, text ne“ jako jednu další neshodu a zkouší znovu od poslední hvězdičky, takže a*b chytne abcb a a?b*b chytne axbyb, jako to dělá Find v Excelu 16 se zaškrtnutým „Match entire cell contents“
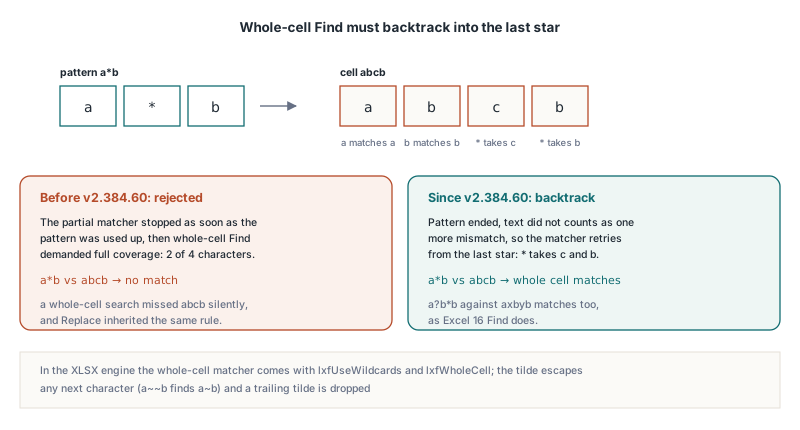
Týž release změnil vlnovku. Find v Excelu 16, v celobuněčném i částečném režimu, bere ~ jako escape pro jakýkoli následující znak: a~b najde ab, a~~b najde a~b a koncová vlnovka se ignoruje, takže q~ se chová jako q. Starší matcher HotXLS uznával za escapy jen ~*, ~? a ~~, takže a~b našlo text a~b. Vzor Find z jediné vlnovky ~ je nestabilní už v samotném Excelu, chytá každou buňku jako prázdný vzorec, a HotXLS to neimituje
V XLSX jádru je hledání TXLSXWorksheet.FindText se sadou TXLSXFindOptions: lxfUseWildcards zapne *, ? a ~, lxfWholeCell vyžaduje shodu celé buňky a lxfMatchCase udělá ze srovnání citlivé na velikost písmen. Bez lxfUseWildcards je každý znak, hvězdička nevyjímaje, literál. Find kouká jen na textové hodnoty; číselné buňky přeskakuje a buňky s formulemi taky, pokud není nastaveno lxfSearchFormulas, pak se hledá v textu formule. Kotva daná StartRow a StartCol je inkluzivní, takže smyčka Find All krokuje o sloupec za každým zásahem
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row, Col, NextRow, NextCol, Changed: Integer;
  Opts: TXLSXFindOptions;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Parts');
    Sheet.Cells[1, 1].Value := WideString('abc');
    Sheet.Cells[2, 1].Value := WideString('abcb');
    Sheet.Cells[3, 1].Value := WideString('a~b');
    Sheet.Cells[4, 1].Value := WideString('ab');

    Opts := [lxfUseWildcards, lxfWholeCell];
    if Sheet.FindText('a*b', Row, Col, Opts, 1, 1) then
      Writeln('a*b  whole cell -> row ', Row);   // 2: abc odmítnuto, abcb se vrátí zpět
    if Sheet.FindText('a~b', Row, Col, Opts, 1, 1) then
      Writeln('a~b  whole cell -> row ', Row);   // 4: ~b je escapované b
    if Sheet.FindText('a~~b', Row, Col, Opts, 1, 1) then
      Writeln('a~~b whole cell -> row ', Row);   // 3: ~~ je jedna doslovná vlnovka

    // Částečná shoda, Find All: kotvící buňka se počítá, krokujte za každý zásah
    NextRow := 1;
    NextCol := 1;
    while Sheet.FindText('a*b', Row, Col, [lxfUseWildcards], NextRow, NextCol) do
    begin
      Writeln('a*b  contained in row ', Row);     // řádky 1, 2, 3 a 4
      NextRow := Row;
      NextCol := Col + 1;
    end;

    // Celobuněčná wildcard náhrada přepíše jen literál a~b
    Changed := Sheet.ReplaceText('a~~b', 'a-b', Opts);
    Writeln(Changed, ' cell(s) replaced');         // 1
  finally
    Book.Free;
  end;
end;
Částečná smyčka najde všechny čtyři řádky, abc nevyjímaje, protože v částečném režimu musí a*b nastat jen někde uvnitř buňky. FindTextIn a ReplaceTextIn berou stejné volby plus okno FirstRow, FirstCol, LastRow, LastCol, programový ekvivalent hledání ve výběru. Klasické jádro vystavuje stejná pravidla přes přetížení se třemi booleany, TXLSWorksheet.FindText(SearchText, Row, Col, MatchCase, UseWildcards, WholeCell), plus odpovídající přetížení ReplaceText, s výsledky řádku a sloupce od jedničky:
var
  Classic: IXLSWorkbook;
  Sheet: TXLSWorksheet;
  Row, Col: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Sheet := Classic.Sheets.Add;
  Sheet.Range['A1', 'A1'].Value := 'abcb';
  // MatchCase = False, UseWildcards = True, WholeCell = True
  if Sheet.FindText('a*b', Row, Col, False, True, True) then
    Writeln('found at ', Row, ',', Col);           // 1,1
  if not Sheet.FindText('a*c', Row, Col, False, True, True) then
    Writeln('a*c does not cover abcb');
end;
Co všechno zkazil starý matcher s DOS maskou?
Starý matcher měl špatně zvláštní znaky, protože DOS souborová maska je jiný jazyk než Excel wildcard. Před v2.384.52 pouštěly funkce kritérií a databázové funkce každý vzorec do MatchesMask, matchera souborových masek v unitě lxMasks. Jeho syntaxe se s Excelovou v běžných případech překrývá, proto problém zůstal schovaný, ale rozeběhne se tam, kde začínají zajímavá reálná data:
[x]se četlo jako znaková množina, takžeCOUNTIF(A1:A10,"[x]")spočítalo buňky držícíxmísto textu v závorkách a"[a-z]"chytlo každou jednopísmennou buňku- Escape vlnovkou neexistoval, takže
"a~*b"nedokázalo chytit doslovnou hvězdičku - Deformovaná maska, jako nezavřená závorka, hodila výjimku, kterou volající spolkl jako „není shoda“, a překlep v kritériu se proměnil v potichu špatný součet
- Na vyhledávací straně braly
MATCHaXLOOKUPza escapy jen~*,~?a~~, takžeMATCH("a~b",…,0)našlo literála~bmístoab
Používají-li vaše sešity na holých alfanumerických datech jen * a ?, výsledky už byly správné a nezmění se. Obsahují-li hranaté závorky, vlnovky, sloupce smíšených typů pod "<>text" nebo kritéria DSUM psaná jako holá slova, přepočet s v2.384.64 a novější může změnit součty a nové součty jsou ty, které ukazuje Excel. Táž odlišnost mezi tím, jak Excel kritérium ukládá a jak ho srovnává, se vynoří u uložených filtrů, rozebraných v článku HotXLS o kritériích BIFF8 AutoFilter DOPER
Rychlý přehled: pravidla Excel wildcardů v HotXLS
COUNTIF,SUMIF,AVERAGEIFa rodina*IFSpoužívají wildcardy jen když kritérium obsahuje*nebo?; jinak srovnávají celé řetězce bez rozlišení velikosti písmen a~je literál (od v2.384.52)MATCHs typem shody 0 aXLOOKUPs match_mode 2 používají wildcardy vždycky, takžea~bnajdeaba pro literál je potřebaa~~b(od v2.384.52)- Ve wildcard módu
~escapuje jakýkoli další znak a koncová~se zahodí;[a]jsou obyčejné znaky "<>text"počítá čísla, booleany, chyby a prázdné buňky; holé"<>"počítá neprázdné buňky, výsledky=""včetněDSUMa ostatní databázové funkce berou prostý text jako „začíná na“;=texta<>textsrovnávají celou položku (od v2.384.64)- Celobuněčné Find s
lxfUseWildcardsalxfWholeCellse vrací zpět, takžea*bchytneabcb; Find a Replace berou~jako escape pro jakýkoli znak (od v2.384.60) - Pořadí textu v kritériích
>a<následuje kolaci word sort Excelu, interpunkce před písmeny (od v2.384.67)
Kompatibilita s Excelem ve vzorcovém jádru je z velké části takových okrajových případů, měřených proti Excelu, ne hádaných z dokumentace. HotXLS vyhodnocuje COUNTIF, MATCH, XLOOKUP, DSUM a zbytek své knihovny funkcí nativně v Delphi a C++Builderu, v klasickém i XLSX jádru, bez nainstalovaného Excelu. Detaily, edice a zkušební stažení najdete na stránce tabulkové komponenty HotXLS pro Delphi