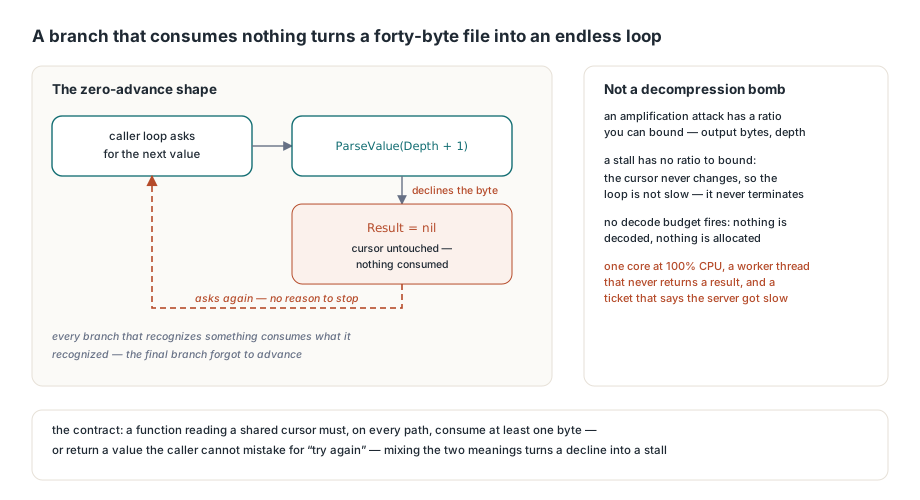
Parser zamrzne na poškozeném PDF, když nějaká větev přečte bajt, odmítne ho zpracovat a vrátí se, aniž by pohnula kurzorem. Volající smyčka nevidí žádný pokrok ani důvod zastavit, takže se točí věčně. HotPDF přesně touto vadou trpěl ve třech nezávislých parserech a všechny byly dosažitelné ze vstupů pod padesát bajtů
Tohle je třída denial-of-service, kterou stojí za to pojmenovat zvlášť, protože nevypadá jako ta, proti které se všichni už brání. Žádná dekomprese, žádný růst alokací, žádný tlak na paměť, který by spustil watchdog. Proces prostě sedí na sto procentech CPU na jednom jádře s hrstkou bajtů v bufferu. Když jste si po článku o amplifikaci vnořených filtrů a PDF bombách přidali decode budget, tady se nespustí: nic se nedekóduje a nic se nealokuje. Jiné selhání, jiná oprava
Proč stojí čtyřicetibajtový soubor víc než dekompresní bomba?
Protože náklady nemají se vstupem vůbec žádný vztah. Amplifikační útok má poměr, který dokážete ohraničit: omezte výstupní bajty, omezte hloubku rekurze a nejhorší případ je konečný. Smyčka s nulovým posunem nemá co ohraničit. Podmínka smyčky je funkcí kurzoru, který se nikdy nemění, takže není pomalá — je nekonečná, a žádný limit odvozený od velikosti ji nahoře nechytí. To z ní dělá i provozně unikátní svini. Crash vám dá stack, out-of-memory řádek v logu a zaseknutý parser vlákno, které nikdy nevrátí výsledek, požadavek, který nikdy nevyprší, protože nikdo níže neví, že začal, a tiket, že se v úterý zpomalil server. Strukturální příčina má pokaždé stejný tvar. Tokenizer nebo value parser má řetězec větví klíčovaných aktuálním bajtem. Každá větev, která něco pozná, spotřebuje to, co poznala. Pak je tu poslední větev, nebo stráž před řetězcem, která vrací pro bajty, které si nikdo nenárokoval, a autor ji chápe jako chybovou cestu, ne jako krok scanování. Chybové cesty vracejí. Scanovací kroky postupují. Když jedna funkce musí být obojí, zapomene se právě ten postup
Objektový parser: dva oddělovače, které nikdo nespotřeboval
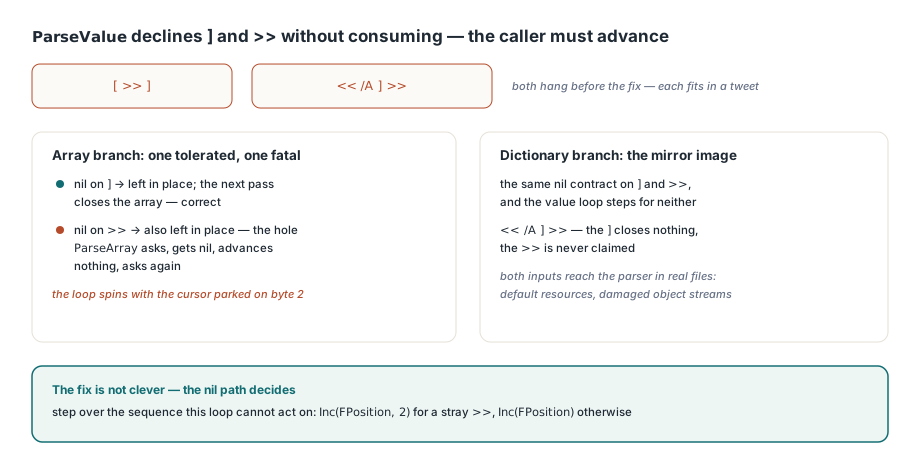
V HPDFParser metoda THPDFSpanObjectParser.ParseValue rovnou odmítá dvě sekvence bajtů. Podle ISO 32000-1 sekce 7.3 hodnota nemůže začínat na ] ani >>, protože ty zavírají kontejner, ne otvírají hodnotu, takže ParseValue pro obě vrací nil, aniž by je spotřeboval. To je správný kontrakt, jenže celé břemeno postupu leží na volajícím. Větev pole dodržela jen polovinu: při nil výsledku zkontrolovala ], nechala ho na místě, aby na příštím průchodu zavřel pole, a přeskočila všechno ostatní — jenže ta kontrola byla napsaná tak, že na místě zůstal i zatoulaný >>. Takže [ >> ] zamrzne, protože ParseArray žádá o hodnotu, dostane nil, nic neposune a ptá se znovu. Větev slovníku měla zrcadlově stejnou díru a << /A ] >> zamrzne stejně. Oba vstupy jsou dost platné, aby se dostaly k parseru, a dost krátké, aby se vešly do tweetu
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Před opravou se ani jedno z obou volání níže nevrátilo
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Oprava není chytrá, a o to jde: cesta nil musí výslovně rozhodnout, kterou z těch dvou nespotřebovaných sekvencí aktuální smyčka umí zpracovat, a tu druhou přeskočit
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue vrací nil pro ']' i '>>', aniž by je spotřeboval.
  // ']' zavře pole na příštím průchodu, ale zatoulaný '>>'
  // uvnitř pole je nutné přeskočit, jinak se parse nikdy neposune
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Ještě jedna věc si tu zaslouží pozornost. THPDFSpanObjectParser.RecordError jen zvyšuje ErrorCount v THPDFParserViewStatistics, nic neomezuje. Parser nastavuje HPDFParserMaximumDepth na 64, aby ohraničil vnoření, ale žádný ekvivalentní strop pro počet chyb nemá, a čítač, který nikdo nikdy nečte, je prošvihnutý circuit breaker. I s obnoveným postupem vstup, který produkuje jednu chybu na bajt, prokousá velký objekt tempem, které si zaslouží předčasný exit, ne celý průchod. Po každém parsu zkontrolujte Valid na statistickém záznamu a velké ErrorCount berte jako důvod přestat objektu věřit, ne jen jako diagnostiku
Stejný tvar v tokenizeru CMap a čtečce XFDF
HPDFCMapReader.NextToken nesl stejnou vadu ve své fallback větvi. Funkce vrací TCMapTok a <, ( a / obsluhuje vlastními větvemi; všechno ostatní propadne do "čti až do bílého znaku nebo oddělovače". Když je počáteční bajt sám oddělovač ze sady z ISO 32000-1 sekce 7.2.2, smyčka proběhne nula krát, token se vrátí prázdný a volající se ptá na stejný token znovu. Ze šesti znaků, které se tam mohou dostat, byl jen [ zachycen dřív obsluhou bfrange, takže zatoulaný ), >, ], { nebo } kdekoli v ToUnicode CMap stačil k zaseknutí extrakce textu
// keyword nebo číslo: čti až do bílého znaku nebo oddělovače
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Oddělovač, který si žádná z větví výše nenárokuje (zatoulaný ')', '>',
// '[', ']', '{' nebo '}'), by nechal P na místě a vrátil prázdný
// keyword, takže by volající žádal stejný token navždy
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
Strana XFDF měla variantu s jiným původem a stejným účinkem. HPDFXFDFXml.ParseElement nastaví nahoře Result := P, zatímco P ještě ukazuje na otvírací <, a teprve pak posune svůj lokální kurzor, takže každý předčasný exit, který následuje, vrací vstupní pozici, pokud Result předtím nepřepíše. Deklarace doctype podle XML 1.0 sekce 2.8, nebo cokoli jiného bez parsovatelného jména tagu, třeba <1a>, šla exitem, který Result nikdy neaktualizoval, a smyčka child elementů dostala pozici, kterou sama předala. Smyčka atributů měla další tři takové, protože ReadName, přeskočení bílých znaků i obsluha = odmítají bajt, který není znak jména, ani bílý znak, ani jeden z =, >, /, a žádná z nich ho nespotřebovala. Sousední oprava CDATA přesunula odpovědnost místo přidání stráže: sekce CDATA podle XML 1.0 sekce 2.7 začíná na <, takže ji child smyčka dřív předávala ParseElement, který pak z obsahu sekce četl jméno tagu. Rozpoznat ji v child smyčce přes IsCDATAStart a kopírovat bajty do textového bufferu až do IsCDATAEnd je správné rozdělení, a starý skip byl taky o jeden bajt krátký, protože marker má osm bajtů počítáno od !
Deklarované počty, které přežijí data
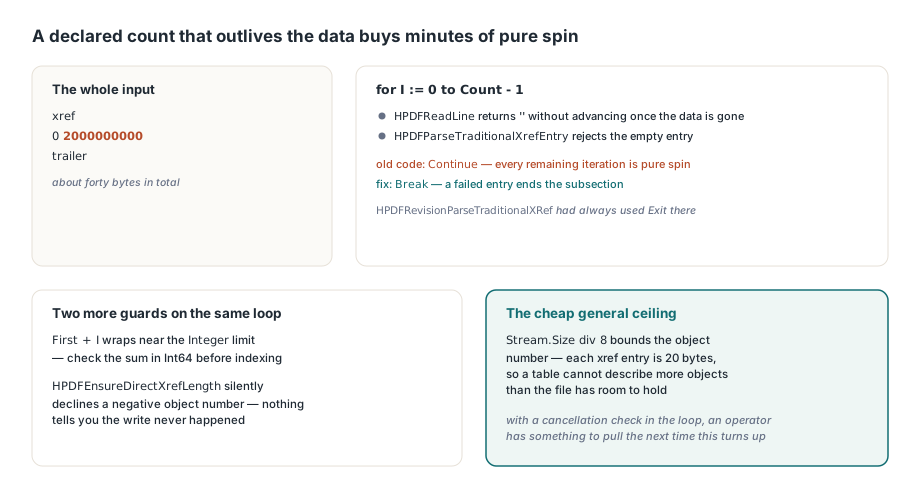
Pozdější release vynořil stejný vzor z opačné strany, a tohle je varianta, která nejspíš existuje i ve vašem kódu. Hlavička subsectionu křížové reference podle ISO 32000-1 sekce 7.5.4 je dvojice first count a oba tradiční xref parsery HotPDF přes ni cyklily for I := 0 to Count - 1 s Continue místo Break, když se nepodařilo naparsovat záznam. To vypadá jako tolerance jednoho špatného řádku. Není: HPDFReadLine vrací prázdný řetězec bez posunu, jakmile data dojdou, a HPDFParseTraditionalXrefEntry prázdný záznam okamžitě odmítne, takže každá zbývající iterace deklarovaného počtu je čisté protočení. Aritmetika je nevlídná — hlavička xref\n0 2000000000\ntrailer plus minimální obal je asi čtyřicet bajtů a koupí desítky sekund vytíženého jádra bez jediné kontroly zrušení v celé smyčce. Prozrazení sedělo ve stejném unit, protože HPDFRevisionParseTraditionalXRef na tom místě vždycky používal Exit. Když dvě funkce parsují stejnou gramatiku a neshodnou se v tom, jestli neúspěšný záznam končí subsection, jedna z nich je fork, který přestal dostávat opravy — stejný podpis, jaký se objevuje v hybridním zpracování křížových referencí, kde tradiční tabulka a stream popisují tytéž objekty
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Deklarovaný počet větší než tabulka by se tady jinak točil
  // bez dat, která by zbyla ke čtení
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First pochází z hlavičky subsectionu, takže součet se přeteče
  // pro deklarovaný začátek blízko limitu Integer a growth helper
  // tiše odmítne záporný index
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... zaznamenej záznam ...
end;
Ty dva limity za Break patří ke stejné opravě. HPDFEnsureDirectXrefLength odmítne zvětšit pole pro záporné číslo objektu a nic k tomu neřekne, a First + I se přeteče pro deklarovaný začátek blízko limitu Integer, takže záporný index dorazí až k zápisům níže. Strop čísla objektu Stream.Size div 8 je levná obecná odpověď, protože žádná tradiční tabulka křížových referencí nemůže popsat víc objektů, než se do souboru vejde, a každá hlavička tvrdící opak popisuje soubor, který neexistuje. Pokud ručně opravujete poškozenou tabulku, stejná úvaha platí z druhé strany, což je teritorium popsané v poznámkách o diagnostice a opravě ručně editovaných PDF
Jak dokázat, že oprava zamrznutí opravdu funguje?
Spuštěním starého kódu, ne jeho přečtením. Zaseknutí patří k té vzácné třídě vad, kde se oprava dá ověřit binárním signálem bez jakékoli instrumentace, protože proces buď vrátí výsledek, nebo ne, a uvažování o toku řízení je přesně ta dovednost, která tu chybu původně vyprodukovala. Mechaniku stojí za to okopírovat. Vytáhněte revizi změněných unitů před opravou do scratch adresáře a zkompilujte jeden malý probe s vyhledávací cestou unitů, která ten adresář staví před skutečnou knihovnu: dcc32 -U<scratchdir>;<Lib> probe.dpr. Kompilátor vezme staré zdrojáky pro to, co najde první, a aktuální zdrojáky pro všechno ostatní, takže jediná probe binárka zkouší starý parser proti zbytku knihovny. Spusťte ho s timeoutem — čtyřicet sekund je velkorysých — a exit code 124 berte jako assertion. Pak odebírejte unity ze scratch adresáře jeden po druhém a znovu build. Všechna tři zaseknutí se takto reprodukovala, každé přiřaditelné konkrétnímu unit, a všechna tři zmizela, jakmile se opravený zdroják vrátil do cesty, za cenu jednoho kompilování na unit
Než to zkusíte, stojí za to znát dvě pasti. Vyhledávací cesta unitů je tiše shovívavá: dejte -U Unixovou cestu ze shellu, třeba $PWD, a kompilátor ten adresář ignoruje beze slova, což znamená, že váš probe se zkompiloval proti aktuálním zdrojákům a prošel z nesprávného důvodu. Cestu nejdřív převeďte do nativní Windows podoby. Druhá past: scratch adresář nenese include soubory, takže potřebujete i -I<Lib> pro HotPDF.inc, jinak build selže způsobem, který vypadá jako problém zdrojáku, ne cesty. A buďte upřímní k tomu, co metoda nedává: potvrdí, že konkrétní vstup přestal viset na konkrétním buildu, a neřekne nic o vstupech, které vás nenapadly. Vady s nulovým posunem se nacházejí fuzzingem nebo čtením každé větve každého tokenizeru, ne regresními testy psanými dodatečně
Co auditovat ve vlastních parserech
Použitelné pravidlo je kontrakt, ne položka checklistu. Jakákoli funkce, která čte ze sdíleného kurzoru, musí na každé cestě, včetně chybových, buď spotřebovat aspoň jeden bajt, nebo vrátit hodnotu, kterou si volající nemůže splést s "zkus to znovu". Smíchat ty dva významy do jediného nil nebo jediného prázdného tokenu je přesně to, co z odmítnutí dělá zaseknutí. Takže auditujte tvar, ne symptom. Najděte každou smyčku, jejíž ukončení závisí na kurzoru, který vlastní jiná funkce, a ptejte se, co se stane, když ta funkce aktuální bajt odmítne. Najděte každou fallback větev napsanou jako "čti až do X" a ptejte se, co udělá, když kurzor už na X sedí. Najděte každou smyčku ohraničenou počtem, který přišel ze souboru, ne z dat, a nechte neúspěšný element smyčku ukončit místo přeskočení iterace. Kde se stejná gramatika parsuje na dvou místech, porovnejte je, protože jedno z nich dostalo opravu, kterou druhé nedostalo. A do každé smyčky, která může běžet tolik iterací, kolik jich volající zadá, dejte kontrolu zrušení, aby operátor měl co zatáhnout, až se tahle další objeví v produkci
Parsery popsané tady se dodávají v aktuálním HotPDF Delphi Component pro Delphi a C++Builder, se zpřístupněnými statistickými záznamy a limity hloubky, aby na nich vaše vlastní zpevňování mohlo stavět