HotPDF umí uložit načtený dokument v diagnostické formě určené k tomu, aby ji člověk mohl číst a upravovat, a pak soubor po vaší úpravě opravit. SaveLoadedDocumentDiagnostic zapíše dokument s deterministickým řazením klíčů slovníku, každým objektem jako běžným nepřímým objektem, bez objektových streamů, bez cross-reference streamu a bez linearizace. RepairDiagnosticDocument pak znovu sestaví bajtové offsety, délky streamů, tabulku cross-reference a trailer, které vaše úprava zneplatnila
Tato dvojice existuje pro jeden konkrétní workflow: pochopit nebo opravit, co je uvnitř PDF skutečně. Každý vývojář, který kdy ladil problém s vykreslováním, chtěl otevřít soubor, změnit jedno číslo v jednom slovníku a podívat se na výsledek. V běžném PDF je to nemožné, protože obsah je komprimován do objektových streamů a každý bajt, který vložíte, posune offsety, které tabulka cross-reference zaznamenává přesně
Čím se diagnostické uložení liší?
Šest nastavení se mění společně. Klíče slovníku se zapisují v deterministickém pořadí, takže dvě uložení stejného dokumentu vytvoří porovnatelné soubory. Diagnostický výstupní režim anotuje strukturu. Vynutí se plný přepis, takže se nic nepřevezme jako netknutá inkrementální revize. Linearizace je vypnutá, protože linearizovaný soubor je organizovaný pro webový prohlížeč, ne pro čtenáře. Cross-reference streamy jsou vypnuté, takže tabulka je čistý text. A objektové streamy jsou vypnuté, takže žádný objekt není skrytý uvnitř komprimovaného kontejneru
Výsledkem je soubor, jehož hlavička nese diagnostický marker vedle obvyklé signatury %PDF- a jehož tělem lze v libovolném editoru listovat. Objekty se objevují jeden za druhým, slovníky jsou čitelné a obsahové streamy jsou tam, kde je najdete. Opravný nástroj kontroluje přítomnost tohoto markeru a odmítá soubory, které ho postrádají, protože kompaktní strukturu běžného PDF by opravář pracující s bajtovými rozsahy neměl interpretovat

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Čitelné, jeden objekt na blok, nic skrytého v objektových streamech
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Proč úprava rozbije soubor a co se musí znovu sestavit?
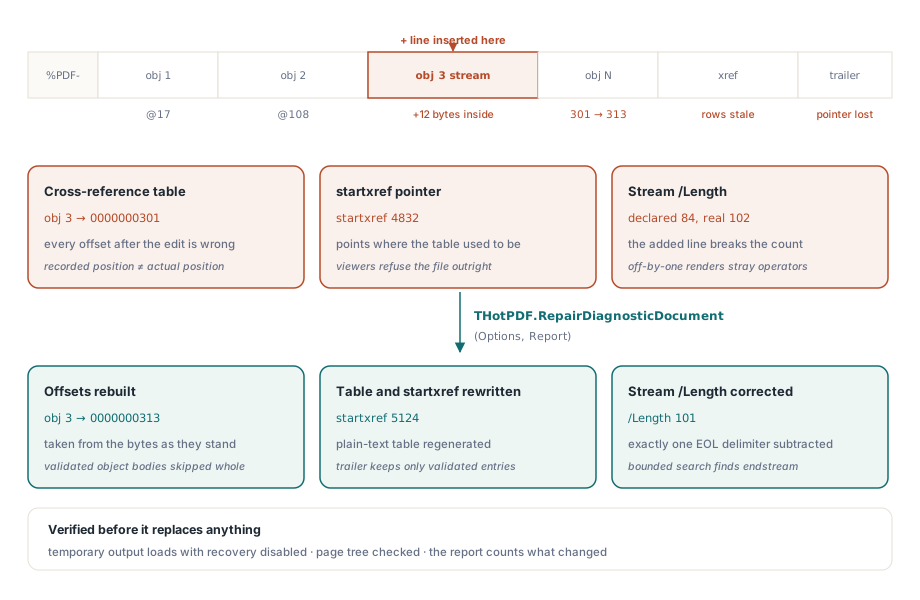
Tři věci v PDF kódují bajtové pozice nebo počty bajtů. Tabulka cross-reference mapuje každé číslo objektu na bajtový offset. Hodnota startxref na konci souboru ukazuje na tabulku. A každý slovník streamu nese /Length, kolik bajtů zabírá tělo streamu
Změňte jeden znak kdekoli před koncem souboru a offsety za ním jsou špatně. Přidejte řádek do obsahového streamu a jeho /Length je také špatně. Většina prohlížečů takový soubor odmítne a ty, které ho zachrání, to udělají skenováním, což chybu spíš skryje, než opraví. Oprava znovu sestaví všechny tři z toho, co bajty teď skutečně říkají
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // před nahrazením výsledek načíst

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Kopírovat bajty, ne reserializovat
Konstrukční rozhodnutí, které dělá tento nástroj důvěryhodným, je, že nikdy nenačte dokument a nezapíše ho znovu. Kopíruje bajtové rozsahy objektů, které ověřil, mění pouze hodnoty /Length, které jsou špatné, a kolem nich znovu sestaví tabulku, trailer a startxref
Načtení a reserializace by se implementovaly mnohem snáz a tiše by měnily věci. Neznámá syntaxe objektů by se normalizovala, escapování řetězců by se přepsalo do preferované formy zapisovače a už zakódované obsahy streamů by se mohly znovu zakódovat. Pro ladicí nástroj je to nepřijatelné: upravili jste jedno číslo a diff by měl ukázat jedno číslo, ne tisíc vedlejších formátovacích změn. Pokud chcete přesně vědět, co se mezi dvěma soubory změnilo, je to problém porovnávání, popsaný v článku porovnávání dvou souborů PDF podle struktury a pixelů

Dvě pravidla parsování, která zabraňují falešným objektům
Skener bajtových rozsahů čelí zjevné pasti: text, který vypadá jako hlavička objektu, se může objevit uvnitř obsahu streamu nebo uvnitř řetězce. Naivní sken by vyprodukoval řádek cross-reference ukazující doprostřed obsahového streamu a výsledný soubor by byl rozbitý novým a matoucím způsobem
HotPDF se tomu vyhýbá tak, že přeskočí celý bajtový rozsah každého ověřeného objektu pomocí jeho zaznamenaného koncového offsetu, takže nic uvnitř těla objektu se nikdy nepovažuje za kandidáta. Mezi objekty je povolen jen bílý znak a komentáře PDF; cokoli jiného znamená, že oblast není rozpoznaná a její bajty se nesmí protáhnout do výstupu
Délky streamů vyžadují stejnou péči. Skutečná délka payloadu vylučuje oddělovač konce řádku, který zapisovač vkládá před endstream. Když deklarovaná délka přistane přesně na markeru, deklarace se přijme. Když ne, opravář provede omezené hledání dvojice endstream a endobj a odečte přesně jeden oddělovač, CR, LF nebo CRLF. Chyba o jeden bajt zde vytvoří soubor, který se otevře a vykreslí stránku s jedním zbloudilým operátorem na konci svého obsahového streamu
Co si trailer smí ponechat
Znovu sestavený trailer není kopií starého. /Size, /Prev a /XRefStm všechny popisují předchozí rozvržení souboru a přepočítají se nebo se zahodí. Přežijí jen položky, jejichž cíle byly ověřeny: /Info, /ID a /Encrypt. A /Root se musí rozřešit přesně na jeden objekt Catalog — ne na nulu a ne na několik, což je to, co má sklon produkovat soubor sestavený kopírováním a vkládáním bloků objektů
Bezpečnost výstupu je řešená tak, jak by měla být pro nástroj, který pracuje se soubory, na kterých lidem záleží. Výsledek se zapíše do dočasného souboru v cílovém adresáři a pak se ověří jeho načtením obvyklou cestou s vypnutým obnovením cross-reference, takže soubor, který se otevře jen díky obnově, se počítá jako selhání. Teprve poté, co se ověří strom stránek, dočasný soubor atomicky nahradí cíl. Neúspěšná oprava nikdy nepřepíše existující výstup
Rozpočty a čestné kódy selhání
Práci omezují tři limity: vstupní bajty, počet kandidátských objektů a maximální číslo objektu, ve výchozím nastavení 8 GiB, dva miliony a dva miliony. Strop pro číslo objektu má větší význam, než se zdá, protože řídká tabulka s několika objekty číslovanými v miliardách by jinak enormně nafoukla znovu sestavenou tabulku cross-reference. Klasické tabulky cross-reference také odmítají offsety, které by potřebovaly více než deset desítkových číslic, což je omezení formátu, ne implementační volba
Selhání hlásí konkrétní stav místo pouhého booleanu: neplatné argumenty, zdroj příliš velký, není diagnostický soubor, překročen limit objektů, neplatný objekt, duplicitní objekt, chybějící katalog, neplatný trailer, chyba výstupu, nebo selhala validace. Každý se mapuje na jinou opravu. Duplicitní objekt znamená, že jste blok objektu vložili dvakrát. Chybějící katalog obvykle znamená, že byl poškozen objekt nesoucí /Type /Catalog. Selhaná validace znamená, že struktura je nyní konzistentní, ale strom stránek se nenačte, což bývá pole /Kids upravené nesouhlasně se svým /Count
Dvě praktické poznámky na závěr. Ponechte si diagnostický soubor, ne jen ten opravený, aby další úprava vycházela z čitelného základu. A nevydávejte diagnostický výstup koncovým uživatelům: je větší než běžné uložení, protože nic není komprimováno do objektových streamů, a produkční cestou pro kompaktní soubor je běžná cesta uložení popsaná v článku objektové streamy a inkrementální aktualizace. Když je cílem zjistit, co je špatně, spíš než to změnit, automatizovaná cesta v článku automatizace preflight reportu odpoví rychleji než čtení bajtů
Diagnostické ukládání, oprava, preflight a porovnávání pracují v Delphi a C++Builder na stejném modelu načteného dokumentu; úplný seznam funkcí najdete na stránce komponenty HotPDF Delphi PDF component