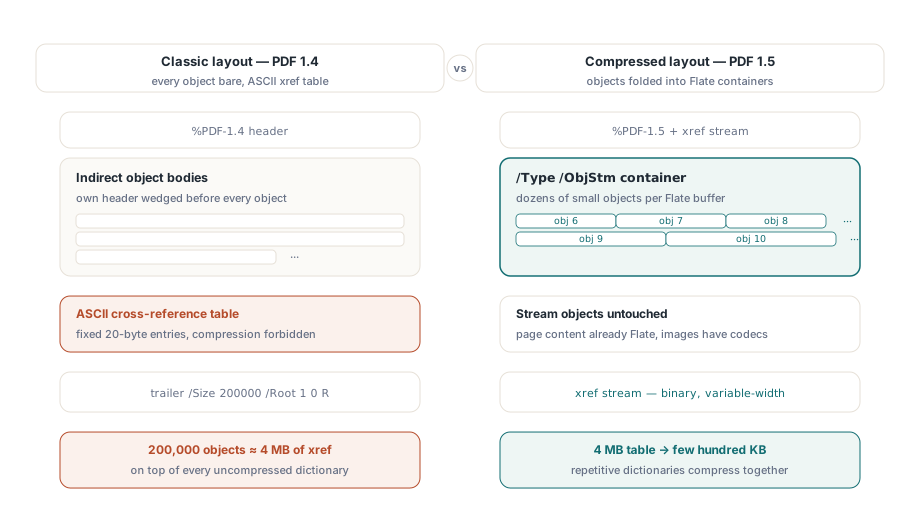
PDF 1.5 zavedlo dvě úložné struktury, které starší formát souboru neměl jak vyjádřit: object stream a cross-reference stream. Object stream je jeden Flate-komprimovaný kontejner, označený /Type /ObjStm, který drží mnoho malých nepřímých objektů natěsno naskládaných za sebou místo jejich roztroušení po těle souboru. Cross-reference stream je vyhledávací tabulka souboru přepsaná jako komprimovaná binární data s poli proměnné šířky, místo tabulky ASCII s pevnou šířkou, kterou se uzavíral každý PDF až do verze 1.4. Cestují spolu. Jakmile jsou objekty sbaleny do streamu, stará textová tabulka je už nedokáže adresovat, takže binární xref musí jít s nimi
Postavte to vedle klasického rozvržení a náklady, které to odstraňuje, jsou snadno vidět. V souboru PDF 1.4 sedí každý nepřímý objekt nekomprimovaný za vlastní hlavičkou obj a tabulka na konci spotřebuje přesně 20 bajtů ASCII na položku, komprese zakázána. Dokument s 200 000 objekty nese zhruba 4 MB dat cross-reference dřív, než je nakreslen jediný glyf, se všemi nekomprimovanými těly slovníků navrch. PDF 1.5 útočí na obě čísla najednou: slovníky se sbalí do kontejnerů Flate a 4MB tabulka se scvrkne na pár set kilobajtů binárních dat. ISO 32000-1 definuje obě struktury v §7.5.7 a §7.5.8
Kde se úspora skutečně projeví
Object streamy se dotýkají jen ne-streamových objektů, takže komprimují strukturu, ne pixely. Obsah stránky byl Flate-komprimovaný už před verzí 1.5 a obrazová data nesou vlastní kodeky, což je důvod, proč obrazově těžká brožura sotva hne s velikostí. Soubory, které se skutečně smrsknou, jsou ty se silnou strukturou: AcroForms s tisíci slovníky polí, hluboké stromy záložek, strukturní prvky tagged PDF. Tyto objekty jsou drobné, početné a téměř identické mezi sebou, a přesně tuto opakovatelnost Flate využívá, jakmile sedí v jednom bufferu místo rozptýlení po těle s hlavičkami vklíněnými mezi nimi
Je snadné podcenit, jak velká část starého souboru je jen režie. Archiv formulářů, který nasál roky úprav, může utratit přes polovinu svých bajtů na hlavičky slovníků, výplň xref a revize, na které se žádná čtečka nikdy nepodívá. Obě funkce popsané zde získávají zpět první dvě z těchto věcí. Třetí, nahromaděné revize, ustoupí jen zhutnění, jakmile si soubor už nemusí pamatovat vlastní historii
V HotPDF obě zapnete přes dvojici vlastností, a to, jak na sobě závisí, je důležitější než pořadí, ve kterém je zapíšete:
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'catalog-2026.pdf';
    Pdf.UseXRefStream := True;      // binární xref, předpoklad pro ObjStm
    Pdf.UseObjectStreams := True;   // sbalí objekty do /Type /ObjStm
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 11);
    Pdf.CurrentPage.TextOut(50, 760, 0, 'Compressed structure demo');
    Pdf.EndDoc;                     // vygeneruje kontejnery XRefStm + ObjStm
  finally
    Pdf.Free;
  end;
end;
UseObjectStreams potřebuje mít UseXRefStream nastavené na True. Ke komprimovanému objektu se přistupuje přes záznam xref typu 2, který zaznamenává číslo object streamu plus index, a klasický 20bajtový textový řádek nemá kam tuto dvojici uložit. Takže UseObjectStreams samo o sobě nedělá nic viditelného; funkční konfigurací jsou oba příznaky nastavené před BeginDoc. Nastavte je po BeginDoc a HotPDF se už zavázal ke staršímu rozvržení
Proč jsou obě ve výchozím stavu vypnuté
HotPDF ponechává obě vlastnosti přímo z výroby na False, a důvod se projeví v integracích se starým navazujícím kódem. Čtečka, která rozumí jen PDF 1.4, neoznámí, že si neporadí s komprimovanými objekty. Narazí na xref stream, nenajde žádné z klíčových slov trailer, která čeká, a nahlásí poškozenou tabulku cross-reference, nebo soubor prostě odmítne otevřít. Pokud váš výstup putuje do stárnoucí faxové brány, hardwarové tiskárny s vestavěným interpretem, nebo parseru, který někdo napsal proti specifikaci 1.4 před deseti lety, nechte pro tento kanál oba příznaky vypnuté a smiřte se s větším souborem. Pro archivní úložiště a doručování na web, kde každý běžný prohlížeč čte PDF 1.5 už dvacet let, je jejich zapnutí komprese téměř zadarmo
Existuje efekt druhého řádu, o kterém stojí za to informovat váš support tým. Jakmile jsou slovníky sbalené do object streamů, porovnávání dvou generovaných souborů bajt po bajtu přestává cokoli znamenat, protože změna jediného pole může znovu zflatovat celý kontejner a zamíchat vším za ním. Takové soubory diffujte podle obsahu objektů, ne binárním porovnáním
Přírůstkové aktualizace a offsety bajtů, které chrání
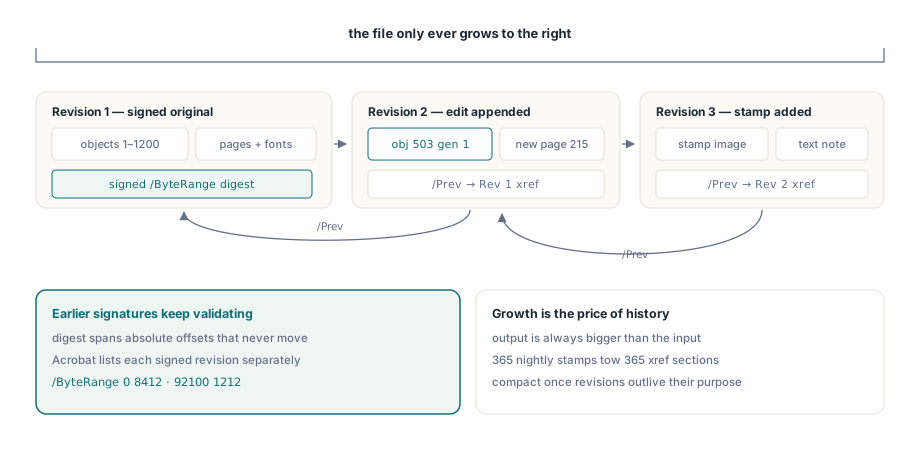
Digitální podpis pokrývá explicitní /ByteRange: dva úseky fyzického souboru, uvedené jako absolutní offsety bajtů, přes které byl vypočten digest CMS. Přepište soubor, byť do něčeho, co na obrazovce vypadá identicky, a všechny tyto offsety se posunou. Digest přestane sedět a podpis se čte jako poškozený. Přesně tento problém řeší ISO 32000-1 §7.5.6 pomocí přírůstkových aktualizací. Nové a změněné objekty se připojí za existující %%EOF, pak se zapíše čerstvá sekce cross-reference, jejíž položka /Prev ukazuje zpět na tu předchozí. Původní bajty se nikdy nedotknou, takže podepsaná revize zůstává ověřitelná a Acrobat dokáže v panelu podpisů prezentovat každou podepsanou revizi samostatně
HotPDF to zpřístupňuje přes vlastní vstupní bod:
Pdf.BeginIncrementalUpdate('contract-signed.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Addendum recorded 2026-06-11');
Pdf.SaveIncrementalUpdate('contract-updated.pdf');  // připojí jen deltu
Dvě věci lidem podrážejí nohy. BeginIncrementalUpdate musí dostat název původního souboru, protože připojená sekce xref zaznamenává offsety, které dávají smysl jen proti přesně těm původním bajtům; namiřte jej na přejmenovanou nebo znovu uloženou kopii a offsety popíšou soubor, který už neexistuje. A uložení je z podstaty append-only, takže výstup je vždy větší než vstup. Tento růst není plýtvání, které by se dalo odladit pryč. Je to stejná vlastnost, díky které zůstávají dřívější podepsané revize nedotčené
Úprava načteného souboru vede přes LoadFromFile
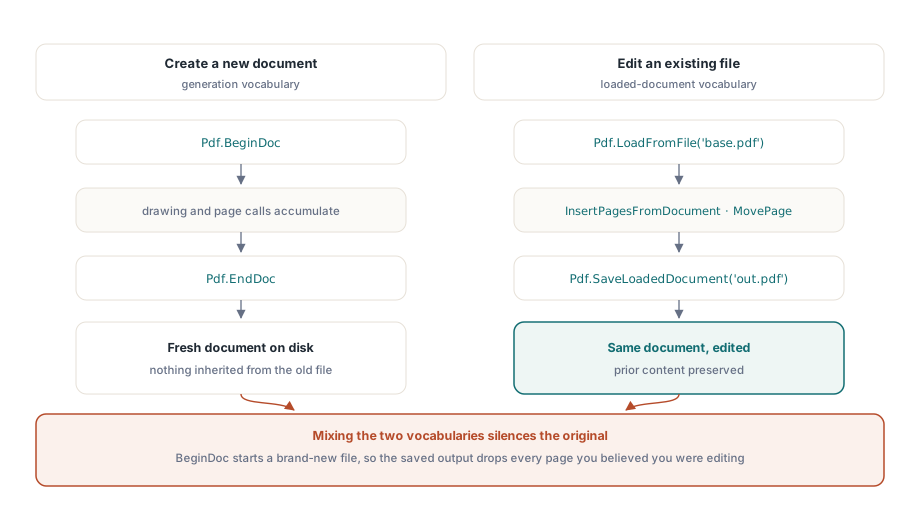
Vývojáři, kteří se s HotPDF poprvé seznámili přes generovací API, mívají sklon narazit na konkrétní zeď. BeginDoc otevírá zbrusu nový dokument, což je špatný nástroj ve chvíli, kdy chcete změnit ten, který už existuje. Úprava existujícího souboru místo toho vede přes volání pro načtený dokument:
PageCount := Pdf.LoadFromFile('base.pdf');
Pdf.InsertPagesFromDocument(OtherDoc, '1-3', 5);  // stránky 1-3 za stránku 5
Pdf.MovePage(2, 5);
Pdf.SaveLoadedDocument('modified.pdf');
Smíchejte tyto dva a příznakem je výstupní soubor, který drží váš nový obsah a nic z originálu, protože BeginDoc spokojeně postavil čerstvý dokument vedle toho, o kterém jste si mysleli, že jej upravujete. Čtěte LoadFromFile a SaveLoadedDocument jako jednu slovní zásobu a BeginDoc a EndDoc jako druhou. Rutina, která proti stejnému souboru sáhne po obou, je téměř vždy chybná
Kdy zhutnit soubor s připojenými aktualizacemi
Ukládání append-only nese pomalu narůstající náklady. Noční úloha, která orazítkuje jeden stavový řádek do stejného PDF, vyprodukuje za rok 365 revizí a každá revize s sebou táhne novou sekci xref. Jakmile tato historie přežije svou užitečnost a žádný podpis v souboru nepotřebuje přežít, můžete celou věc zploštit opětovnou serializací přes cestu pro načtený dokument:
Pdf.LoadFromFile('stamped.pdf');
Pdf.SaveLoadedDocument('compacted.pdf');
Toto opětovné uložení je úplný přepis. Záměrně zahazuje předchozí revize a rozbije jakýkoli podpis, který v souboru ještě je, takže jej postavte za stejnou bránu politiky, kterou používáte pro jakýkoli jiný destruktivní krok. Jedno produkční pravidlo, které funguje: zhutněte, když počet revizí překročí práh, nebo když připojená režie naroste přes nějaký podíl základního souboru, a nikdy nezhutňujte dokument, jehož panel podpisů obsahuje cokoli
Kontrola výstupu, než se odešle
Ověření této dvojice funkcí je osvěživě konkrétní. Otevřete výsledek v Adobe Acrobatu a potvrďte tři body: vlastnosti dokumentu hlásí PDF 1.5 nebo novější, jakmile jsou object streamy zapnuté; panel podpisů stále ověřuje každou dříve podepsanou revizi po přírůstkové aktualizaci; a počet stránek a záložky prošly cyklem načtení, úpravy a uložení nepoškozené. U archivního výstupu prožeňte soubor i přes veraPDF, protože komprimovaný xref je přesně ten typ struktury, kterou přísný validátor prozkoumá důkladněji, než kdy udělá shovívavý prohlížeč. Pokud vaše práce zahrnuje i velmi velké vstupy, inspekční metody z našeho průvodce Direct File API pro workflow s velkými PDF se přirozeně doplňují s přírůstkovým ukládáním, a mechanika podpisů za výše uvedenými rozsahy bajtů je do hloubky rozebraná v článku HotPDF o digitálních podpisech a PAdES
Obě funkce jsou součástí HotPDF Delphi Component pro Delphi a C++Builder, vedle API pro generování, formuláře, šifrování a podepisování probíraných jinde na tomto blogu. Produktová stránka odkazuje na úplnou referenci API, pokud si chcete výše uvedená volání porovnat s vlastním pipeline pro dokumenty