Otevřete PDF, které vyprodukoval Microsoft Word nebo Excel, prolistujte si ho a neuvidíte nic neobvyklého. Načtěte ho do programu v Delphi, přečtěte počet stránek a číslo bude správné. Potom jej znovu uložte se zapnutým šifrováním a úloha selže s chybou EListError, nebo se výstup otevře s varováním o poškozených křížových odkazech (cross-reference). Soubor přitom nikdy nebyl poškozený. Jde o hybridně referenční soubor (hybrid-reference) a stejná struktura, která umožňuje patnáct let starému prohlížeči jeho otevření, je přesně ta struktura, která porazí zavaděč (loader), který přestane číst příliš brzy
Toto je jeden z nejčastějších způsobů, jak se PDF pipeline, jež prošla všemi interními testy, setká se souborem, který nedokáže znovu zpracovat a uložit (round-trip). Všechny vstupní soubory byly do té doby generovány interně (in-house), takže nikdy nebyly hybridní. První hybridní soubor dorazí v den, kdy zákazník přepošle fakturu exportovanou z tabulkového procesoru
Co Word a Excel vlastně zapisují
Norma ISO 32000-1 popisuje hybridně-referenční uspořádání v §7.5.8.4. Aplikace, která vyžaduje funkce PDF 1.5, jako jsou objektové proudy (object streams), a zároveň chce umožnit čtečce PDF 1.4 otevřít soubor, zapisuje křížové odkazy dvakrát. Existuje klasická tabulka křížových odkazů – řádky ASCII o pevné šířce, které ukončovaly každé PDF až do verze 1.4 – a křížový odkazovací proud (cross-reference stream), který indexuje zbytek. Informace na konci dokumentu (trailer) u klasické sekce nese položku /XRefStm, jejíž hodnotou je bajtový ofset daného proudu
Toto rozdělení práce je záměrné. Objekty, ke kterým se musí starší čtečka dostat (jako například katalog nebo strom stránek), jsou adresovatelné z klasické tabulky. Objekty, které byly sbaleny do komprimovaných objektových proudů, jsou v klasické tabulce označeny jako volné položkou s typem f, takže je čtečka 1.4 prostě přeskočí a nikdy neklopýtne o strukturu, kterou nedokáže rozparsovat. Jejich skutečná umístění žijí pouze v křížovém odkazovacím proudu. Poznávacím znamením takového souboru je jeho samotný konec (tail): krátká klasická sekce, často jen slovo xref následované hlavičkou podsekce 0 0, jejíž trailer odkazuje na /XRefStm, kde sedí skutečná data pro obnovu
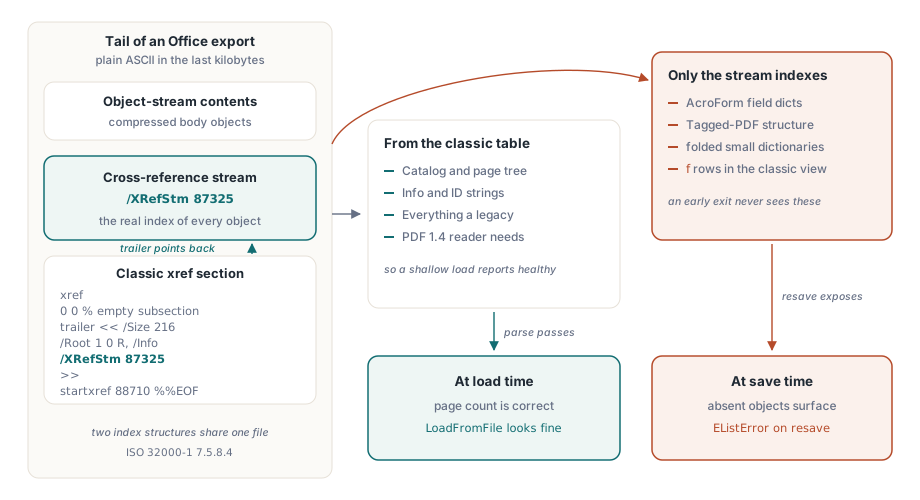
/XRefStm, zatímco streamová strana drží skutečný index objektůProč správný počet stránek nic nedokazuje
Protože katalog a strom stránek jsou schválně dostupné z klasické tabulky, zavaděč, který čte pouze tuto tabulku, najde /Root, projde strom stránek a ohlásí správný počet stránek. Vše, co stará čtečka potřebuje, je na místě, takže se soubor zdá být v pořádku. Chybějící objekty jsou ty, které byly zabaleny do objektových proudů: slovníky polí AcroForm, strukturní prvky pro tagged-PDF, nekonečná spousta malých slovníků, které legacy prohlížeč nikdy nemusel vidět
Tuto mezeru nezaznamenáte, dokud na tyto objekty něco nesáhne a kompletní opětovné uložení (resave) sáhne na všechny. Procházení dokumentu za účelem opětovného zašifrování nebo přepsání je přesně ta operace, která si vyžádá postupně každé číslo objektu, a to je ten důvod, proč se symptom objeví až při uložení a nikoli při načítání, tedy daleko od své příčiny
Past spočívá v detektoru, který uvidí xref a skončí
Laciným způsobem, jak rozhodnout, jak je soubor indexován, je sledovat startxref a zkontrolovat první bajty, na které odkazuje. Klíčové slovo xref znamená klasickou tabulku; stream objekt znamená křížový odkazovací proud. Tento test je správný pro každý soubor, který se zavazuje k jednomu ze schémat. U hybridního souboru je ale chybný, protože jeho startxref míří na klasickou sekci z jediného důvodu: uspokojit starší čtečky, přičemž ale /XRefStm v traileru této sekce je místem, kde je fakticky indexována většina dokumentu. Detektor, který na prvním zjištěném slově xref vrátí odpověď "klasický", už /XRefStm nikdy nečte a všechny objekty, které žijí pouze v proudu, se tak stávají neviditelnými
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // počet je správný
    // zde prohlédněte nebo upravte načtený dokument
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // prochází každý objekt
  finally
    Pdf.Free;
  end;
end;
Když je ve hře detektor, který svou práci brzy vzdá (early-exit detector), načítání vypadá v pořádku a opětovné uložení (resave) je místem, kde se chybějící objekty začnou hlásit o slovo. Řešením však není číst na začátku více bajtů; řešením je rozpoznat hybridní trailer a sledovat cestu za /XRefStm předtím, než se rozhodnete, že zpracování souboru je hotové
Pořadí sloučení nelze obejít (Merge order is not negotiable)
Jakmile jsou načteny oba indexy, mohou být sloučeny (merged) pouze jedním směrem. Křížový odkazovací proud musí být sloučen jako první a klasické položky se kolem něj musí vyplnit. Důvodem je drobný klam v samotném srdci tohoto formátu. Hybridní soubor označí v klasické tabulce své komprimované objekty jako volné, aby je staré čtečky ignorovaly. Zavaděč (loader), který ctí pravidlo „první vyhrává“ (first-seen-wins policy) a přečte klasickou tabulku jako první, zaznamená tato čísla objektů jako volná, a potom vyhodí položky z proudu, které je ve skutečnosti lokalizují, protože daná místa (slots) už jsou zkrátka obsazená. Otočte pořadí a z proudu získané záznamy typu 2 (což je vždy číslo objektového proudu plus příslušný index) si vybojují místa, která jim měla patřit, a teprve kolem nich se poskládají klasické záznamy
Stejná disciplína je ochranou před staršími revizemi křísícími už dříve smazané objekty. Inkrementální updaty se totiž řetězí pozpátku skrze parametr /Prev a prázdný záznam typu 0 je onou zmíněnou ochranou (sentinel), že některá novější sekce odeslala číslo objektu do penze. Nelze dopustit, aby pozdější starší sekce v řetězci tento hlídací prvek přepsala zastaralým (stale) umístěním. Když k principu "první vyhrává" přistoupíte autoritativně u všech zjištěných značek pro uvolněné bloky, tak smazané prostě zůstanou smazané; pokud k němu ale přistoupíte lehkovážně, tak i pouhá vlastní historie souboru dokáže oživit obsah smazaný v nejnovější revizi
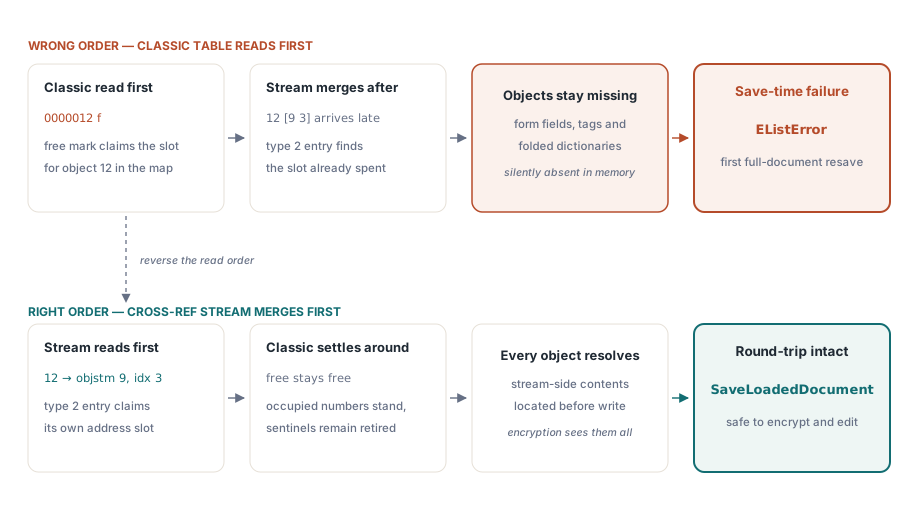
Co to znamená u HotPDF
Tento engine za vás řeší hybridně-referenční soubory a dělá to na každé cestě, která musí zpracovávat data křížových odkazů. Načtěte dokument pomocí LoadFromFile nebo LoadFromStream, proveďte příslušné změny a zavolejte SaveLoadedDocument; nebo jednoduše spusťte jednorázovou operaci jako EncryptFile, která sama přečte vstup a rovnou zapíše výstup. V obou případech obnova automaticky přečte atribut /XRefStm, zkombinuje proudovou sekci (stream section) před klasickými údaji, ještě před spuštěním zápisu vyřeší i objekty vložené v proudech a teprve s tím vším je postupně očísluje. Problém se poprvé ukázal na cestě šifrování AES-256, protože šifrování dokumentu přepisuje každý objekt, a proto vyžaduje, aby každý objekt už byl lokalizován
// Jednorázově: přečte hybridní vstup a zapíše kopii zašifrovanou AES-256
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
Detail, který stojí za to si odsud odnést, leží nad samotným rozhraním API. Soubory přicházející z Wordu, Excelu, PowerPointu a dlouhého seznamu pipeline typu „Uložit jako PDF“ bývají hybridní běžně, takže zavaděč testovaný jen proti výstupu vlastního generátoru se v testování s hybridním souborem možná nikdy nesetká. Naplňte své testovací sady dokumenty exportovanými z reálných aplikací Office, ne jen soubory, které vytvořil váš vlastní kód
Zkoumání podezřelého souboru
Dvě prohlídky dokáží otázku vyřešit rychle. Otevřete soubor v hexovém zobrazení a přečtěte bajty za posledním startxref; hybridní soubor ukáže krátkou klasickou sekci, jejíž slovník traileru obsahuje /XRefStm. Nebo porovnejte počet objektů, který nahlásí plný parse, s nejvyšším číslem objektu, které v traileru deklaruje /Size. Velká mezera znamená, že se objekty skrývají v proudech, které zavaděč neotevřel, což je tentýž schodek, který se později promění v selhání při ukládání
Konec typického exportu z Excelu dělá z první kontroly konkrétní záležitost. Vše za posledním klíčovým slovem xref je čisté ASCII, takže podpis přečtete rovnou z hexového zobrazení (ofsety ilustrativní, poznámky přidány)
xref
0 0                          % prázdná klasická podsekce: žádné řádky
trailer
<< /Size 216                 % o jedničku za nejvyšším použitým číslem objektu
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % bajtový offset cross-reference streamu
>>
startxref
88710                        % ukazuje na výše uvedenou klasickou sekci
%%EOF
Podsekce 0 0 je poznávacím znamením: klasická tabulka s nulou položek existuje jen proto, aby nesla trailer, a trailer existuje hlavně proto, aby řekl /XRefStm 87325. Detektor, který se zastaví u klíčového slova xref, v tomto okamžiku vidí index ničeho. Když raději napíšete kontrolu jako skript, než abyste ji hodnotili okem, značka vždy sedí v posledních několika kilobajtech souboru, takže stačí omezené zpětné čtení
// Vrací ofset /XRefStm z konce souboru, nebo -1, pokud
// značka chybí (soubor není hybridní, nebo není PDF vůbec)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // trailer sídlí v konci souboru
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // omezené zpětné čtení: maximálně 2 KB
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/XRefStm'), Tail);
  if P = 0 then
    Exit;                               // v konci souboru není hybridní značka
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // přeskočte bílé znaky za klíčem
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Použití: nezáporný výsledek udává bajt, kde proud začíná
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Tento průzkum (probe) berte jako třídění (triage), nikoli jako parsování: řekne vám jen to, které soubory v dávce vyžadují pozornost předtím, než se spustí proces opětovného uložení, a nic víc. Co potom musí zavaděč udělat s ofsetem, který najde, sledovat řetězec sekcí, sloučit položky proudu před těmi klasickými a respektovat hlídací prvky volných položek, to krok za krokem prochází náš doprovodný článek o manipulaci s hybridně referenčními PDF z aplikací sady Office v Delphi
Zapisovací strana tohoto příběhu, tedy jak se objektové proudy a komprimované křížové odkazy vůbec vytvářejí, je popsána v našem článku o objektových proudech a inkrementálních aktualizacích. Když je dotyčný hybridní soubor zároveň velmi velký, techniky načítání z průvodce rozhraním Direct File API pro rozsáhlá PDF workflow vám umožní jej prozkoumat, aniž byste ho museli celý načítat do paměti. Obojí se přirozeně doplňuje s procesem obnovy popsaným v tomto článku, který se dodává jako součást komponenty HotPDF pro Delphi a C++Builder, bok po boku s API pro načítání, editaci, šifrování a podepisování, o kterých se na tomto blogu píše jinde