PDF Library for Delphi umí sloučit obrázky uvnitř PDF, které vypadají stejně, ale nejsou bajtově identické, přes DeduplicateSimilarImages. Přesná deduplikace slučuje jen obrázky, jejichž slovníky a zakódované payloady se shodují; tato místo toho porovnává, jak obrázky skutečně vypadají, pomocí percepčního hashe plus dvou prahů pixelové chyby, a přesměruje každý odkaz na jeden kanonický objekt
Soubory, u kterých se to vyplatí, jsou ty, které narostly náhodou. Skenovaná dávka, kde každá stránka nese stejné logo překódované jiným skenerem. Report sestavený ze zdrojů, z nichž každý vložil stejný graf s mírně jinou kvalitou JPEG. Katalog, jehož náhledy přegenerovaly dva nástroje. V každém případě soubor obsahuje mnoho kopií jednoho obrázku a přesná deduplikace se žádné z nich nedotkne
Co musí znamenat "dostatečně podobné"
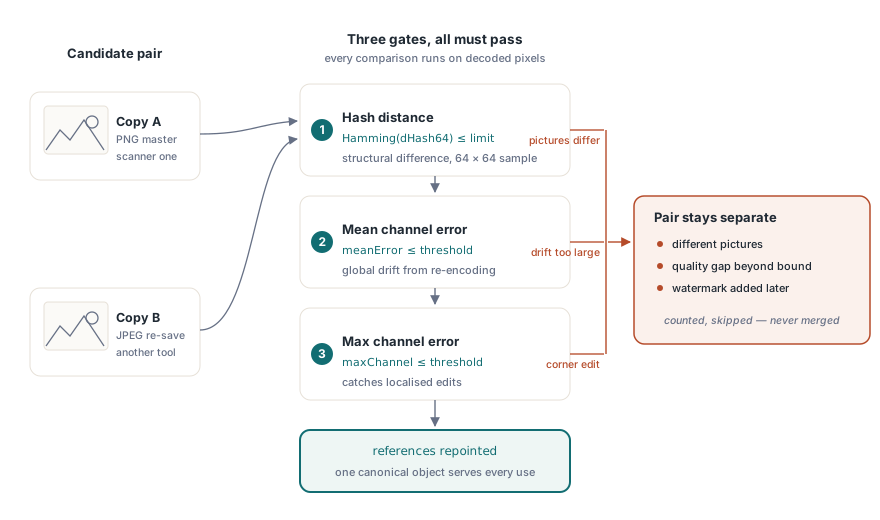
Než se dva obrázky sloučí, musí být splněny všechny tři prahy, a každý zachytí jiný druh rozdílu. Vzdálenost percepčního hashe ohraničuje strukturální rozdíl: 64bitový difference hash se počítá z 64x64 vzorku dekódovaného obrázku a povolená Hammingova vzdálenost běží od 0 do 7. Průměrná chyba kanálu ohraničuje celkový posun, který produkuje překódování. Maximální chyba jednoho kanálu ohraničuje lokalizovaný rozdíl, který produkuje malá úprava
Vyžadovat všechny tři je to, co dělá sloučení obhajitelným. Obrázek, který se liší vodoznakem v jednom rohu, má nízkou průměrnou chybu a vysokou maximální chybu, takže ho brána maximální chyby odmítne. Obrázek, který byl znovu komprimován, má malou chybu všude, takže projde. Přesně to je rozlišení, které optimalizátor velikosti potřebuje umět udělat
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Vzdálenost hashe 2, průměrná chyba 2, chyba jednoho kanálu 4.
    // Options mohou požádat o zkušební běh, takže se nic neupraví
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
Sémantická shoda přichází před vizuální podobností
Než se porovná jediný pixel, kandidátní obrázky musí sémanticky souhlasit. Knihovna sestaví stabilní podpis z celého slovníku obrázku bez /Length, /Filter a /DecodeParms, takže rozměry, barevný prostor, bitová hloubka, masky, pole /Decode, interpolace, členství ve volitelném obsahu i metadata se musí všechny shodovat
Toto pořadí zabraňuje celé třídě špatných sloučení. Dva obrázky mohou vypadat identicky v 64x64 vzorku, a přesto se na stránce chovat jinak: jeden s /Interpolate na true a jeden bez toho se při škálování vyhladí jinak a jeden patřící do skupiny volitelného obsahu zmizí, když je tato vrstva skrytá. Sloučení napříč těmito hranicemi vytvoří dokument, který je menší a špatný
Skenují se jen nepřímé Image XObjecty. Inline obrázky jsou jiná konstrukce s jinou ekonomikou a obrázky, které nelze dekódovat, se konzervativně přeskočí a započítají, ne sloučí na základě víry — bez pixelového důkazu žádné sloučení
Jak zůstává hledání levné
Porovnávání každého obrázku s každým jiným je kvadratické, což je na dokumentu s tisíci obrázků nepřijatelné. Hash se proto rozdělí na osm 8bitových pásem s uspořádaným indexem nad každým z nich
O zbytek se postará princip holubníku: pokud se dva hashe liší nejvýše o 7 bitů, musí se přesně shodovat alespoň v jednom z osmi pásem. Vyhledávání kandidátů pásmo po pásmu proto najde každou přípustnou shodu bez vyčerpávajícího párového skenu a zveřejněný limit 7 existuje přesně proto, že garance platí jen do této vzdálenosti
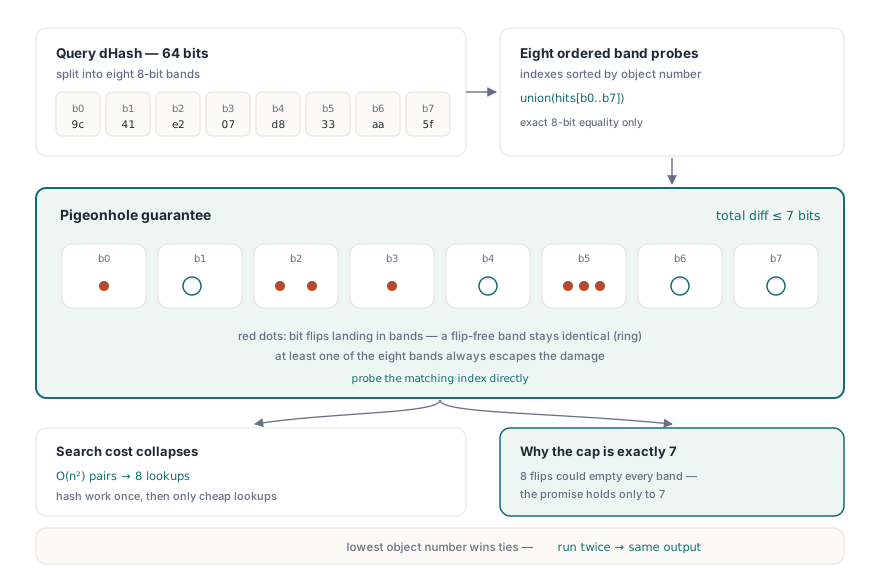
Kandidáti a shody pásem se řadí deterministicky podle čísla objektu a generace a kanonickým se stává nejnižší číslo objektu. To dělá výstup reprodukovatelným: spuštění optimalizátoru dvakrát nad stejným vstupem vyprodukuje stejné kanonické volby, což má význam, když se výsledek porovnává nebo podepisuje
Zkušební běhy a čestné reportování
Protože se jedná o ztrátovou optimalizaci v tom smyslu, že sloučené obrázky nebyly identické, rozumný workflow je nejdřív se podívat, teprve pak skočit. Volba zkušebního běhu nahlásí, co by se sloučilo a kolik payloadu by se získalo zpět, aniž by upravila graf objektů, takže dávková úloha může efekt zalogovat a člověk může jednou schválit prahy místo schvalování po jednom souboru
Dvě poznámky k čestnosti reportování stojí za zmínku. Číslo získatelného místa odhaduje jen zakódovaný payload duplicitních streamů; nezapočítává režii slovníku, nepřímého objektu a cross-reference, takže skutečné zmenšení souboru je mírně větší, než se hlásí, ne menší. A report ukazuje maximální akceptovanou chybu a zátěž porovnávání, takže vidíte, jak blízko byla sloučení vašim prahům
Pevná vzorkovací mřížka 64x64 je záměrná aproximace a má důsledek, který stojí za jasné vyslovení: rozdíl menší než jedna vzorkovací buňka může zůstat nepovšimnut i při nulovém prahu. Jediné změněné slovo na skenované stránce nemusí toto vzorkování přežít. Když je vyžadován bajtový důkaz, použijte místo toho cestu přesné deduplikace — slučuje jen skutečně identické zdroje a neprovádí žádný vizuální úsudek
Kam to patří v pipeline pro zmenšení velikosti
Řaďte průchody podle rizika. Nejdřív spusťte přesnou deduplikaci zdrojů, protože je bezztrátová a zdarma. Pak subsetting fontů, který je také bezztrátový a obvykle na textově náročných dokumentech přinese jediné největší zlepšení, jak popisuje článek optimalizace velikosti souboru PDF a subsetting fontů. Pak rekomprese nebo snížení rozlišení obrázků, pokud to cílové médium dovolí. Percepční deduplikace patří až za ně, protože je jediným krokem, jehož výsledek závisí na úsudku
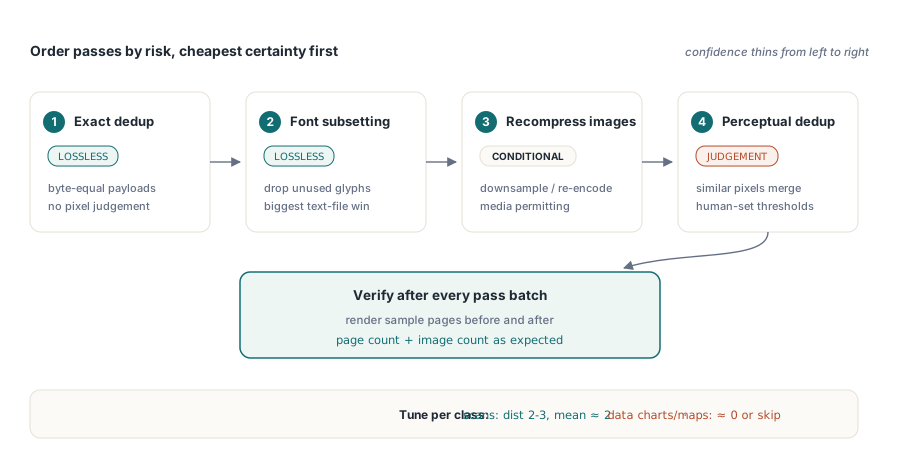
Volte prahy podle třídy dokumentu, ne globálně. Pro skenované dávky, kde každá stránka nese stejnou hlavičkovou lištu, sloučí vzdálenost hashe 2 až 3 s průměrnou chybou kolem 2 hlavičkovou lištu spolehlivě. Pro dokumenty, kde obrázky nesou data — grafy, mapy, medicínská zobrazení — použijte nulové nebo téměř nulové prahy, nebo tento průchod úplně přeskočte, protože dva grafy lišící se v jednom vyneseném bodu jsou dva různé grafy bez ohledu na to, jak podobně vypadají při 64x64
Po optimalizaci ověřte. Vykreslete vzorek stránek před a po a porovnejte je a zkontrolujte, že se počet stránek a počet obrázků změnily podle očekávání. Kontrolní cestu pro to, co dokument skutečně obsahuje, popisuje článek audit velikosti souboru PDF podle kategorie, což je také nejrychlejší způsob, jak zjistit, zda jsou obrázky vůbec vaším problémem
Percepční deduplikace, přesná deduplikace zdrojů a audit velikosti běží pro Delphi, C++Builder a Free Pascal na stejném grafu objektů; úplný seznam funkcí najdete na stránce PDF Library for Delphi