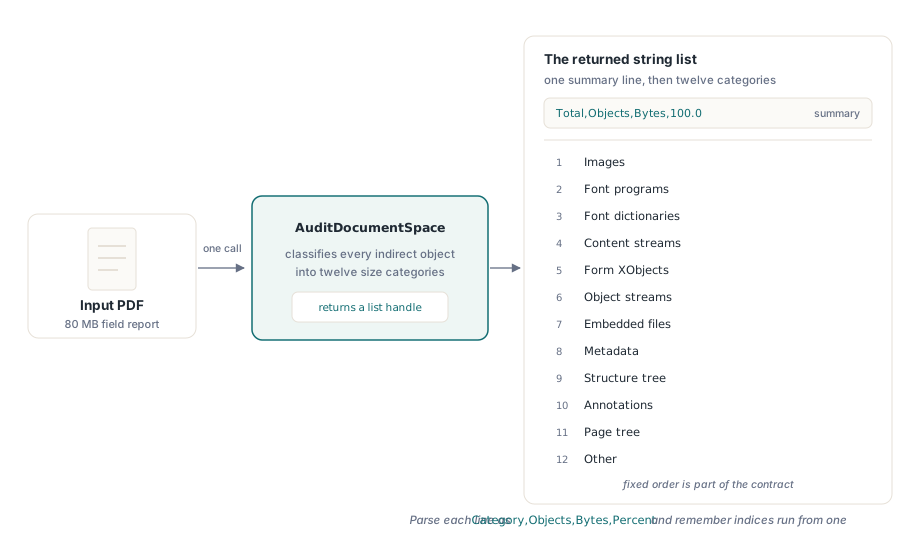
Chcete-li zjistit, kam skutečně mizí velikost souboru PDF, losLab PDF Library vystavuje AuditDocumentSpace, který klasifikuje každý nepřímý objekt do dvanácti kategorií — obrázky, programy fontů, slovníky fontů, content streamy, form XObjecty, object streamy, vložené soubory, metadata, strom struktury, anotace, strom stránek, ostatní — a hlásí počet objektů, uložené bajty a procentuální podíl každé z nich
Situace, pro kterou toto existuje, je známá. Čtyřicetistránkový report vyjede z vašeho generátoru s 80 MB, zákazník se zeptá proč, a vy mu můžete nabídnout jen odhad. Nejspíš obrázky. Možná fonty. Takže zapnete podvzorkování, dodáte to, a soubor přistane na 74 MB, protože skutečná váha byla úplně jinde. Náš doprovodný článek o subsetingu fontů a podvzorkování obrázků popisuje, jak PDF zmenšit; tento popisuje krok, který by měl přijít první, totiž měření toho, co se chystáte zmenšit
Proč měřit ještě před kompresí?
Protože tři standardní optimalizační průchody mají na daném souboru divoce odlišnou návratnost, a nic na souboru vám neřekne, který z nich platí, dokud nespočítáte. Subsetovat fonty na dokumentu, jehož fonty už jsou 2 % jeho bajtů, je odpoledne strávené přesouváním zaokrouhlovací chyby. Podvzorkování obrázků v souboru, jehož objem tvoří nekomprimované content streamy, produkuje stejné zklamání. Optimalizátor není ta obtížná část — každá knihovna nějaký má. Vědět, kterým optimalizátorem na tento soubor mířit, je ta obtížná část, a to je otázka účetnictví, ne komprese. Audit také zachytí případy, kdy odpovědí není žádný optimalizátor: soubor, který se ukáže být z 60 % vloženými přílohami, nepotřebuje lepší kompresi, potřebuje rozhovor o tom, zda tyto přílohy do dokumentu vůbec patří, a soubor, který je z 30 % stromem struktury, platí za značkování přístupnosti, což je obvykle záměrný náklad, který byste neměli tiše odstranit. Jakmile jsou bajty přiřazeny, děláte produktové rozhodnutí s čísly za sebou místo sahání po přepínači, který je nejblíž po ruce
Co obsahuje report dvanácti kategorií
AuditDocumentSpace vrací handle seznamu řetězců místo záznamu, takže report přežije ploché DLL a COM fasády nezměněný. Seznam nese souhrnný řádek Total,Objects,Bytes,100.0 následovaný přesně dvanácti řádky Category,Objects,Bytes,Percent v pevném pořadí, které je součástí smlouvy: Images, Font programs, Font dictionaries, Content streams, Form XObjects, Object streams, Embedded files, Metadata, Structure tree, Annotations, Page tree, Other. Třináct řádků, vždy, i když je kategorie prázdná
var
  Lib: TPDFlib;
  ListID, I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    ListID := Lib.AuditDocumentSpace;   // 0 pokud není vybrán žádný dokument
    if ListID = 0 then
      Exit;
    try
      // GetStringListItem indexuje od jedné: položky běží 1..GetStringListCount
      for I := 1 to Lib.GetStringListCount(ListID) do
        Memo1.Lines.Add(Lib.GetStringListItem(ListID, I));
    finally
      Lib.ReleaseStringList(ListID);
    end;
  finally
    Lib.Free;
  end;
end;
Jeden detail Delphi v této smyčce vás kousne přesně jednou. GetStringListItem používá indexy položek od jedné, shodně s GetStringListCount, a index mimo rozsah vrací prázdný řetězec místo vyvolání výjimky. Napište smyčku for I := 0 to Count - 1 ze zvyku a dostanete prázdný první řádek, tiše zahozený poslední řádek, a nikde žádnou výjimku, která by vám řekla, že indexování je špatně. Report samotný bude vypadat téměř správně, což je nejhorší způsob selhání, jaký diagnostický nástroj může mít
Proč audit používá uloženou délku místo dekódované velikosti?
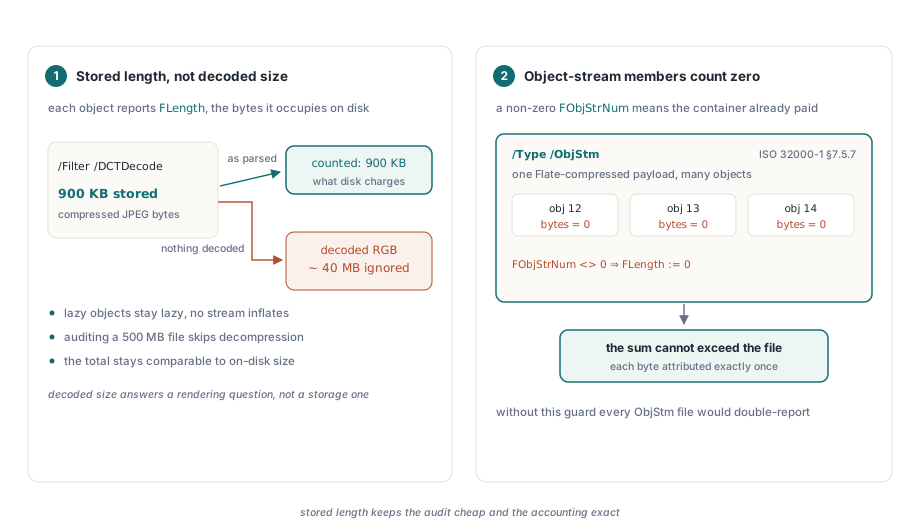
Protože uložená délka je zároveň číslo, které chcete, a číslo, které je levné získat. Každý nepřímý objekt nese TPDFIndObj.FLength, syrovou bajtovou délku, kterou objekt zabírá v souboru tak, jak byl zpracován. Použití toho znamená, že 900KB obrázek DCTDecode se hlásí jako 900 KB — bajty, které vás stojí na disku — místo 40 MB vzorků RGB, na které se dekóduje. Znamená to také, že audit nikdy nemusí nic dekódovat: líně načtené objekty zůstávají líné, filtry zůstávají nespuštěné, a audit 500MB souboru je průchod přes hlavičky objektů místo plného dekompresního cyklu
Druhé pravidlo je obranou proti dvojímu počítání. Když objekt žije uvnitř komprimovaného object streamu, indikovaného nenulovým FObjStrNum, jeho počet bajtů se zaznamená jako nula. Jeho úložiště už bylo jednou zaplaceno kontejnerovým streamem, který ISO 32000-1 §7.5.7 definuje jako stream /Type /ObjStm nesoucí mnoho objektů v jednom Flate-komprimovaném payloadu. Účtovat každému členovi vlastní podíl a pak znovu účtovat kontejneru by nafouklo součet nad skutečnou velikost souboru. To má přímý důsledek na to, jak čtete výstup, popsáno níže a hlouběji v našem článku o object streamech a cross-reference streamech
Proč se program fontu nemůže sám klasifikovat?
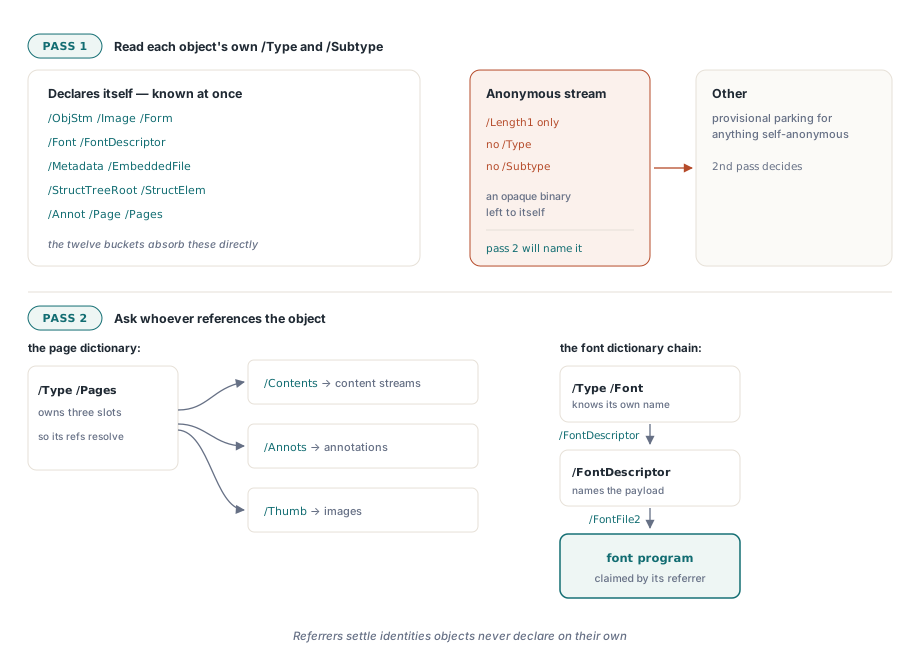
Protože soubor fontu TrueType vložený do PDF nemá žádnou značku, která by to říkala. ISO 32000-1 §9.8.1 definuje vložený program fontu jako hodnotu /FontFile, /FontFile2 nebo /FontFile3 v deskriptoru fontu, a slovník streamu na druhém konci tohoto odkazu nese /Length1 a klíče filtru, ale žádný /Type a žádný /Subtype, který by jej identifikoval jako font. Zkoumaný izolovaně je to anonymní binární stream. Jen deskriptor, který na něj odkazuje, ví, co to je. Stejná asymetrie se objevuje u anotací: §12.5.2 dělá /Type /Annot volitelným ve slovníku anotace, takže spolehlivým signálem je členství v poli /Annots stránky, ne samotný slovník
Takže klasifikace probíhá dvakrát. První průchod čte vlastní /Type a /Subtype objektu a bere snadné výhry: /ObjStm, /Subtype /Image, /Subtype /Form, /Type /Font a /Type /FontDescriptor, /Metadata, /EmbeddedFile a /Filespec, /StructTreeRoot a /StructElem, /Annot, /Page a /Pages. Vše ostatní prozatímně přistane v Other. Druhý průchod pak prochází stranu odkazování a přepisuje: každý slovník stránky přeřadí své /Contents do content streamů, své položky /Annots do anotací a svůj /Thumb do obrázků, zatímco každý slovník fontu prochází vlastní řetěz deskriptoru
// Tvar druhého průchodu: odkazující objekt pojmenovává objekt
Descriptor := DictOf(FontDict.FindValueByKeyName('FontDescriptor'));
if Assigned(Descriptor) then
begin
  MarkRef(FontDict.FindValueByKeyName('FontDescriptor'), catFontDicts);
  MarkRef(Descriptor.FindValueByKeyName('FontFile'),  catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile2'), catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile3'), catFontPrograms);
end;
// Fonty Type0 mají deskriptor o úroveň níž
Descendants := FontDict.FindValueByKeyName('DescendantFonts', True);
if (Descendants is TPDFArray) and (TPDFArray(Descendants).Count > 0) then
  MarkFontProgramRefs(DictOf(TPDFArray(Descendants).Item[0]));
Čtení reportu a volba dalšího kroku
Čtěte nejprve podíly, počty objektů až poté, a jakoukoli velkou mezeru mezi nimi berte jako signál. Moderní PDF ukládá většinu svých malých slovníků dovnitř object streamů, takže Page tree a Structure tree běžně ukazují desítky objektů proti téměř nule bajtů — jejich skutečná cena se sbalila do řádku Object streams. Je-li Object streams samotný velký, soubor je hustý strukturou podobnou metadatům spíš než obsahem, a pákou je prořezávání objektů, ne jejich komprese. Appearance streamy anotací se chovají podobně: nesou /Subtype /Form, takže silně orazítkovaný dokument ukazuje svou váhu pod Form XObjects, zatímco řádek Annotations zůstává malý
function CategoryShare(Lib: TPDFlib; ListID: Integer;
  const Category: string): Double;
var
  I: Integer;
  Parts: TArray<string>;
  Inv: TFormatSettings;
begin
  Result := 0;
  Inv := FormatSettings;
  Inv.DecimalSeparator := '.';   // report je nezávislý na locale
  for I := 2 to Lib.GetStringListCount(ListID) do   // řádek 1 je Total
  begin
    Parts := string(Lib.GetStringListItem(ListID, I)).Split([',']);
    if (Length(Parts) = 4) and SameText(Parts[0], Category) then
      Exit(StrToFloatDef(Parts[3], 0, Inv));
  end;
end;
Dva formátovací fakty mají význam, pokud procenta parsujete místo pouhého zobrazení. Desetinný oddělovač je vždy doslovná tečka bez ohledu na locale stroje, takže parsování s okolním FormatSettings na německé nebo francouzské pracovní stanici selže, nebo hůř, přečte se špatně. A koncové nuly se ořezávají, takže kategorie nesoucí přesně 40 % bajtů se vytiskne jako 40, ne 40.0 — nikdy nepředpokládejte pevné desetinné místo. Máte-li podíl v ruce, směrování je mechanické: dominantní podíl Images ukazuje na DownsampleImages, dominantní podíl Font programs na SubsetEmbeddedFonts, a objemné Content streams na CompressContent
Co vám audit záměrně neřekne
Součet je sumou přes nepřímé objekty, a soubor PDF je o něco víc než jen jeho objekty. Hlavička souboru, trailer, mezera mezi objekty a klasická tabulka cross-reference nejsou nepřímé objekty, takže tyto bajty se ničemu nepřiřazují a celkový součet auditu přistane trochu pod velikostí na disku. Cross-reference stream je jiný případ — je to skutečný objekt s /Type /XRef, takže v moderním souboru se tyto bajty objeví, v kategorii Other. Ani jedno chování není vada, ale pokud rekonciliujete audit proti počtu bajtů ze souborového systému, právě odtud pochází mezera
Za otevřené vyjádření stojí ještě dvě hranice. Zaprvé, čísla popisují soubor, který byl načten, ne ten, který se právě autoruje: u objektů postavených v paměti, které ještě nemají uloženou délku, se velikost odvozuje ze serializovaného výstupu s nominální rezervou na slovník streamu, což je odhad případného zápisu, ne měření. Auditujte po uložení a opětovném načtení, chcete-li přesná čísla. Zadruhé, tučný řádek Other je zjištění, ne hlášení chyby — obvykle znamená osiřelé objekty, na které už nic neodkazuje, což je práce pro mark-and-sweep garbage collection, ne pro jakýkoli kompresní průchod
Takto použitý audit mění tvar rozhovoru. Místo hádání nad 80MB reportem jej otevřete, spustíte jedno volání a přečtete, že obrázky tvoří 8 %, programy fontů 61 %, a dokument vkládá devět celých programů fontů pro firemní styl, který používá tři řezy. To je opravitelná odpověď s číslem na sobě. AuditDocumentSpace, spolu s optimalizačními průchody, ke kterým vás nasměruje, je součástí losLab PDF Library pro Delphi a C++Builder, kde referenční stránky dokumentují kompletní seznam kategorií a API seznamu řetězců kolem něj