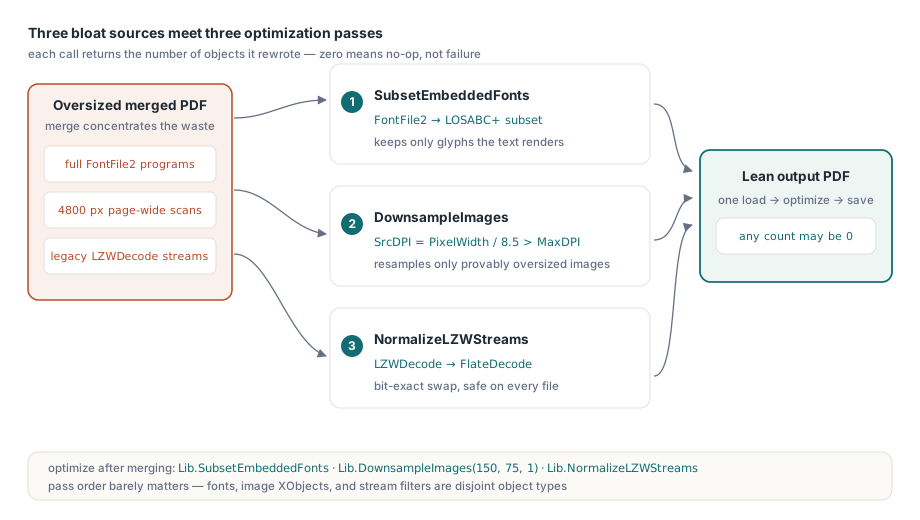
Pro zmenšení velikosti souboru PDF v Delphi poskytuje losLab PDF Library tři API, která útočí na tři největší zdroje nabobtnání: SubsetEmbeddedFonts přepíše každý vložený program fontu TrueType jen na glyfy, které dokument skutečně vykresluje, DownsampleImages převzorkuje rastrové obrázky přesahující cílové DPI a NormalizeLZWStreams nahradí zastaralou kompresi LZWDecode filtrem FlateDecode. Každé z nich vrací počet objektů, které změnilo, takže nula vám říká, že průchod byl prázdnou operací, a ne tichým selháním
Proč je mé sloučené PDF větší než jeho zdrojové soubory?
Sloučené nebo programově vygenerované PDF bývá nadměrně velké obvykle z jednoho ze tří důvodů: plně vložené fonty, obrázky vzorkované daleko nad jejich zobrazovacím rozlišením a streamy stále komprimované zastaralým filtrem LZW. ISO 32000-1 §9.9 dovoluje producentovi vložit kompletní program fontu a většina producentů to přesně tak dělá, protože jde o bezpečnou výchozí volbu. Kompletní FontFile2 fontu Arial má stovky kilobajtů; vložte jej do tuctu zdrojových souborů, slučte je, a nesete s sebou tucet kopií obrysů glyfů pro znaky, které nikdo nenapsal. Slučování samo o sobě plýtvání nevytváří, jen je koncentruje do jediného souboru, kde se celkový objem konečně stane viditelným
Obrázky jsou druhým viníkem. Sken široký 4800 pixelů umístěný do rámečku o velikosti čtvrtiny stránky nese zhruba 40krát více pixelových dat, než dokáže využít tiskový pipeline s 300 DPI. Třetí důvod je tišší: streamy filtrované přes LZWDecode. ISO 32000-1 §7.4.4 specifikuje LZWDecode i FlateDecode a poznamenává, že Flate obvykle komprimuje přinejmenším stejně dobře; v praxi je výstup Flate na stejných datech konzistentně menší a LZW přežívá hlavně v souborech, které někdy ve své historii prošly nástroji z devadesátých let. Zbytek tohoto článku prochází tři průchody losLab PDF Library, které každý z těchto problémů řeší, a pak je spojuje do jednoho pipeline
Tvorba podmnožin fontů pomocí SubsetEmbeddedFonts
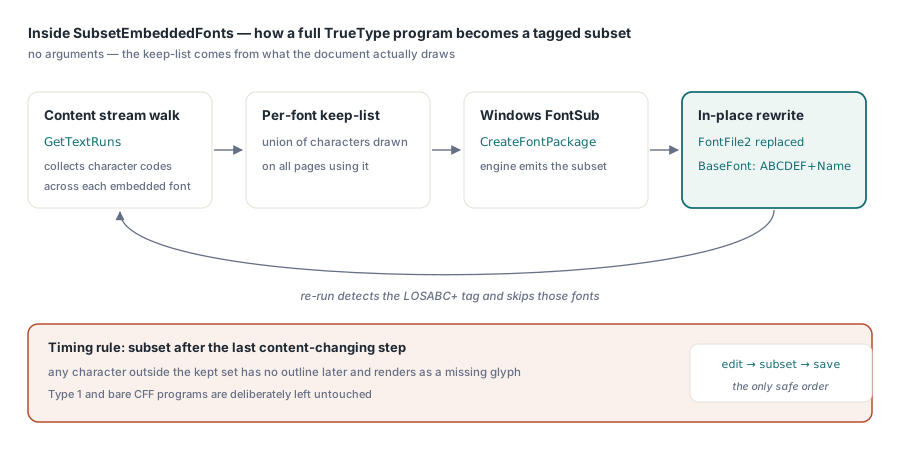
SubsetEmbeddedFonts zmenší každý vložený font TrueType v načteném dokumentu na znaky, které dokument skutečně používá, a nepotřebuje žádné argumenty, protože seznam ponechaných glyfů odvozuje přímo z obsahových streamů. Interně průchod projde obsahový stream každé stránky pomocí GetTextRuns, shromáždí kódy znaků odkazované pod každým zdrojem fontu, sestaví seznam ponechaných glyfů a předá původní program fontu enginu Windows FontSub (CreateFontPackage), který vytvoří podmnožinu. Přepsaný program nahradí stream FontFile2 na místě a název BaseFont získá značku LOSABC+, tedy konvenci šesti velkých písmen a znaménka plus, kterou ISO 32000-1 §9.6.4 definuje pro podmnožiny fontů. Právě tato předpona také činí volání idempotentním: spusťte průchod dvakrát a fonty, které už podmnožinou jsou, se rozpoznají a přeskočí, takže jeho zapojení do dávkové úlohy, která se může k souborům vracet, je bezpečné
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = počet přepsaných programů FontFile2;
      // 0 znamená, že nic není vloženo nebo už je vše zredukováno na podmnožinu
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Dva implementační detaily stojí za to znát, protože vysvětlují hranice tohoto API. Zaprvé, průchod cílí na FontFile2, takže pokrývá vložené programy TrueType; fonty vložené jako Type 1 nebo holé CFF zůstávají nedotčené, místo aby se riskovalo. Zadruhé se opírá o FontSub, což činí SubsetEmbeddedFonts dostupným pouze ve Windows. Jemnější bod z implementace: to, zda font splňuje podmínky, se rozhoduje skutečným vyhodnocením řetězce odkazů FontDescriptor → FontFile2, nikoli důvěrou v heuristiku příznaku vložení, protože fonty v načteném dokumentu nikdy neprošly evidencí na straně vytváření, která takové příznaky nastavuje. Pokud vyhodnocený stream existuje, font je kandidátem; pokud ne, přeskočí se bez chyby
Poctivý kompromis: podmnožina fontu obsahuje pouze glyfy přítomné v okamžiku vytvoření podmnožiny. Pokud navazující nástroj nebo váš vlastní kód později přidá text ve stejném fontu, žádný znak mimo podmnožinu nemá obrys a vykreslí se jako chybějící glyf. Podmnožiny vytvářejte jako poslední krok měnící obsah, nikdy před fází úprav. Stejná opatrnost platí, pokud plánujete font později znovu vytáhnout k opakovanému použití; článek o extrakci textu, obrázků a fontů pomocí PDF Library for Delphi popisuje, co vám extrahovaný program podmnožiny může a nemůže dát
Jak DownsampleImages rozhoduje, které obrázky zmenšit?
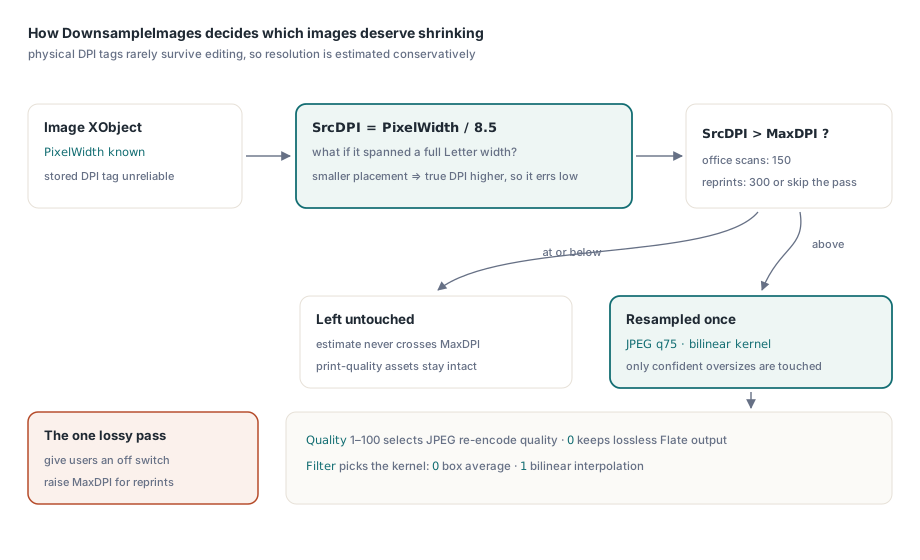
DownsampleImages(MaxDPI, Quality, Filter) převzorkuje pouze obrázky, které může s jistotou označit za nadměrně vzorkované, a používá k tomu záměrně konzervativní odhad DPI. Obrazový XObject v PDF ukládá rozměry v pixelech, ale žádné důvěryhodné fyzické rozlišení, a jakákoli značka DPI ze zdrojového obrázku zřídka přežije cyklus načtení, úprav a uložení. Průchod proto odhaduje SrcDPI = PixelWidth / 8.5, čímž se v podstatě ptá: kdyby tento obrázek zabíral celou šířku stránky formátu Letter, jaké by bylo jeho rozlišení? Dotčeny jsou pouze obrázky, jejichž odhad překračuje MaxDPI. Toto zkreslení je záměrné: obrázek umístěný na stránce v malé velikosti má skutečné DPI vyšší než odhad, takže průchod se spouští spíše méně často, než aby degradoval tiskově kvalitní podklad, který nedokáže změřit
Quality od 1 do 100 volí kvalitu překódování do JPEG, zatímco 0 ponechá výstup jako bezeztrátový Flate ve stylu PNG; Filter vybírá převzorkovací jádro, 0 pro průměrování boxem a 1 pro bilineární filtr. Pro naskenované kancelářské dokumenty je DownsampleImages(150, 75, 1) rozumným výchozím bodem; pro cokoli, co se může znovu tisknout, zvyšte MaxDPI na 300 nebo průchod úplně vynechte. Převzorkování je jediným ztrátovým krokem ze tří, takže patří za nastavení, které mohou vaši uživatelé vypnout
Převod zastaralých streamů LZW pomocí NormalizeLZWStreams
NormalizeLZWStreams je výhra zdarma: bezeztrátově dekomprimuje každý stream LZWDecode a znovu jej komprimuje pomocí FlateDecode, na místě, a vrací počet převedených streamů. Zvládá jak samostatnou položku /Filter /LZWDecode, tak LZW uvnitř pole řetězce filtrů, kde se nahradí pouze článek LZW a zbytek řetězce se zachová. Parametry prediktoru (Predictor, Columns, Colors, BitsPerComponent) se čtou z DecodeParms daného streamu a předávají dekompresoru, takže obrazová data kódovaná prediktorem projdou cyklem správně. Protože oba filtry jsou bitově přesné kodeky, dekódované bajty jsou před i po totožné; mění se pouze komprese kontejneru, a právě proto je tento průchod bezpečné spouštět bezpodmínečně na každém souboru
Na dokumentu bez streamů LZW volání jednoduše vrátí 0 a ničeho se nedotkne, což regresní sada knihovny explicitně ověřuje: čerstvě vytvořený soubor pouze s Flate musí hlásit nula převodů. Tato záruka prázdné operace má význam, když průchod sedí v pipeline, který zpracovává tisíce různorodých souborů, některé z roku 2024 a některé z roku 1998
Kompletní pipeline optimalizace velikosti v Delphi
Tři průchody se spojují do jediné funkce načíst-optimalizovat-uložit a na pořadí záleží méně, než byste čekali, protože pracují s disjunktními typy objektů: fonty, obrazovými XObjecty a filtry streamů. Spustit tvorbu podmnožin jako první je přesto úhledná volba, protože jde o průchod s omezením na pořadí úprav
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> podmnožina
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilineární
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Zalogujte Fonts/Images/Streams: tři nuly znamenají, že soubor už byl štíhlý
  finally
    Lib.Free;
  end;
end;
Ověřte pipeline tak, jak se ověřuje knihovna sama: obousměrným cyklem. Regresní testy verze v3.130 vytvoří dokument, uloží jej, znovu načtou, spustí optimalizaci, znovu uloží a pak ověří tři věci: výstup je menší, vrácené počty odpovídají očekávání a opětovné načtení optimalizovaného souboru se stále parsuje a vykresluje. Zopakování této smyčky vytvořit-optimalizovat-znovu načíst na vzorku vašich vlastních produkčních souborů a porovnání extrahovaného textu před a po je hodinová investice, která odhalí chyby integrace dávno předtím, než zákazník otevře rozbitou fakturu
// Kontrola obousměrného cyklu: optimalizovaný soubor se musí stále čistě načíst
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Kam pipeline zapadá do pracovního postupu slučování? Až po sloučení, ne během něj. Nejprve sloučit a poté optimalizovat jediný výsledek znamená, že každý vložený font se zredukuje na podmnožinu jednou vůči sjednocení všech použitých znaků, místo za každý zdrojový soubor zvlášť. Pokud je úzkým hrdlem propustnost slučování, PDF Library for Delphi nabízí rychlou cestu na úrovni bajtů, která se vyhýbá úplnému parsování objektů, popsanou v článku o rychlém slučování PDF s posunem bajtových odkazů; a pro vstupy příliš velké na to, aby se celé vešly do paměti, popisuje streamovací cestu článek slučování a rozdělování velkých PDF s přímým přístupem. Obě se přirozeně doplňují závěrečným optimalizačním průchodem nad sloučeným výstupem
Co tyto tři průchody neudělají
Optimalizační trojice losLab PDF Library záměrně vylučuje vše, co mění sémantiku dokumentu. SubsetEmbeddedFonts nesjednocuje duplicitní fonty napříč sloučenými zdroji do jednoho programu, každý zmenšuje nezávisle; deduplikace je jiná, riskantnější transformace. DownsampleImages přejde obrázek, jehož konzervativní odhad DPI zůstává pod prahem, i když by člověk poznal, že je pro svůj rámeček příliš velký. A žádný z průchodů se nedotýká struktury dokumentu, takže soubor nabobtnalý tisíci osiřelých objektů potřebuje uložení stylem přepisu, nikoli tyto průchody na úrovni streamů. V těchto mezích kombinace tvorby podmnožin fontů, převzorkování obrázků a normalizace LZW na Flate odstraňuje tři klasické zdroje nabobtnání PDF jedním předvídatelným voláním API za každý. Tyto tři funkce jsou součástí losLab PDF Library pro Delphi, C# a VB.NET, vedle API pro slučování, extrakci a vykreslování probíraných výše