物件編號 1 不是第 1 頁。單憑這一個事實,絆倒的 PDF 處理程式碼比這個格式的任何其他部分都多,而箇中原因,只有在你不再盯著檢視器渲染出來的畫面、開始看檢視器實際讀取的物件圖時才會浮現
PDF 檔案是一堆編了號的間接物件。每個物件帶一個物件編號與一個世代編號,其他物件用寫成 N G R 的參照指向它——3 0 R 指的是物件 3 的當前版本。頁面跟其他物件一樣都是物件,但它們在檔案裡的位置與帶著的編號,完全不影響顯示順序。順序來自 /Pages 樹。按編號掃描物件再收集頁面,相當大一部分真實世界的檔案會被你拼成錯誤的順序
樹也是許多不明顯行為的所在。樹的形狀決定檢視器跳到第 8,214 頁有多快;它的內部節點悄悄把頁面大小與字型往下遞給底下的葉子;而讓整個結構跑得快的那些 /Count 總計,沒有任何機制強制它們為真。三件事我們都會講,從順序本身開始
頁面樹決定順序
每份 PDF 都有一個文件目錄(ISO 32000-2 §7.7.2),目錄的 /Pages 項目指向頁面樹的根節點。根節點是一個帶 /Type /Pages 的字典,附一個間接參照的 /Kids 陣列和一個 /Count,後者給出其下葉頁面的數量。顯示順序就是對這棵樹做深度優先、由左至右的走訪。規則就這麼一條
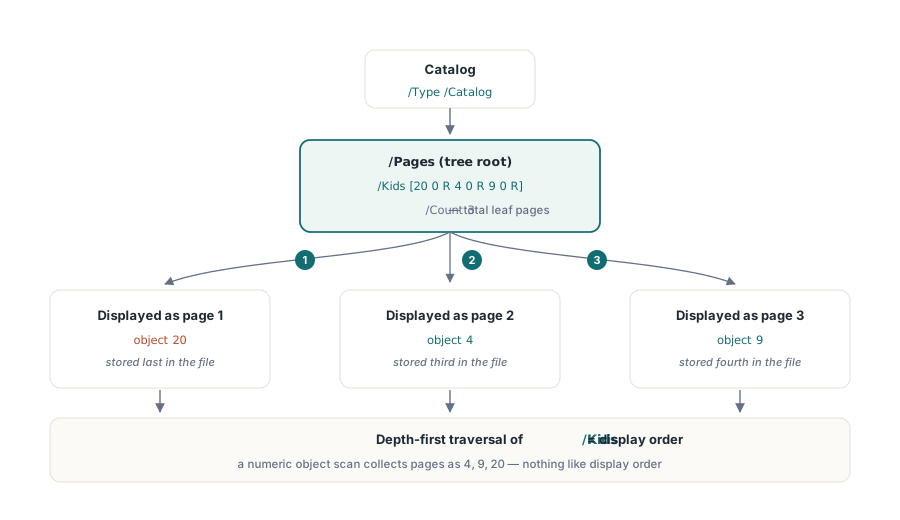
一份最小化的三頁檔案把它講具體:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% 物件 4 在檔案裡排第三個儲存,顯示順序上卻是第 2 頁
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% 物件 9 排第四個儲存,卻是第 3 頁
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% 物件 20 最後一個儲存,卻是第 1 頁;Kids[0] 說了算,物件編號不算數
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
/Kids 陣列讀作 [20 0 R 4 0 R 9 0 R],所以物件 20 是第 1 頁、物件 4 是第 2 頁、物件 9 是第 3 頁。按編號迭代物件、把所有帶 /Type /Page 的東西收進來的程式碼,會把這份檔案搞錯。更糟的是輸出看起來還挺像樣:頁數正確、每頁內容可辨識,只是順序不對
產生器弄出這種版面,理由通常很平常。有的程式庫先為所有頁面保留物件編號,按建立順序編號,寫位元組時卻照序列化器方便的順序來。合併工具會把每個來源文件的物件重新編號以避免撞號,頁面物件於是散落在合併後的物件表裡,而新的根 /Kids 陣列握有正確順序。增量更新則把新物件用新編號附加在檔案尾端,所以某次修訂加入的頁面,就算邏輯上該排第 1 位,實體上也住在位元組流的尾端附近
最後這種情況最咬人。單一工具產出的測試語料可以全數過關,接著合併流程出來的檔案、或經過幾次修訂的文件就出現洗牌。啟發式修法站不住腳,因為失敗取決於產生器與檔案的編輯歷史。真正的修法很短:從目錄出發,解析 /Pages,遞迴走訪 /Kids,照遇到順序輸出葉子。我們的 頁面順序偵錯案例研究 正是沿著這個症狀走過一次誤診到根因,附遞迴走訪程式碼與檢查結果用的 qpdf 步驟
扇出是一項效能決策
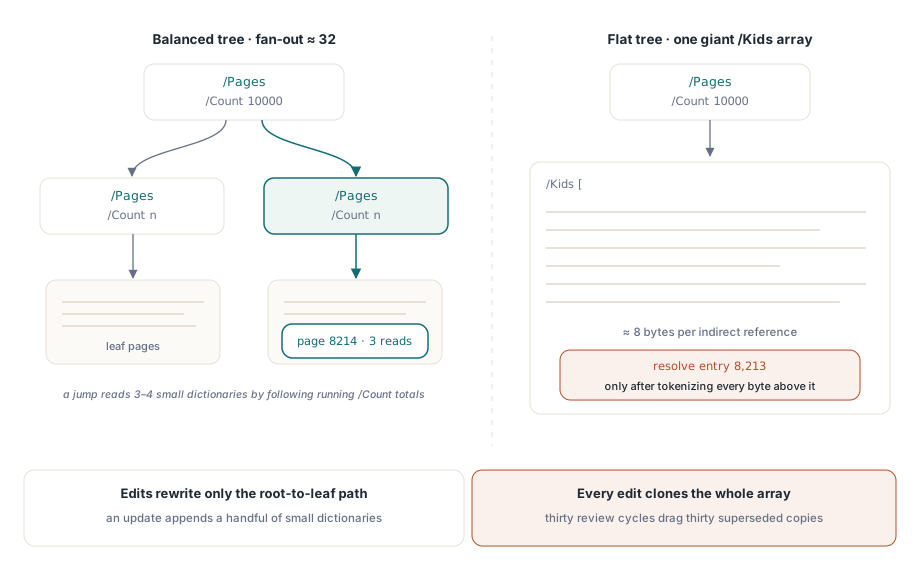
規範允許兩種形狀。簡單的產生器輸出扁平樹:一個根 /Pages 節點,其 /Kids 只放 /Page 葉子。沒有任何規定強迫寫入器巢狀化,一份 10,000 頁、單一陣列裡塞 10,000 個葉參照的文件完全合規。話雖如此,PDF Reference 仍建議大型文件採用平衡樹,主流產生器也聽話地用了溫和的扇出——每個中間節點通常幾十個子節點,而每個中間節點有自己的 /Kids 與自己的 /Count
原因在於檢視器顯示任何內容之前得先讀什麼。想像直接跳到那份 10,000 頁檔案的第 8,214 頁。扁平樹之下,檢視器得先解析根節點,而根節點是一個巨大陣列:每個間接參照約八位元組,是一個 80 KB 的物件,得從頭到尾完成詞法分析,第 8,213 個項目才解析得出來。扇出 32 的平衡樹之下,同樣的跳轉讀根節點、比對累計的 /Count 總數挑出正確子節點、往下走,只碰三四個小字典,每個幾百位元組。這種 O(log n) 隨機存取正是這棵樹的設計目的,也是中間節點上存在 /Count 的全部理由——讀取端可以整棵子樹跳過,不必開啟裡面任何一個物件
樹的形狀也決定編輯成本。插入一頁的增量更新必須改寫每個 /Kids 或 /Count 變了的節點,也就是從新葉子的父節點一路到根的路徑。平衡樹裡這條路徑是附加到檔案的少數幾個小字典;扁平樹裡的「路徑」是那個巨大的根陣列,每次修訂都得整份複製一遍。一份經歷三十輪審閱與註記的合約,位元組流裡最後可能拖著同一個 80 KB 陣列的三十份被取代複本
對處理程式碼而言,巢狀還有一個更直接的後果。你不能假設第一層 /Kids 放的就是頁面,每個子節點都得檢查:/Type /Pages 就遞迴,/Type /Page 就是葉子。只處理第一層的程式碼,遇過的每份扁平檔案都沒事,直到某個產生器決定巢狀化那天,整棵子樹無聲消失
內部節點攜帶可繼承屬性
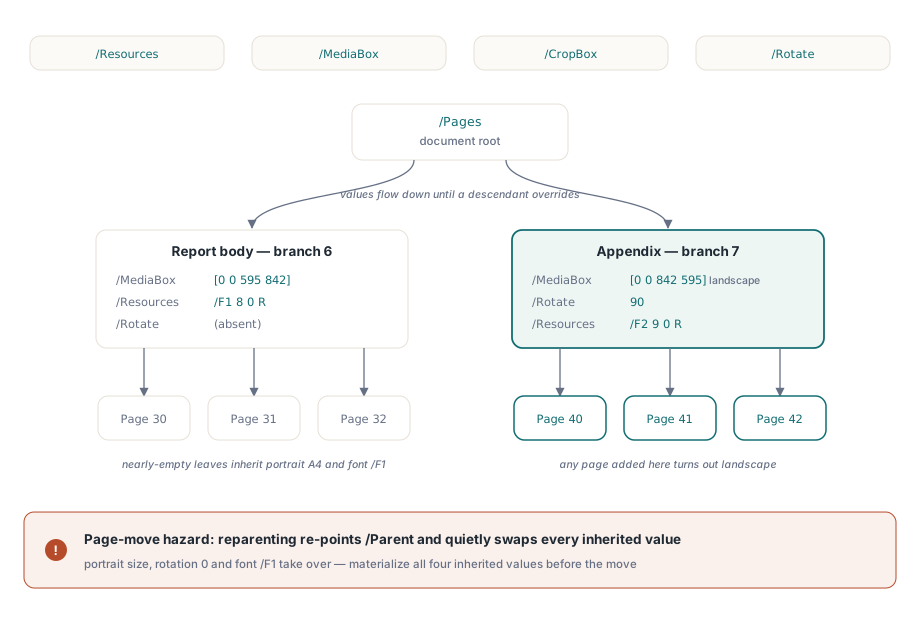
中間節點做的比轉發查尋多。四個頁面屬性可繼承(ISO 32000-2 §7.7.3.4):/Resources、/MediaBox、/CropBox 與 /Rotate。任何一個都可以放在 /Pages 節點上,作用於其下每一片葉子,除非後代覆寫。產生一份帶橫向附錄之報告的寫入器,可以直接在樹本身表達這個版面:
5 0 obj   % 文件根節點
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % 報告主體:直向 A4、內文字型
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % 附錄:橫向 A4、旋轉,用自己的字型
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % 附錄頁面:繼承尺寸、旋轉與字型
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
物件 40 到 42 幾乎是空的。頁面大小、旋轉與字型資源全部來自節點 7,檔案因此保持精巧且能自我維護:在附錄節點下加第四頁,不用任何人動手,它自動就是橫向
這也代表頁面的屬性不全在頁面上。物件 40 沒有 /MediaBox 鍵,而這完全合法——把缺鍵當畸形輸入的讀取端會拒收有效檔案。查尋必須沿 /Parent 鏈往上走,直到找到該項目或抵達根節點。這個上行需要環偵測。損壞的檔案可能帶著指回已訪問節點的 /Parent 參照,沒有已訪問集合的話,查尋會轉個沒完
同一個機制也造就了經典的頁面搬移風險。假設某個工具把物件 40 搬進報告主體:改兩個 /Kids 陣列、把 /Parent 改指節點 6。搬移在結構上完全有效,但物件 40 從此繼承直向的 /MediaBox、不旋轉與字型 /F1——它的內容串流卻仍選用 /F2,而它已解析不到。一次編輯,頁面縮小、轉正、文字消失。站得住腳的重新排序程式碼,會在重新指定父節點之前,把四個可繼承屬性的解析值全部寫死到頁面字典上。如果你曾在編輯器裡拖曳一頁、然後眼看它變了尺寸或方向,你目睹的就是這個機制
扁平化:合法、常見,偶爾代價高昂
不少工具走反方向。極簡寫入器輸出單層樹,圖的是簡單;許多合併與分割工具則把它們讀到的樹一律重建成一個扁平的 /Kids 陣列,平衡輸出是額外工作,扁平輸出永遠合規。正確的重建得同時解析繼承:葉子原本繼承的每個屬性都必須複製到葉子上,或在整份文件一致時提升到新的根;跳過這一步,輸出的幾何就會像頁面搬移案例那樣被改掉
對典型文件,扁平化無害。它在大規模時才咬人,就是前述兩種方式:根陣列變成一個巨大物件,每次開啟與每次跳頁都得完整解析,每次結構編輯都得整份改寫。扁平化沒有摧毀的是透過間接參照的共享。一份 10,000 頁全部指向同一個 /Resources 字典物件的扁平樹仍然去重——失去的只是「頁面上不寫這個項目、讓祖先供應」的選項
當 /Count 說謊時
/Count 是純簿記。它必須等於該節點子樹裡葉頁面的數量,而檔案格式沒有任何機制強制這一點。野外見過的說謊計數,絕大多數可歸結為兩種損壞模式
第一種是增量更新留下的過期計數。編輯器插入一頁,用新的 /Kids 與更新後的 /Count 改寫直接父節點,把兩者附加到檔案——然後祖先一個都沒碰:
% 原始修訂版本
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% 追加修訂版本:一頁插入中間分支。
% 物件 14 被取代;物件 12 從未改寫
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
樹裡現在實際有十片葉子,根節點卻還說九。信根節點的檢視器在頁面計數器裡顯示九。用內部計數做二元搜尋跳頁的檢視器,對插入點之後的每一頁都算出錯誤索引。完整走訪找到十。一份檔案,三種答案
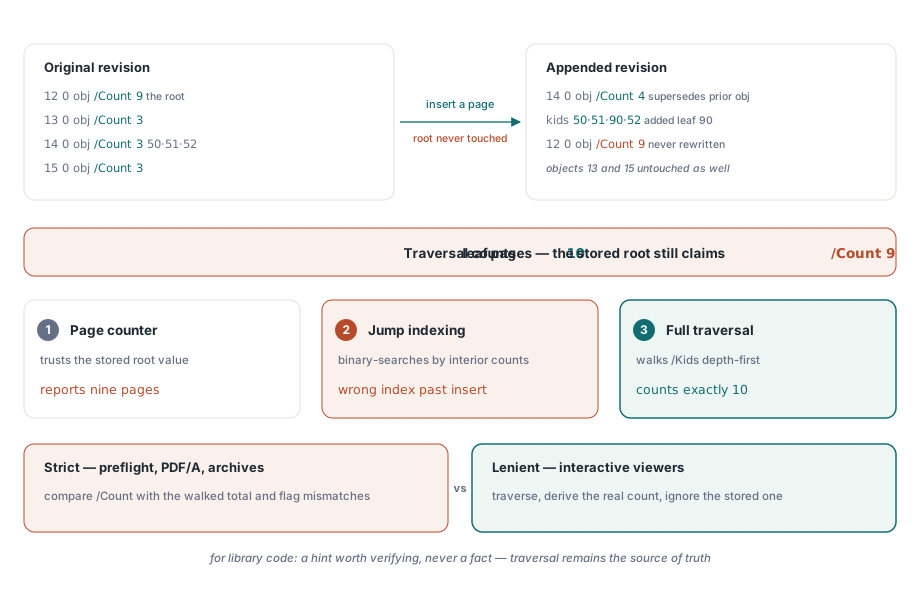
同一份檔案還有一種更安靜的咬法。讀根節點計數、開始走樹、收滿那個數量就停的程式碼,永遠看不到第十頁。沒有例外、沒有警告,就是一份少一頁的文件。把 /Count 當迴圈邊界或邊界檢查才是錯誤;走訪必須跑到樹被耗盡為止,管它儲存的數字寫什麼
第二種模式是從頭就不可能正確的計數:負數、有內容節點上的零、或荒謬的巨大值。這些來自模糊測試、傳輸損壞,偶爾來自編輯器裡的算術 Bug。它們的危險之處,恰恰針對信任 /Count 來做配置的程式碼。拿 -3 的 /Count 來配陣列,頂多拋個範圍錯誤;拿二十億的 /Count 來配,就是一次阻斷服務式的記憶體配置。這個值要當不可信輸入對待,跟檔案裡其他所有數字一樣
剖析器為此分成兩個陣營。嚴格的取用端——預檢工具、PDF/A 驗證器、封存管線——拿 /Count 對照走訪結果,拒收或標記檔案。互動式檢視器幾乎清一色寬容:它們走訪、推導出真實計數、默默無視儲存值,這正是計數過期的檔案能流通多年無人抱怨的原因,直到它撞進某個自動化流程裡更嚴格的剖析器。函式庫程式碼方面,我們認為中間路線才是正確預設:把 /Count 當預配置的提示,驗證過之後當子樹跳過的依據,真相始終交給走訪
在生產環境,這些失敗很少自我介紹成樹的問題。它們表現成頁面洗牌、合併後結尾少一頁,或重新排序後某頁變了尺寸或方向。偵錯案例研究 把其中一份報告一路追回樹裡。至於周邊的檔案解剖學(物件、交叉參照資料、trailer),PDF 檔案結構總覽 是起點
HotPDF Delphi 元件 在內部處理了這一切:走訪任意深度的巢狀樹、在複製或搬移頁面時解析繼承屬性,並把 /Count 對照實際葉頁數驗證而非照單全收,所以它 API 裡的頁面索引永遠指邏輯頁面