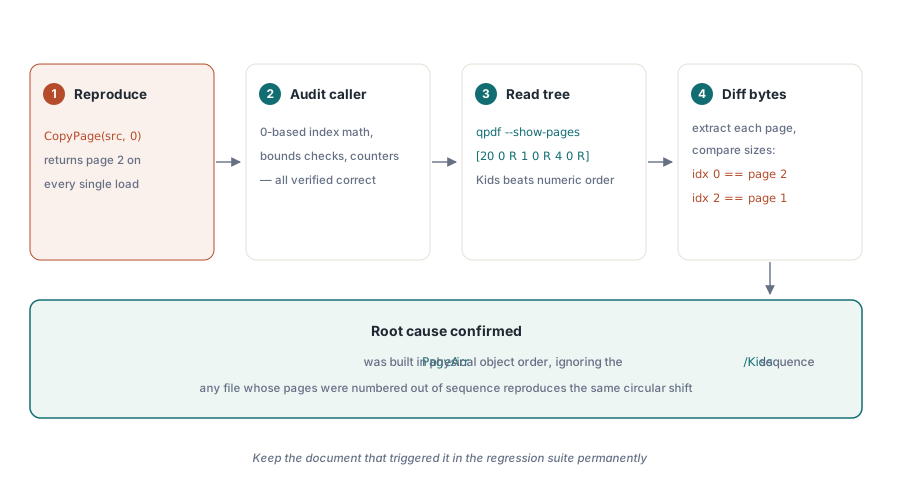
經典的症狀看起來像個差一錯誤:頁面複製程序對一份三頁文件要求第 1 頁,卻始終拿到第 2 頁。索引邏輯檢查過了:呼叫用的是 0 起算的邏輯索引,算術正確,邊界條件也沒問題。但每次輸出的都是錯的頁面
原因根本不在複製程式碼裡,而在載入器怎麼建出它的頁面陣列——這是 PDF 解析裡最容易踩的陷阱之一
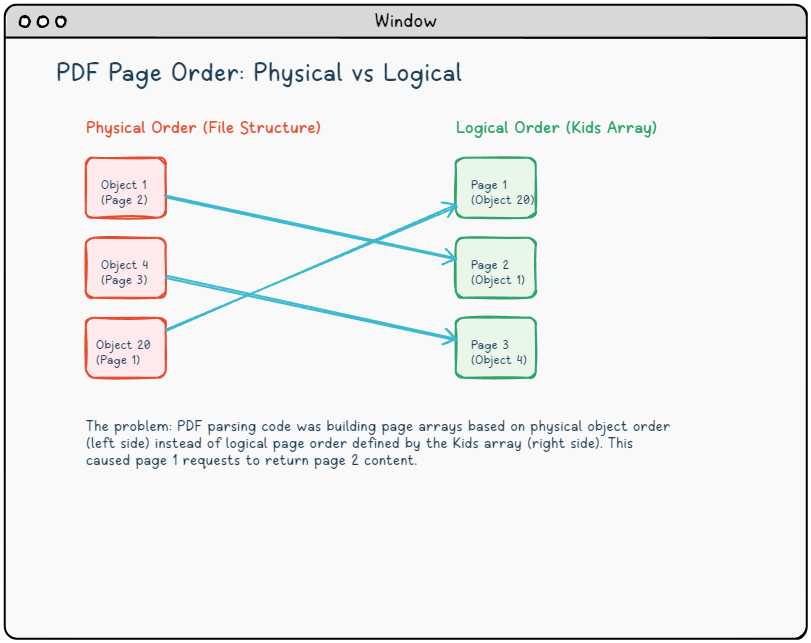
兩種排序,一個混淆的來源
PDF 檔案是間接物件的集合,每個物件都由一個物件編號來識別;檔案結構並未強制要求這些編號必須反映閱讀順序;物件 1 可以容納第 2 頁,物件 20 可以容納第 1 頁;實際定義閱讀順序的是頁面樹:這是一個 /Pages 字典的階層結構,其 /Kids 陣列列出了檢視器應顯示的頁面參考順序 (ISO 32000-1 §7.7.3)
下面這棵頁面樹正好踩中這個陷阱:
{ 頁面樹根節點,物件 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { 邏輯第 1 頁 }
         1 0 R    { 邏輯第 2 頁 }
         4 0 R]   { 邏輯第 3 頁 }
>>
endobj
該檔案在位元組串流中恰好將物件 1 和物件 4 列在物件 20 之前;任何以檔案順序反覆運算間接物件並在發現頁面類型字典時將其標記到 PageArr 中的解析器,最終會得到索引 0 為物件 1、索引 1 為物件 4,以及索引 2 為物件 20;邏輯上的第 1 頁位於 PageArr[2],請求頁面索引 0 反而會擷取邏輯上的第 2 頁
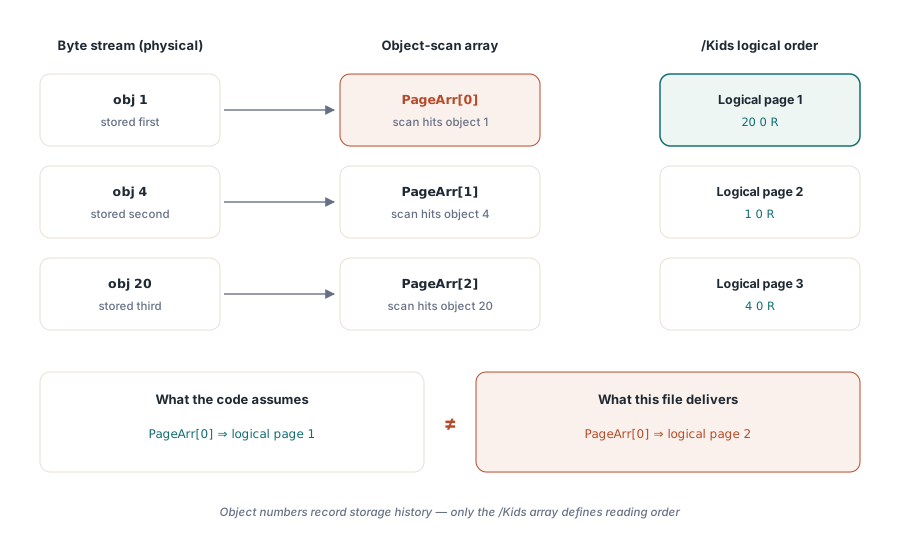
證實假設
在動任何程式碼之前,先把不符證明出來,而不是憑假設行事。qpdf 命令列工具讓這件事變得很直接:
{ shell }
qpdf --show-pages input.pdf
{ 輸出揭示 Kids 順序:20 0 R,接著 1 0 R,再接著 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ 顯示依閱讀順序排列、含 /Kids 的 Pages 字典 }
單獨擷取每一頁並比較檔案大小,證實了這份對應關係:物件掃描的 PageArr[0] 產生的內容屬於邏輯第 2 頁,而 PageArr[2] 持有的是邏輯第 1 頁。循環偏移就是決定性證據。這也解釋了為什麼這個症狀會出現在各種不同的來源文件上:只要哪份 PDF 的頁面物件碰巧拿到比某個更早的邏輯頁面更低的物件編號,它就會中招
PDF 會落到這個狀態,原因很直接。增量更新會保留它所改物件的物件編號,但它新增的任何東西——比方說插在最前面的封面頁——都會拿到一個比檔案裡既有一切更高的新編號,而它的參照卻排進 Kids 陣列的開頭。合併或重組文件的工具按自己方便的順序重新編號物件。有些產生器乾脆按方便內容串流的順序寫頁面,而不是按邏輯頁面順序。PDF 格式並不要求它們非得照規矩來
正確做法:遵循 Kids 陣列
建立頁面清單的正確方式,是從型錄根沿著 /Kids 鏈結走訪,而不是掃描間接物件。走訪必須遞迴,因為大型文件通常把頁面拆散在中間的 /Pages 節點下;它還該防著格式錯亂、回指到自己祖先的樹。下面的示意程式裡,TPdfDict 與 TPdfArray 代表您解析器所用的字典與陣列型別:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // 迴圈或病態深的樹
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // 跟著間接參照走
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // 中間節點
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // 葉子:顯示順序裡的下一頁
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// 用法:從型錄的 /Pages 條目開始
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
有兩個細節是刻意的。缺少 /Type 條目的葉子仍會被當成頁面,因為有些寫入器就是會省略它,而檢視器照樣開得了那些檔案。最後那個 /Count 比對幾乎零成本,卻能在呼叫者拿索引跳進樹裡之前,攔下被截斷或手工改過的樹
如果您是用 HotPDF 載入文件,這份排序在文件載入時就已經解析好了:頁面索引遵循頁面樹的顯示順序,包含巢狀的 /Pages 節點,所以索引 0 永遠是檢視器顯示的第一頁。上面的走訪程式,是給直接解析 PDF 結構的您自己的程式碼用的
以邏輯索引複製:CopyPageFromDocument
因為 HotPDF 在載入時就解析好頁面順序,邏輯頁面索引的意義與呼叫者的預期一致。高階的 CopyPageFromDocument 接受 0 起算的邏輯索引,把正確的頁面複製進目標文件:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { 複製邏輯頁面 0(使用者看到的第一頁) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;因為索引就是顯示順序索引,即使面對物理順序與邏輯順序分歧的文件,CopyPageFromDocument 的行為也正確。批次操作方面,InsertPagesFromDocument 接受邏輯索引陣列,一次跑完就把它們全部複製
這揭示了關於 PDF 解析的什麼內容
PDF 規範非常明確:邏輯頁面順序由頁面樹的 /Kids 陣列定義,而不是由物件編號或位元組偏移量定義 (ISO 32000-1 §7.7.3.2);任何使用不同排序作為捷徑的解析器,都會在其看到的大多數文件上產生正確的結果,因為大多數產生器以自然順序寫入頁面並分配順序物件編號;該錯誤會一直隱藏,直到有人載入了被增量編輯、被另一個工具重新組織或由選擇了不同版面配置的軟體所產生的 PDF
只拿自己產生的 PDF 來測,會完全漏掉這一類問題。頁面順序的處理需要一份來源多元的文件測試語料庫:增量儲存的、插入了封面頁的掃描文件,以及由以不同方式線性化或最佳化物件圖的工具產生的 PDF。任何物理順序與邏輯順序分歧的文件,都值得在語料庫裡有個永久的位置
HotPDF Delphi Component 的產品頁涵蓋頁面操作的完整 API,包括 CopyPageFromDocument、InsertPagesFromDocument 與 MovePage