把頁面描述剝掉之後,剩下的是一層薄薄的結構,沒有人會把它印出來,但每個閱讀器、索引器與封存系統都仰賴它。頁面物件對自己隸屬的章節、寫下它的作者,或是連往別處的註腳,一無所知。那些知識住在上一層,在三種掛到文件目錄上的結構裡:中繼資料串流、大綱樹,以及逐頁的註記陣列。它們有個共通特質,使它們特別容易出錯。三者都不會在頁面上留下可見的痕跡,所以一份檔案可以呈現得完美無缺,卻少了書籤、與自己的作者欄位互相矛盾,或是把某個連結指向一個已不存在的頁面物件
這一層正是 PDF 程式庫以文件屬性、書籤 API 以及連結或註記呼叫所暴露出來的東西,也是搜尋爬蟲用來判斷您的文件在講什麼的那一層。它底下的物件模型,在PDF 文件結構逐步導覽一文中有交代。這裡的焦點嚴格鎖定在掛在文件目錄上的那些東西
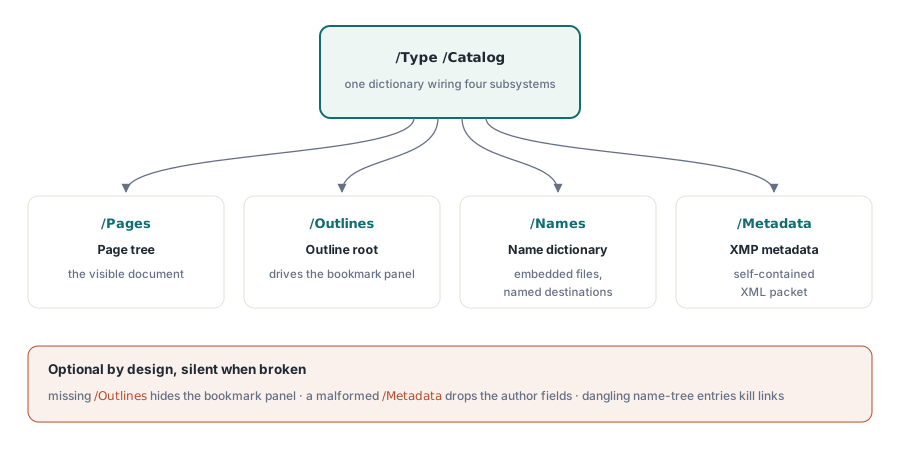
這三種結構都掛在文件目錄上。一份把它們全接起來的完整目錄長這樣:
1 0 obj
<< /Type /Catalog
   /Pages 2 0 R
   /Outlines 3 0 R
   /Names << /EmbeddedFiles 4 0 R >>
   /Metadata 5 0 R
>>
endobj四個條目,四個各自獨立的子系統。/Pages 是看得見的文件;/Outlines 是書籤樹;/Metadata 指向 XMP 串流;/Names 通往整份文件層級的名稱字典,其中除了別的東西之外,也裝著內嵌檔案附件。每一個都是選用的,而一個一項都找不到的閱讀器,照樣顯示得出頁面。這種選用性正是為什麼當檔案被只懂頁面的工具編輯過之後,導覽層總是最先爛掉的那一層
兩個互相矛盾的中繼資料存放處
PDF 同時把文件中繼資料放在兩個地方,而麻煩就從它們說法不一致開始。原本的機制是文件資訊字典,由檔尾的 /Info 參照:那是一組扁平的鍵值對,涵蓋 /Title、/Author、/Subject、/Keywords、/Creator、/Producer 以及兩個日期。它很簡單,而且每個檢視器都讀得懂。PDF 2.0 把它大部分內容標為已淘汰,改推第二套機制,也就是 XMP 中繼資料串流
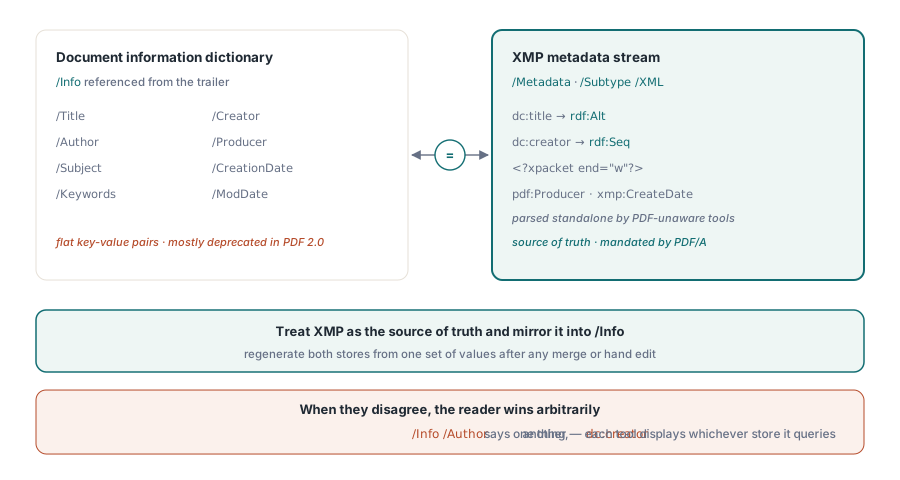
XMP 是一份自足的 XML 文件,以 RDF 撰寫,存成一個由文件目錄透過 /Metadata 抵達的串流,並標記為 /Type /Metadata /Subtype /XML。與埋在 PDF 物件結構內部的 Info 字典不同,XMP 封包的設計,就是要讓完全不懂 PDF 的工具能單獨把它擷取出來剖析。以下是一個具代表性的封包:
5 0 obj
<< /Type /Metadata /Subtype /XML /Length 1235 >>
stream
<?xpacket begin="" id="W5M0MpCehiHzreSzNTczkc9d"?>
<x:xmpmeta xmlns:x="adobe:ns:meta/">
  <rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#">
    <rdf:Description rdf:about=""
        xmlns:dc="http://purl.org/dc/elements/1.1/"
        xmlns:xmp="http://ns.adobe.com/xap/1.0/"
        xmlns:pdf="http://ns.adobe.com/pdf/1.3/">
      <dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report</rdf:li></rdf:Alt></dc:title>
      <dc:creator><rdf:Seq><rdf:li>A. Author</rdf:li></rdf:Seq></dc:creator>
      <xmp:CreateDate>2026-06-16T10:46:27+08:00</xmp:CreateDate>
      <xmp:CreatorTool>Reporting Service 4.2</xmp:CreatorTool>
      <pdf:Producer>losLab PDF Library</pdf:Producer>
    </rdf:Description>
  </rdf:RDF>
</x:xmpmeta>
<?xpacket end="w"?>
endstream
endobj那段區塊裡有三個細節,決定了這份中繼資料能不能在真實工具鏈中存活。xpacket 處理指示不是裝飾:它們框住封包,好讓擷取器能在更大的位元組串流裡找到它,而漏掉結尾 <?xpacket end="w"?> 的寫入器,產出的檔案開得起來,卻會被嚴格的驗證器挑掉。屬性的資料型別同樣要緊。dc:title 是包在 rdf:Alt 中的語言替代項,而 dc:creator 是有序清單,要用 rdf:Seq;把其中任一個寫成裸的文字節點,是最常見的 XMP 錯誤,多數檢視器都容忍它,直到碰上那個不容忍的為止。命名空間前置詞只是慣例,但它們繫結到的 URI 才是規範性的:剖析器認的是 URI,不是前置詞
有兩處存放時的硬性規則是:它們必須一致。如果 /Info 說作者是某人,而 dc:creator 指名另一人,您就出貨了一份對同一個問題給出兩種答案的文件,哪個答案勝出,取決於消費端工具讀的是哪個欄位。程式庫通常會替您兩邊都寫,但只要您手動改了其中一邊,或是合併了來自不同產生器的檔案,兩者就會漂開。請把 Info 字典當成舊制相容,把 XMP 當成真理來源,並以同一組值重新產生兩者,而不是各自打補丁。對 PDF/A 而言,這變成一項符合性要求:ISO 19005 強制使用 XMP,並禁止任何與其 XMP 對應項互相矛盾的 Info 屬性
書籤面板背後的大綱樹
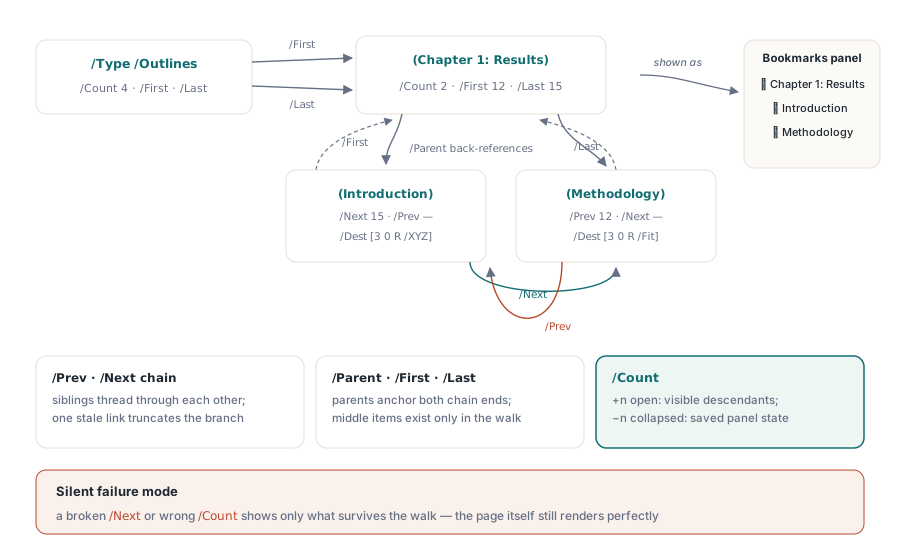
檢視器顯示為書籤面板的東西,在檔案裡是一棵由字典組成的雙向鏈結樹,稱為文件大綱。文件目錄透過 /Outlines 指向一個大綱根字典;根節點指向它第一個與最後一個頂層項目;而每個項目都與它的鄰居和父節點串在一起。檔案裡任何地方都沒有一個「書籤陣列」。整個結構是靠追蹤參照重建出來的,這正是為什麼單一條斷掉的鏈結,就能讓一整個分支從面板上消失,還不會報任何錯
8 0 obj                                    % 大綱根節點
<< /Type /Outlines /Count 4 /First 9 0 R /Last 9 0 R >>
endobj
9 0 obj                                    % 頂層:一個章節
<< /Title (Chapter 1: Results)
   /Parent 8 0 R /Count 2
   /First 12 0 R /Last 15 0 R >>
endobj
12 0 obj                                   % 第一個子項目
<< /Title (Introduction)
   /Parent 9 0 R /Next 15 0 R
   /Dest [3 0 R /XYZ 72 720 0] >>
endobj
15 0 obj                                   % 第二個子項目,也是最後一個同層項目
<< /Title (Methodology)
   /Parent 9 0 R /Prev 12 0 R
   /Dest [3 0 R /Fit] >>
endobj
把這些鏈結讀一遍,不變量就顯而易見了。每個項目都指回它的 /Parent。同層項目透過 /Prev 與 /Next 串成一條鏈,第一個省略 /Prev,最後一個省略 /Next。父節點以 /First 與 /Last 指名它的第一個與最後一個子項目,夾在中間的子項目只能靠走同層鏈才到得了。錯一個,失敗就是無聲的:一條過期的 /Next 會把章節截斷,一個 /Last 沒能終止鏈結的父節點會讓項目變成孤兒,而檢視器就只呈現它搆得到的部分
/Count 欄位裝著一項會讓人意外的狀態。在根節點與任何展開的項目上,它裝的是目前可見的後代數量;在收合的項目上,它是一個負數,其絕對值代表展開後會出現多少後代。所以 /Count 不是關於這棵樹的固定結構事實,它是面板存下來的展開或收合狀態,而把它寫死成正的總數的產生器,會把作者原本想留著收合的每一個分支通通打開
每個項目都靠指向某處來取得它存在的意義。/Title 是面板上顯示的內容;/Dest 是點下去會落到的地方。目的地可以像上面那樣行內寫在項目裡,也可以是一個透過文件名稱字典解析的名稱;當許多書籤與連結指向同一批位置時,後者是更好的選擇,因為目標搬家時您只要在一個地方修。程式庫通常把這棵樹藏在一個大綱根控制代碼與幾個新增子項目的方法後面;在 HotPDF 中,文件暴露一個型別為 THPDFDocOutlineObject 的 OutlineRoot,並在您附加項目時替您串好 /Prev、/Next、/Parent 與 /Count 鏈結。這件事值得好好利用,因為跨多次編輯手工維護那些不變量,正是大綱壞掉的地方
目的地:點擊會落到哪裡的文法
書籤與連結註記都指向目的地,而目的地不只是一個頁碼。它是一個陣列,先指名一個頁面物件,再透過第二個槽位上的動詞,指定檢視器該怎麼取景。最常見也最常被濫用的是 /XYZ,形式為 [page /XYZ left top zoom]。它的三個運算元彼此獨立,任何一個都可以是 null,意思是「這一項維持讀者原本的設定」。所以 [page /XYZ null null null] 會跳到該頁而不動捲動位置或縮放,這通常正是您希望一個「前往某頁」連結該做的事。這些數字位於預設使用者空間,從左下角量起、y 值向上遞增,與頁面內容使用的座標系統相同。從螢幕排版背景過來的作者,會反射性地從上方量起,然後把讀者送到頁面錯誤的那一端
/Fit 這一家族以精確定位換取韌性。[page /Fit] 把整頁縮放進視窗,[page /FitH top] 以指定的上緣讓頁寬填滿,而 [page /FitR l b r t] 把一個矩形放大到填滿檢視。由於這些是從頁面幾何而不是固定座標算出縮放的,所以頁面尺寸改變後,/Fit 目的地依然做得出合理的事,反觀寫死縮放值的 /XYZ 目的地,可能讓讀者盯著頁邊空白發呆。對目錄頁而言,帶著章節上緣座標的 /FitH,比帶著猜出來之縮放值的 /XYZ 更耐得住時間
註記:所有不屬於頁面內容的互動元素
註記是一種疊在頁面上、卻不屬於頁面內容串流的物件。連結、便利貼、螢光標示、表單小工具、檔案附件圖示、圖章:全都是註記,列在它們所在頁面的 /Annots 陣列中。把某個註記從那個陣列裡移掉,它就從頁面上消失了,即使底層內容完全沒被動過。這正是重點所在:註記是一個編輯層,與它們所覆蓋的那些痕跡分離
每個註記都共用一小根脊椎。/Subtype 指名種類,/Rect 以頁面座標給出它的定界方框,而 /Contents 裝著兼作無障礙描述的文字。連結註記是值得研究的案例,因為它有兩種形式:一個裸的目的地,以及一個動作
12 0 obj                                    % 連往某個目的地的連結
<< /Type /Annot /Subtype /Link
   /Rect [100 200 300 250]
   /Border [0 0 0]
   /Dest [5 0 R /XYZ null null null] >>
endobj
13 0 obj                                    % 執行某個動作的連結
<< /Type /Annot /Subtype /Link
   /Rect [50 50 200 100]
   /Border [0 0 0]
   /A << /Type /Action /S /URI /URI (https://www.example.com) >> >>
endobj
/Rect 是一塊熱區;在它裡面點擊,就把讀者送往目的地,沿用大綱所用的同一套文法。/Border [0 0 0] 是有實際作用的,它壓掉檢視器預設會在連結四周畫出的那個難看方框。第二種形式把裸的 /Dest 換成 /A 動作,由它的 /S 子類型挑選行為:/GoTo 在本檔案內、/GoToR 前往另一個檔案、/URI 指向網址、/Launch 執行外部程式。最後那個值得懷疑。啟動可執行檔的 /Launch,正是讓 PDF 成為惡意程式載體的那種行為,所以相容的檢視器會封鎖它或大聲提示,對多數讀者而言那個連結就是失效的。請伸手拿 /URI 與 /GoTo,別碰 /Launch
像螢光標示與便利貼這類標註註記,以及像 /Square 這類形狀註記,多了一層皺褶:它們在螢幕上的樣子,並不是由型別推導出來的。除非您用外觀串流(也就是 /AP 條目,它參照一個裝著繪圖運算子的表單 XObject)把外觀釘死,否則檢視器會自己畫一個版本。省掉它,同一個螢光標示在兩個閱讀器裡就可能長得不一樣,或者在編輯器往返前後長得不一樣。凡是精確外觀屬於文件一部分的東西,都請提供 /AP。順帶一提,檔案附件重用的是同一套機制:一個內嵌檔案串流加上一個檔案規格字典,以 /FileAttachment 註記或透過文件目錄 /Names 底下的 /EmbeddedFiles 名稱樹浮現出來
這一層會在哪裡壞掉,又該怎麼抓
貫穿這一切的常見失效是懸空的參照。當文件目錄沒有 /Outlines 條目,或是同層鏈結在樹中途斷掉時,書籤就不再出現;當 XMP 串流缺少它的 /Type /Metadata /Subtype /XML 標記,或是 xpacket 外框格式不良時,中繼資料就被忽略。在每一種情況裡,頁面內容都好端端的,所以隨手一開看起來都對,缺陷只在沒人檢查的那個面板裡現形
兩個成本低廉的習慣能抓到其中大部分。用真正的檢視器打開完成的檔案,把書籤面板與抽樣的連結點過一遍,這會像讀者那樣走一遍參照圖。接著用另一套工具把中繼資料讀回來,確認 Info 字典與 XMP 說法一致,那是再怎麼點都看不出來的唯一一種不一致。若您透過一個自己扛下鏈結記帳工作的程式庫產生這一層,這些陷阱大多根本不會開啟。適用於 Delphi 與 C++Builder 的 HotPDF Delphi 元件以文件層級 API 暴露大綱、註記與中繼資料結構,讓您只要描述書籤階層與連結,剩下的參照串接就交給它。至於這些結構所依附的物件模型,PDF 檔案結構技術概覽涵蓋了它們仰賴的文件目錄與交叉參照表