設計師為標題挑選帶有單層 a 的字型,為表格挑選帶有斜線的零,或是為封面挑選一組帶有花飾的草書大寫字母 (swash capitals)。這些字形 (glyphs) 已經在字型裡了。它們只是不是預設值。預設的 a 會從字元透過 cmap 表映射到一個字形,而替代字 (alternate) 則位於幾個字形 ID 之外,只有透過替換規則 (substitution rule) 才能存取。要在 PDF 中產生那個替代字,意味著讀取規則,並在內容串流中發出替換字形。這篇文章是關於在沒有底層原生塑形函式庫 (shaping library) 的 Object Pascal 中,如何讀取那些單一替換 (single-substitution) 類型的規則
範圍刻意縮小。樣式集和替代字是「單一字形進,單一字形出」的替換。它們是 OpenType 佈局中,您可以透過小型、確定性的表格走訪來解析的部分,這使它們非常適合希望保持無 C 語言依賴的 Pascal 引擎
為何使用純 Delphi 而不是 HarfBuzz
對於「將這段文字塑形 (shape)」這個問題,HarfBuzz 是顯而易見的答案,而對於完整的雙向 (bidirectional)、印度系或阿拉伯文塑形,它是正確的答案。它同時也是一個 C 函式庫。將它綁定到 Delphi 或 C++Builder 產品中,意味著必須為每個目標平台和架構發佈一個原生物件、符合它的呼叫慣例 (calling convention)、追蹤它的發佈節奏,並將它的授權條款與您自己的相對照。這些孤立來看都不難。但所有這些都是永遠不會消失的摩擦,而且當實際需求只是「給我這個字母的 ss01 形式」時,它完全沒有帶來任何好處
單一替換不需要塑形引擎。它需要的是一個能解析少數幾種 GSUB 子表 (subtable) 格式的解析器,外加一兩次二分搜尋。用 Pascal 撰寫這些,能把整個工具鏈留在同一個編譯器內。這個查詢只回答一個問題——在這個功能下,這個字形由哪個字形取代——而這正是樣式工作所問的問題;雙向解析、印度系文字重排與情境塑形是序列層級的問題,屬於塑形階段的工作
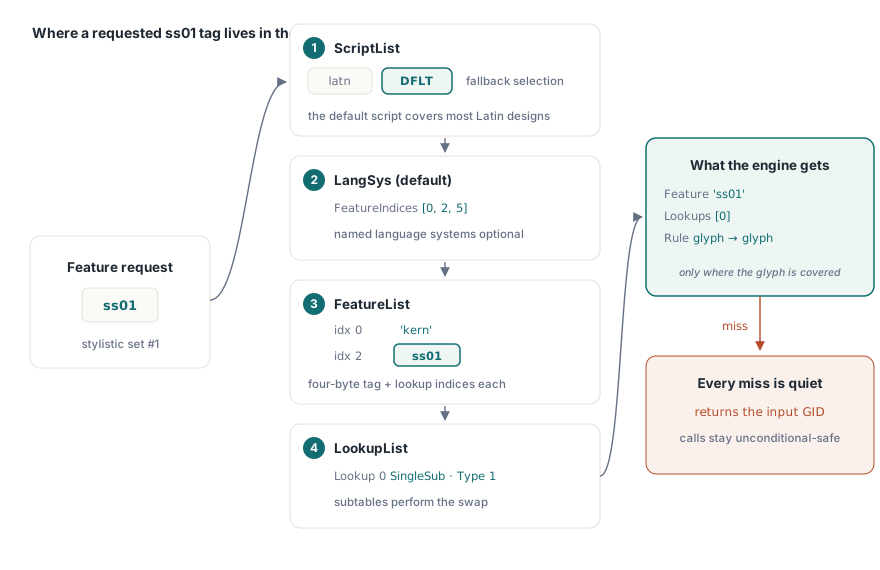
GSUB 層次結構,由上到下
字形替換表 (Glyph Substitution table) 是組織成一連串的間接引用,而替換查詢會從頂部開始走訪這個鏈條。在頂部是 ScriptList (文字列表)。像 latn 這樣的文字標籤 (script tag) 會選擇一個條目,而特殊的標籤 DFLT 是在沒有更特定的文字符合時套用的預設文字。文字條目指向一個 LangSys,也就是語言系統,有一個針對常見情況的預設 LangSys,以及針對需要不同行為的語言的可選命名 LangSys。土耳其語是常見的例子,其中帶點和無點的 i 需要它們自己的處理方式
LangSys 命名了一組功能索引。每個索引指向 FeatureList 內部,功能記錄中攜帶一個四位元組的標籤(ss01 是其中之一)和一個查詢索引列表。那些索引最後指向 LookupList,實際的替換子表就位在那裡。因此,解析 ss01 意味著:找到文字 (script),找到它的 LangSys,找到標籤為 ss01 的功能,收集它命名的查詢,然後套用它們。HotPDF 預設為 DFLT 文字和預設的 LangSys,這就是絕大多數拉丁文字設計發佈的內容,如果字型將其功能綁定在特定的文字下,它也暴露了一種覆寫文字標籤的方法
覆蓋表 (Coverage tables) 決定誰參與
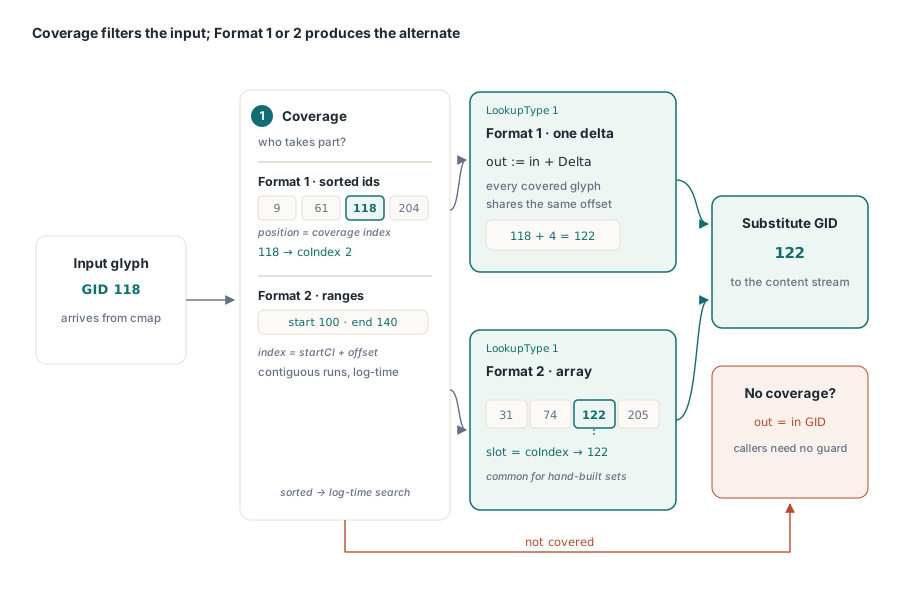
每個替換子表都以同一個問題開始:這個輸入字形是否參與這個規則,如果是,它在規則自身的索引中位於哪裡。這個問題由 Coverage (覆蓋) 表回答,而答案是一個覆蓋索引,這是一個小的序數,子表的其餘部分會用它來查找字形變成了什麼
Coverage 有兩種格式。格式 1 是一個按遞增順序排序的字形 ID 列表。您透過二分搜尋找到一個字形,而它在列表中的位置就是它的覆蓋索引。格式 2 是一個範圍記錄列表,每個記錄包含一個開始字形、一個結束字形,以及開始字形對應的覆蓋索引。在範圍內的字形,透過從範圍起點的位移來獲得其覆蓋索引。當參與的字形分散時,格式 1 是緊湊的;當它們落入連續的區段時,格式 2 是緊湊的。兩者都已排序,所以兩者的搜尋時間都是對數時間,而且兩者都會回傳一個覆蓋索引,或是乾淨俐落的「未覆蓋」,讓引擎不去動該字形
單一替換 (Single Substitution),兩種格式
單一替換是 LookupType 1,它將一個字形映射到恰好一個替換字形。它也有兩種格式,這種區分是為了空間最佳化。格式 1 儲存單一個有號的差值 (delta)。輸出的字形 ID 是輸入的字形 ID 加上該差值,再對 65536 取模。這就是字型編碼替換的方式,其中每個參與的字形都與其替代字形位於相同的固定位移處,例如一組等高數字 (lining figures) 放置在距離匹配的舊式數字固定距離的地方。Coverage 表說明了哪些字形符合條件,而一個差值就能服務所有字形
格式 2 儲存了一個明確的替換字形 ID 陣列。來自 Coverage 表的覆蓋索引,就是這個陣列的索引,所以覆蓋索引為 0 的字形變成第一個陣列條目,覆蓋索引為 1 的變成第二個,依此類推。當替代字形沒有統一的位移時,就會使用格式 2,這是手工建立的樣式集常見的情況。從呼叫者的角度來看,無論哪種方式的查詢都是相同的。拿著輸入的字形,讓它通過 Coverage,如果它被覆蓋,就套用差值或讀取陣列插槽
var
  Pdf: THotPDF;
  BaseGID, AltGID: Word;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.BeginDoc;
    Pdf.RegisterUnicodeTTF('C:\Fonts\MyStylisticFace.ttf');
    Pdf.CurrentPage.SetFont('My Stylistic Face', [], 12);

    // 透過字型的 cmap 取得 'a' 的預設字形。
    BaseGID := Pdf.GetUnicodeGlyphForCodepoint(Ord('a'));

    // 樣式集 1:透過 GSUB LookupType 1 解析替代字形。
    AltGID := Pdf.GetSingleSubstituteGlyph(BaseGID, 'ss01');

    // AltGID = BaseGID 表示該功能未對這個字形產生影響。
    if AltGID <> BaseGID then
      { 在內容串流中輸出 AltGID };
  finally
    Pdf.Free;
  end;
end;
值得注意的是 pass-through (直通) 協定。GetSingleSubstituteGlyph 在每次未命中時都會原封不動地回傳輸入的字形 ID:沒有字型、沒有 GSUB 表、沒有匹配的功能、沒有覆蓋命中,都會如此。這意味著該呼叫無條件執行是安全的。您要求替代字形,如果沒有,您就會拿回與您輸入的完全相同的東西,所以呼叫程式碼永遠不需要為缺少該功能的字型編寫特殊情況
樣式功能標籤的含義
功能標籤是您要求哪種替代字形的全部詞彙,而與樣式工作相關的標籤是一份簡短的清單。最受注目的一對是 salt (樣式替代字,stylistic alternates),這是對字形替代形式的包羅萬象存取,以及 ss01 到 ss20,這是字型可以定義的二十個編號樣式集,每一個都是設計師組合在一起的具名替換包。例如,一個字型可能會將單層 a 和直腿 R 放在 ss03 下,因此啟用那一組就會重新設定兩者的樣式
圍繞在這些標籤周圍的,還有幾個單一替換標籤。aalt 存取所有替代字,這是字形擁有的每個替代字的聯集,通常以字形調色盤功能呈現。titl 選擇為大尺寸切割的標題大寫字母。subs 和 sups 換入真正的下標和上標數字,而不是縮小版的預設數字。ordn 產生序數形式,即 1st 和 2nd 中升高的字母。frac 構建分數,雖然完整的對角線分數也依賴連字和情境邏輯,這已超出了單純的單一替換。對於單一字形的情況,機制與 ss01 相同:將標籤傳遞給替換查詢,然後讀回替代字形
// 先嘗試樣式集功能,再退回一般的替代字形。
function ResolveAlternate(Pdf: THotPDF; BaseGID: Word;
  const PreferredTag: AnsiString): Word;
begin
  Result := Pdf.GetSingleSubstituteGlyph(BaseGID, PreferredTag);
  if Result = BaseGID then
    Result := Pdf.GetSingleSubstituteGlyph(BaseGID, 'salt');
  // 若兩個功能都沒有涵蓋此字形,仍維持 BaseGID。
end;
cmap 格式 12 與補充平面 (supplementary planes)
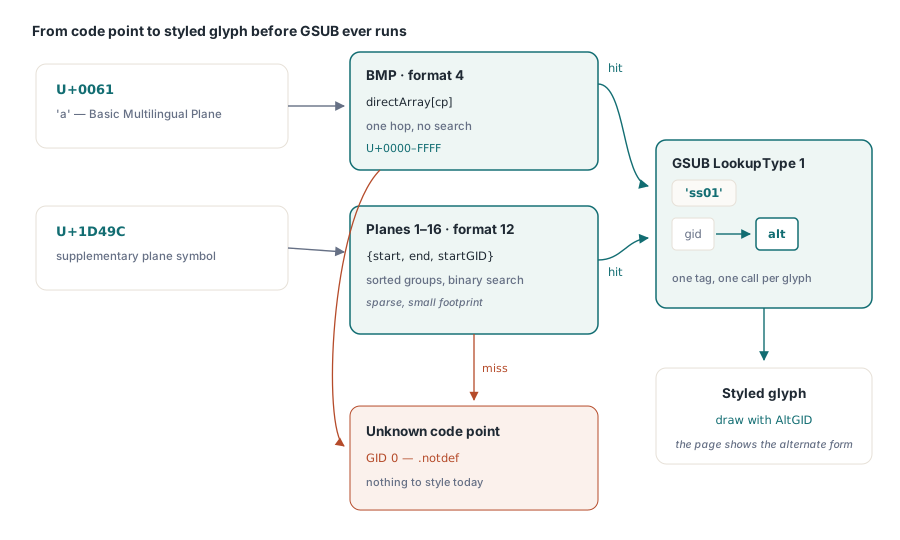
在任何替換能夠執行之前,字元必須先成為字形,這就是 cmap 表的工作。替換查詢從字形 ID 開始,所以路徑永遠是透過 cmap 將字元轉為字形,然後透過 GSUB 將字形轉為替代字。cmap 令人感興趣的部分是它的觸及範圍。格式 4 的子表涵蓋了基本多語言平面 (BMP),也就是前 65536 個字碼點 (code points),這對於大多數拉丁文字來說已經足夠了。但對於從 U+10000 往上的字碼點,也就是補充平面,這就不夠了,而數學英數字、許多符號,以及幾個現存的文字目前就位於那裡
格式 12 是涵蓋從 U+0000 到 U+10FFFF 完整範圍的子表。它是一個已排序的群組列表,每個群組包含一個開始字碼點、一個結束字碼點和一個開始字形 ID,所以連續的字碼點區段映射到連續的字形區段。HotPDF 解析字碼點的混合策略與資料形狀相符。BMP 中的字碼點是由以字碼點為索引的直接陣列提供服務,這是一次不需要搜尋的單一查詢。補充平面中的字碼點則是由以字碼點排序的稀疏表提供服務,並使用二分搜尋進行檢索。結果是 GetUnicodeGlyphForCodepoint 接受一個完整的 Cardinal,並能在整個範圍內給出正確的答案,對於字型未映射的任何字碼點,它會回傳字形 ID 0,即 .notdef 字形
var
  Pdf: THotPDF;
  Cp: Cardinal;
  GID, StyledGID: Word;
begin
  // 補充平面的字碼點:U+1D49C MATHEMATICAL SCRIPT CAPITAL A.
  Cp := $1D49C;
  GID := Pdf.GetUnicodeGlyphForCodepoint(Cp);  // 格式 12 查詢
  if GID <> 0 then
    StyledGID := Pdf.GetSingleSubstituteGlyph(GID, 'ss01')
  else
    StyledGID := 0;  // 字型沒有此字碼點對應的字形
end;
逐字形查詢與序列塑形的分野
單一替換 API 回答的是一種形狀的問題:LookupType 1,一個字形進、一個字形出。GSUB 其他的 lookup 型別處理的是序列——一個字形變成好幾個、好幾個變成一個,或規則只在字形出現在特定鄰域時才觸發。對角線分數、天城文 (Devanagari) 結合字,或阿拉伯文的詞首-詞中-詞尾串聯,都是這類序列問題,屬於塑形階段的職責,而不是逐字形查詢的工作
這樣的分工是刻意的。在這裡,呼叫者挑選功能標籤並逐字形套用,沒有任何東西替您檢查一段文字或擅自決定功能的套用順序。對於樣式集與替代字這種自選性質、作用範圍局部的能力來說,這正是對的工具;而讓逐字形路徑保持沒有序列邏輯,正是它能維持小巧且可預測的原因
對於確實需要序列層級工作的情況,我們關於 Delphi 中的複雜文字塑形 (complex-script text shaping) 文章接續了複雜文字的故事。如果您的替換是一個更大的報告工作的一部分,該工作還要在頁面上放置圖片和其他字型,帶有字型和圖片的報告輸出指南涵蓋了這些部分如何組合在一起。所有這些都在同一個引擎,即 Delphi 和 C++Builder 的 HotPDF 元件 上執行,該引擎搭載 GSUB 替換查詢,與本部落格其他地方涵蓋的字型嵌入、子集化 (subsetting) 和文字 API 搭配提供