手寫的 JBIG2 讀取器遇到第一份不尋常的檔案就會犯這個錯。它解析檔案標頭、解析第一個段標頭、讀取四個位元組的資料長度,然後把那麼多位元組當成段主體。在多數 .jb2 檔案上這樣完全正確。但在旗標位元組 bit 0 清零的檔案上,那些「主體」位元組其實是第二、第三、第四個段標頭,算術解碼器把它們變成一張噪點點陣圖,或一路衝出緩衝區末端。檔案沒有損壞——它用的是 ITU-T T.88 附錄 D.2 的隨機存取組織:所有段標頭排在前面,所有段資料依同樣順序跟在後面
隨機存取檔案很少見。它們出自檔案典藏與文件影像系統——這類系統希望讀取端在碰任何壓縮位元組之前,先看齊每一頁與每一個字典依賴。轉檔作業若把這種來源的檔案和普通掃描件混在一起,一份隨機存取檔案就可能藏在一批全是順序式的檔案中間。讀它們的解碼器,和處理 JBIG2 自訂 Huffman 表與標準前綴碼的是同一套原生 Pascal 解碼器,編碼側一概不變;變的只是找到段的順序
一個旗標位元組背後的三種檔案布局
PDF Library for Delphi 透過 PDFlibJBIG2 單元裡的 TPLJBIG2Decoder 讀取獨立的 JBIG2 檔案,解碼器自己從檔案標頭判斷布局。T.88 附錄 D 允許同樣的段排成三種方式:順序式(D.1)把每個標頭直接放在其資料前面;隨機存取式(D.2)把所有標頭排在最前、所有資料跟在其後;內嵌式(D.3)是其他容器裡用的無標頭形式。獨立檔案以八位元組識別碼 97 4A 42 32 0D 0A 1A 0A 開頭,接著一個旗標位元組,再一個四個位元組的頁數——除非旗標說頁數未知
旗標位元組的 bit 0 決定組織:1 是順序式,0 是隨機存取。bit 1 設位代表頁數未知、四個位元組的計數缺席,於是第一個段標頭從位元組 9 開始,而不是位元組 13。bit 2 到 7 保留;解碼器接受設了這些位的檔案而不拒收,因為一個亂設的保留位,說明不了段本身讀不讀得了
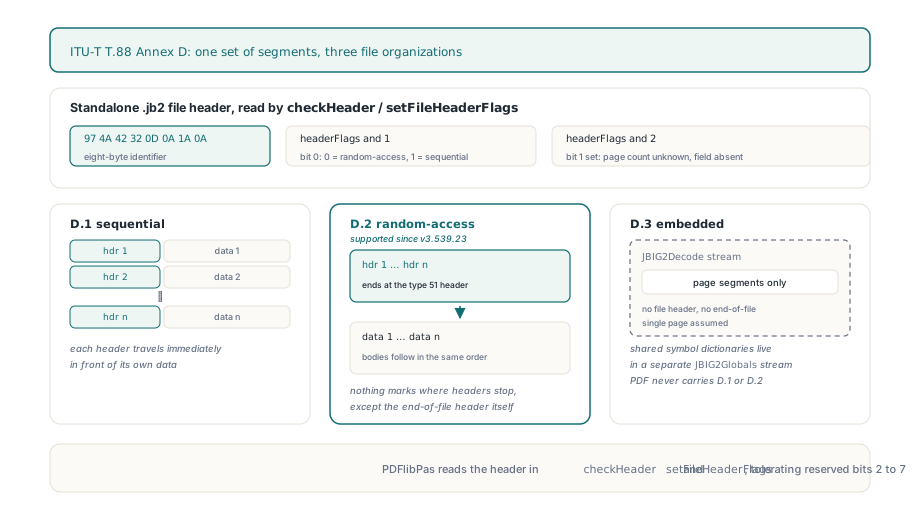
PDF 本身從不攜帶隨機存取布局。JBIG2Decode 圖像串流(ISO 32000-1 §7.4.7 所述)只以內嵌形式裝頁面段,共用的符號字典移進獨立的 JBIG2Globals 串流,沒有檔案標頭、end-of-page 或 end-of-file 段。解碼器找不到八位元組識別碼時,就把輸入當成那種串流:順序式、單頁。反過來,PDF Library for Delphi 把 JBIG2Decode 圖像匯出成原生 .jb2 檔案時,寫出旗標位元組 $03(順序式、頁數未知),並附加一個 end-of-file 段標頭。所以隨機存取永遠只從外部而來——作為一份直接交給 TPLJBIG2Decoder 的獨立檔案,通常正要被轉換或為 PDF 重新壓縮,配合 PDFlibPas 的 JBIG2 編碼器後端
為什麼不能按檔案順序讀隨機存取檔案?
因為除了 end-of-file 段標頭(類型 51)本身,位元組流裡沒有任何東西標示標頭塊在哪裡結束、資料塊在哪裡開始。JBIG2 段標頭沒有固定大小:被參照段數可以是三位元的短形式,或長形式再跟一張保留位圖;每個被參照段號依目前段自身編號的大小占一、二或四個位元組;頁面關聯欄位一個位元組或四個。讀取端必須解析標頭的每個欄位,才知道下一個標頭從哪裡開始
按檔案順序行走的順序式讀取器,把第一個標頭讀對,之後的一切讀錯。更糟的是它可能一時半刻還不自覺:吃進標頭位元組的通用區域解碼器產出的是像素而不是錯誤,直到某個後段的長度或引用檢查終於絆倒。我們的看法是:不先索引標頭的解碼器,應該直接拒收隨機存取檔案。明確的拒收,一批檔案只賠一份;一張看起來合理卻錯誤的點陣圖,會進檔案庫、並留在那裡
在解碼第一個主體之前,先索引每一個標頭
旗標位元組說是隨機存取時,PDF Library for Delphi 在解碼任何東西之前先對標頭塊掃一遍。每個標頭完整解析後即丟棄,唯一留下的是它在檔案裡的位元組偏移量。壓縮資料絕不會被複製進重排過的第二緩衝——在大型典藏掃描上這件事很要緊,因為資料塊可能占掉檔案的大半。掃描在第一個 end-of-file 標頭處停下,此時讀取位置正好落在第一個段資料的第一個位元組上
隨機存取檔案的冗餘比順序式少,所以預掃描是嚴格的。以下情況直接拒收:
- 標頭被緩衝區末端截斷,回報為
JBIG2 truncated random-access header at byte N,附上該標頭開始的偏移量 - 段號未嚴格遞增(以無號值比較),因為兩個標頭聲稱同一編號,會讓後段區域的被參照清單變得含糊
- 資料長度的最高位被設置——包括
0xFFFFFFFF的「未知長度」記號;這種布局裡沒有別的辦法找到下一個主體的起點,解碼器立即拒收,而不是向前掃描找結束記號 - end-of-file 標頭聲明任何資料,或乾脆沒有出現(
JBIG2 random-access file is missing its end-of-file header) - 聲明的長度加起來比剩餘位元組多,或少
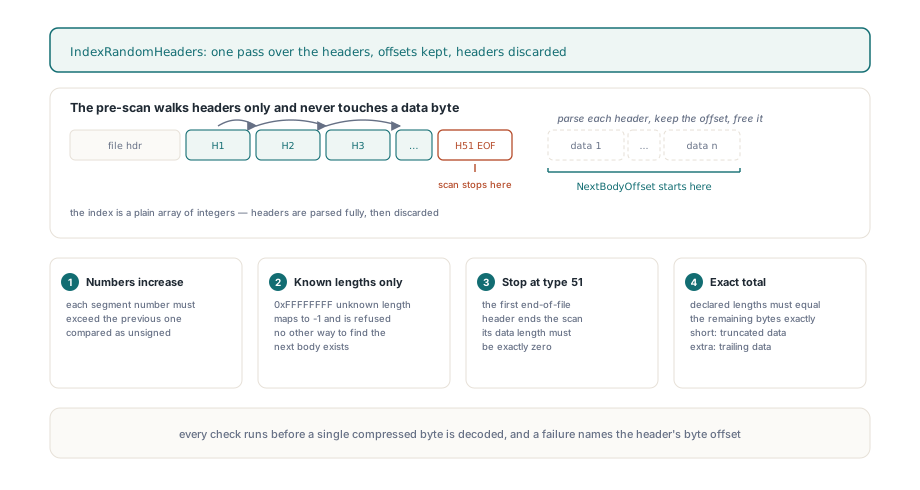
最後一條規則是大家最容易被絆倒的。最終主體之後多出一個位元組,就以 JBIG2 trailing random-access data 失敗。與順序式路徑相比顯得苛刻——順序式解碼在 end-of-file 段停下、之後的一切直接忽略。不對稱有它的理由。順序式布局裡每個標頭緊挨著自己的資料,末尾的雜物位移不了任何東西;隨機存取布局裡標頭是資料塊唯一的地圖,長度對不上時,解碼器分不清無害填充,和更早處丟失或多出、之後每個主體都跟著位移的那一個位元組
為什麼按位元組數跑的迴圈會漏掉最後一個 end-of-page 段?
「還有位元組就繼續」的迴圈在隨機存取檔案上收得太早,因為資料比標頭索引先耗盡。end-of-page(類型 49)和 end-of-file 段不帶任何資料位元組,通常排在最後。最後一個區域主體消化完時,讀取位置正好在緩衝區末端;按位元組數跑的迴圈在此退出,零長度的 end-of-page 段永遠等不到分派,頁面就此未完成
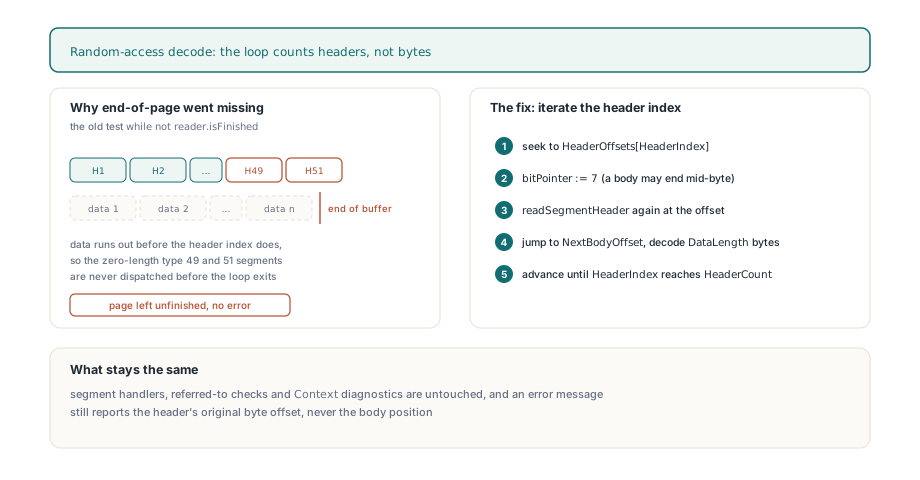
所以對隨機存取檔案,解碼器數的是標頭,不是位元組。每一步跳回下一個已索引的標頭、對齊位元組邊界(算術編碼的主體可能停在位元組中間)、重新解析標頭,然後向前跳到下一個主體的起點、按聲明長度越過它。解碼器提前收工的主體被跳到其聲明末端;讀過了頭的主體遭拒。從那裡起,段走與順序式檔案相同的處理器和引用檢查。解碼主體時拋出的錯誤帶著標頭的原始位置,形式為 JBIG2 segment N (type T) at byte B: ...,LastError 裡的偏移量因此指向十六進位編輯器裡找得到的東西
在 Delphi 裡載入隨機存取的 .jb2 檔案
應用程式碼不隨組織而改變。TPLJBIG2Decoder.LoadFromByteArray 偵測檔案標頭與布局,任何被拒的輸入回傳 False 並把原因放進 LastError,解碼後的頁面經 Width、Height 和 GetScanline 暴露——每像素一個位元組,黑為 1
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // 循序與隨機存取的獨立檔案走同一個呼叫
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
想知道某份檔案用的是哪種布局——為了記錄日誌,或為了在轉檔前把語料分類——自己讀那個旗標位元組就好。函式庫並不暴露它偵測到的組織,而九個位元組就夠了。下面的輔助函式是加進你自己程式碼的東西;它只是把 T.88 的標頭規則複述一遍:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// 你自己的輔助函式,不屬於 PDFlibJBIG2:按 T.88 檔案標頭為緩衝分類
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // 例如從 PDF 裡取出的內嵌串流
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // bit 1 設位:沒有四個位元組的頁數
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
批次作業:填充緩衝與被拒檔案
尾隨資料規則正是批次程式碼容易出錯的地方;當一份別處開得了的檔案被這樣拒收時,先看緩衝再看檔案。從資料庫 BLOB 欄位取出的 .jb2、固定大小的網路讀取、帶對齊填充的容器格式,都可能在真正的結尾之後送來幾個零位元組。順序式檔案對此聳聳肩;同樣填充的隨機存取檔案會以 JBIG2 trailing random-access data 失敗,被剪短幾個位元組的緩衝也一樣——以截斷名義失敗。請傳剛好是檔案本身的位元組、按來源真實長度取大小,永遠不要按區塊大小或容量
被拒的檔案也不留殘跡。LoadFromByteArray 在開始解碼前重置 Width、Height 和掃描列,失敗的呼叫回報零維度而不是上一份檔案的頁面,同一個解碼器實例可以直接接下一份檔案:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // 這裡 Width 和 Height 是 0;上一份檔案什麼都不會留下
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // 怪罪檔案之前,先查位元組是怎麼被存放的
      end;
  finally
    Decoder.Free;
  end;
end;
在自己的管線裡驗證這些行為,不需要稀有的樣本檔。把一份順序式 .jb2 重組成隨機存取布局,保留每個標頭和每個壓縮位元組,把 end-of-page 與 end-of-file 標頭挪到標頭塊末端,解碼出的像素必須與順序式原始檔完全一致——帶頁數欄位與不帶都要測。然後餵它每種截斷前綴、重複的段號、一個多餘的尾隨位元組和一份 0xFFFFFFFF 長度;每一個都應回傳 False 且 Width、Height 為零
解碼器回傳什麼,又期待什麼
這裡的隨機存取是檔案布局的性質。無論檔案用哪種組織,TPLJBIG2Decoder 都回傳第一頁的點陣圖,Width 和 Height 描述的也是那一頁。每個段都必須聲明資料長度;T.88 允許立即式通用區域使用 0xFFFFFFFF 記號,解碼器在兩種布局下都以 unknown or oversized segment length is not supported 拒收該記號。自訂 Huffman 前綴長度與表條目數的上限,與順序式檔案同一套
解碼 JBIG2 只是更長的圖像路徑中的一站,同一路徑還涵蓋 PDF 圖像擷取、重新壓縮與 JBIG2 編碼;PDF Library for Delphi 產品頁涵蓋管線的其餘部分與支援的圖像格式