把 JBIG2 Tables 區段(type 53)逐位元組倒出來看,第一個意外是它沒放進來的東西:Huffman 碼本身。您拿到一個 flags 位元組、兩個邊界值與一串小數字,那些數字就是碼長。編碼器與解碼器各自用 ITU-T T.88 Annex B.3 的程序,從碼長重建實際的位元樣式。重建順序稍有不同,得到的仍是合法的前綴碼——每個樣式都解得開、每個值都出得來,只是全貼在錯的樣式上
在用 Huffman 符號 ID 與編碼器自帶表格編碼的頁面上,這種錯位看起來像掃描品質差:字形偏了幾個像素、字元由錯的符號拼成、或者數字看著都合理,直到好幾個區段之後某個寬度超出範圍。PDF 裡的 JBIG2 多數是算術編碼,Huffman 編碼的 JBIG2 又多數只用 B.1 到 B.15 標準表。自帶表格的檔案很少見,而它們傾向一口氣同時操到表解析器、Huffman refinement 與未壓縮集體點陣圖
Tables 區段實際裝了什麼
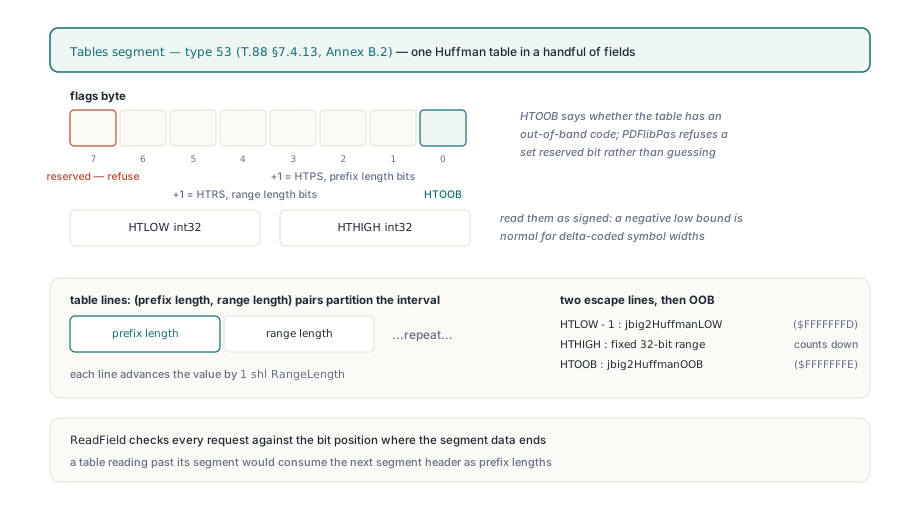
一個 Tables 區段描述且剛好描述一張 Huffman 表。T.88 §7.4.13 與 Annex B.2 把它排成一個 flags 位元組、帶號 32 位元的 HTLOW、帶號 32 位元的 HTHIGH,然後是把 HTLOW 到 HTHIGH 區間鋪滿的(前綴長度、範圍長度)配對。flags 的 bit 0 是 HTOOB,說明這張表有沒有帶外碼;bits 1 到 3 加一給出 HTPS,即每個前綴長度欄位的寬度;bits 4 到 6 加一給出 HTRS,即每個範圍長度欄位的寬度;bit 7 保留
手寫解析器第一個常絆倒的地方就是邊界。把 HTLOW 當無號數讀,一張從 -2 起始的表——對 delta 編碼的符號寬高來說稀鬆平常——突然宣稱自己從將近 43 億開始。PDF Library for Delphi 把兩個邊界都當帶號值讀,拒收 HTLOW 不小於 HTHIGH、或範圍長度超過 32 的表,並且每一次欄位讀取都對著「區段宣告資料結束的那個位元」檢查。最後這項檢查比聽起來要緊:讀過自己區段的表,會把下一個區段標頭當成前綴長度吃掉,解析出徹底的胡話。bit 7 被設位則以 reserved custom Huffman table flag 失敗。我們偏好這種拒收而不是猜:猜出來的表產生錯的像素,沒人追得回成因
正規行之後是 Annex B.2 的逃脫行。低範圍行從 HTLOW 減一起始、按 32 位元位移向下數;高範圍行從 HTHIGH 起始、帶 32 位元範圍;帶外行只在設了 HTOOB 時存在。這些行帶著與內建標準表相同的標記,所以自訂表與 Table B.6 走同一個解碼迴圈。一張自訂表最多 65,536 行
為什麼前綴碼必須按表格行序指派
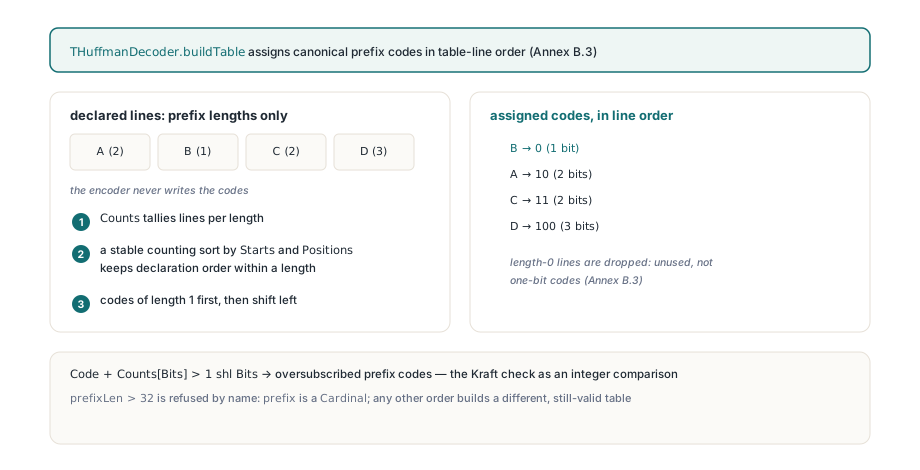
因為宣告順序是把位元樣式綁到值區間的唯一憑據。Annex B.3 統計每個前綴長度各有幾行、先發長度 1 的碼、左移進入長度 2,以此類推;同一長度內,碼按行在區段裡出現的順序發放。拿一張小表把這件事變具體:六行,按檔案順序標 A 到 F,前綴長度如下
| 行 | 前綴長度 | 碼(維持檔案順序) | B 與 D 對調後的碼 |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | 未使用 | 未使用 |
兩欄都是合法的前綴碼,只有左欄是編碼器的意思:B 與 D 一對調,樣式 100 解出的是 D 的值區間,解碼器就帶著錯誤區間的數字繼續走下去。F 行長度 0,B.3 定義為未使用;若給它一個一位元碼,後面所有指派全跟著位移
想拿到右欄,最省事的路是按前綴長度做通用排序。Delphi 的 TArray.Sort 與 TList<T>.Sort 都不穩定,等長的行回來時順序任意。要在自己的工具裡做標準碼,請改按檔案順序、每個長度各走一遍:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // 從 Tables 區段讀入的原值
    Code: Cardinal;       // 於下方指派
  end;

// Annex B.3 標準指派,寫給您自己的工具用。
// 等長的行維持檔案順序;長度 0 不取得碼。
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft 檢查:碼數超過這個長度裝得下的量
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // 平手時按檔案順序
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
把上面六行餵進去,A 得 00、C 得 01、B 得 100、D 得 101、E 得 110;F 沒有碼。PDF Library for Delphi 用計數法做同一件事——天生穩定,也不必把表掃 32 遍——並套用同樣兩道防護。超額訂閱的碼長以 oversubscribed Huffman prefix codes 失敗:放行的話,一個樣式可以對上兩行。超過 32 位元的前綴也指名拒收,雖然 T.88 白紙黑字允許。我們認為這個上限是對的取捨:每個碼塞得進一個機器字,而需要更長碼的檔案,更可能是壞了而不是聰明
值需要同樣的小心。低範圍行解出 HTLOW 減一再減 32 位元無號位移,中間值若用 32 位元 Integer,這個減法可能回繞成一個看起來正常的正寬度。解碼器用 64 位元計算,真結果塞不進帶號整數時丟 Huffman value exceeds signed integer range
選擇器順序,以及互相掩護的兩個陷阱
文字區域與符號字典都不指名自己的表。它們帶的是兩位元選擇器,每個設成 custom 的選擇器按 referral 順序取用被指清單裡的下一個 Tables 區段。T.88 §7.4.3.1.2 把文字區域選擇器排成 FS、DS、DT、RDW、RDH、RDX、RDY、RSIZE;§7.4.2.1.1 把符號字典選擇器排成 DH、DW、BMSIZE、AGGINST。值 0 與 1 挑標準表,3 挑自訂表,2 在只有兩張標準表的欄位上保留。PDF Library for Delphi 拒收保留的選擇器值;當選擇器要的自訂表多於區段指到的數量,以 missing custom Huffman table reference 失敗
自己寫解碼器的話,這裡有兩種容易犯的錯,而且互相掩護。第一種咬的是 Delphi,或 Delphi 模式的 FPC(objfpc 模式直接以重複識別碼拒絕這段程式碼):setter 的參數跟欄位同名。參數遮蔽欄位,Flags := Flags 變成自己賦值給自己,欄位永遠是零。於是每個選擇器都讀到零,文字區域不管檔案要什麼,FS、DS、DT 全用標準表 B.6、B.8、B.11,自訂路徑永遠不執行
第二種藏在符號字典裡。Huffman 字典可以把符號存成未壓縮集體點陣圖(BMSIZE 為零),每一行結尾補一個不滿的位元組。補位值是該位元組裡有效位元的個數,很容易誤讀成最低有效位元的位置:
// 集體點陣圖某一行的最後一個位元組,位元以 MSB 在前讀入。
// Padding := TotalWidth mod 8  -> 這個位元組裡「有效」位元的個數

// 錯誤:把 Padding 當成要複製的最低位元索引
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// 正確:最低有效位元索引是 8 - Padding(Padding = 0 時為 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel 代表您自己解碼器裡任何寫入像素的動作
用邊界寬度檢查一下。63 像素的行補位 7:錯的迴圈複製最後位元組的 1 個位元,對的複製 7 個。9 像素的行補位 1:錯的複製 7 個、對的複製 1 個。64 像素時兩者都複製全部 8 個,所以 8 的倍數永遠暴露不了它。寬 7 與寬 9 的合成集體點陣圖正好釘住位元組邊界的兩側。而傷害會蔓延,因為 refinement 拿這些符號當參照
自己的解碼器兩個陷阱都有時,除錯會很痛苦。只修 setter,自訂路徑終於跑起來,直接撞上壞掉的集體點陣圖,頁面照樣不對;只修補位,畫面毫無變化,因為自訂路徑仍然到不了。兩個修改都要先用合成輸入測過再信任。一個相關細節:Huffman 符號字典的輸入符號與新符號相加為一時,log2 公式算出的符號碼長為 0,但 Huffman 變體寫每個符號 ID 至少要一個位元。PDF Library for Delphi 在 Huffman 模式把這個長度拉到 1
Huffman 模式的 refinement 從哪裡讀取點陣圖大小
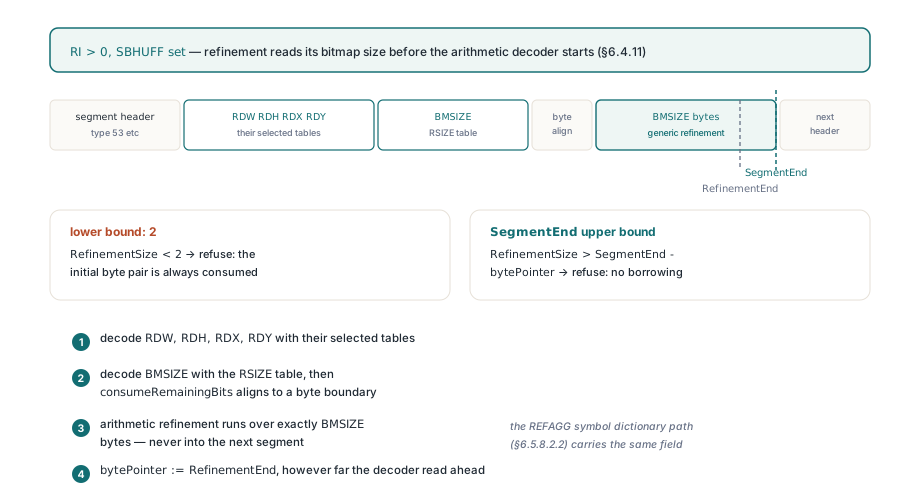
從一個只存在於 Huffman 模式的 BMSIZE 欄位讀,位置在算術 refinement 資料之前。文字區域實例帶 refinement(RI 非零)且設了 SBHUFF 時,T.88 §6.4.11 讓解碼器先用各自的表讀 RDW、RDH、RDX、RDY,再用 RSIZE 表讀 BMSIZE,跳到位元組邊界,然後才對剛好 BMSIZE 個位元組跑通用 refinement 解碼。算術模式的文字區域沒有這個欄位,所以兩種模式共用一條程式路徑的解碼器會跳過它、提早啟動算術解碼器、對著雜訊做 refinement。帶 REFAGG 與單一 refinement 實例的符號字典路徑(§6.5.8.2.2)有同一個欄位
PDF Library for Delphi 對 BMSIZE 兩側都設了邊界。下限 2,是算術解碼器必然消耗的起始位元組對;上限是目前區段的剩餘量——刻意不是整條串流的剩餘量:一個只有借下一段位元組才裝得下的 BMSIZE 是畸形的,用串流長度檢查反而會讓算術解碼器讀進下一個標頭。超出範圍的大小以 invalid refinement bitmap size 失敗。之後,不管算術解碼器往前讀了多少,Huffman 讀取器精確地從欄位之後 BMSIZE 位元組處恢復
宣告的區段長度就是邊界
每個區段標頭都聲明後面跟著多少資料位元組,解碼器在兩個方向上都把區段按這個數字約束:讀過頭是錯誤,提早收工是正常,下一個標頭永遠從檔案說它開始的地方讀。小規則跟著而來:T.88 §7.2.7 的未知資料長度直接拒收,不做終結符掃描;被指區段的編號必須比當前區段小且必須已存在;END_OF_PAGE 與 END_OF_FILE 必須宣告零位元組資料;Profiles 區段(type 52)必須剛好是 4 加 4 乘識別碼數,之後被跳過但保留,讓後續區段仍能指到它,而未知的 profile 識別碼不中斷解碼
提早收工的經典案例是 MMR。MMR 解碼器產出最後一列的最後一個像素就完工了,那可能發生在 T.88 §6.2.5.7 放在資料結尾的 EOFB 終結符之前。假設它此刻已坐在下一個標頭上的讀取器,會把剩下的 EOFB 位元組當區段編號解析、再過幾個位元組才失敗,離真正的成因很遠。直接跳到宣告的結尾就繞開了這個問題。同樣的習慣貫穿 PDF Library for Delphi 解析不可信 PDF 結構的整體做法
從 Delphi 解碼 JBIG2 影像串流
解碼器住在 PDFlibJBIG2 單元裡,叫 TPLJBIG2Decoder。LoadFromByteArray 收 /JBIG2Decode 影像內嵌的 JBIG2 資料,也可選收 /JBIG2Globals 串流的資料——自訂表與共享符號字典通常住在那裡。任何拒收都回傳 False、把原因留在 LastError;每次呼叫開始時清掉上一次的輸出,失敗的解碼不會留下舊像素讓呼叫方誤當結果
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes:影像串流資料,JBIG2Decode 之前的濾器
//   都已移除
// GlobalBytes:/JBIG2Globals 串流資料,或空陣列
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // 格式:'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // 每像素一位元組,0 或 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // JBIG2 裡 1 代表黑
    end;
  finally
    Decoder.Free;
  end;
end;
黑像素計數是您自己的檢查,一個便宜、適合拿去跟第二套渲染器對照的指紋。區段層級的失敗自帶前綴:區段編號、型別與位元組偏移,所以 oversubscribed Huffman prefix codes 前面的 (type 53) 會直接指著一個 Tables 區段。兩條錯誤通道要分開:TPLJBIG2Decoder.LastError 是這顆解碼器的診斷文字,TPDFlib.LastErrorCode 是程式庫層 API 的數字代碼。頁面選擇跟著串流走:解碼器回傳它遇到的第一個 page-information 區段的點陣圖,不去查頁面關聯 0——PDF 內嵌的 JBIG2 只有一頁,編碼器也慣常把它編成 1
拿這些檔案比較渲染器需要一點謙卑:對自訂表加 Huffman refinement 的檔案,各家的 JBIG2 解碼器並不總是意見一致。兩套解碼器吵起來什麼也定不下;定得下來的是格式欄位——選擇器選了哪些表、BMSIZE 宣告了多少、每個區段在哪裡結束
編碼端見 JBIG2 編碼器後端與連結方式一文。讀取路徑必須吞下別家編碼器吐出的任何東西,它的規則與內建 TIFF 解碼器的 BigTIFF 與磚狀版面檢查同源:指名拒收、絕不跨宣告邊界借位元組、中間算術保持寬位。一個掃描 PDF 資料夾若一直絆倒其他工具組,先確認影像是不是自訂表的 Huffman 編碼 JBIG2,再拿它們去試 PDF Library for Delphi 產品頁上描述的原生 Delphi 與 C++Builder 讀取路徑