把客戶留言正確跳脫,讓 <b>urgent</b> 以 <b>urgent</b> 的身分進入 HTML 模板,交給一個把標記解析兩次的渲染器,PDF 裡的 urgent 就可能以粗體登場。跳脫本身沒有錯;是渲染器每一趟各解碼一次。任何「解析、把結果寫回 HTML、再解析一次」的 HTML 轉 PDF 路徑,都必須在整趟旅程裡對實體恰好解碼一次
放到客服系統的場景,這個故事再普通不過:工單匯出成 PDF,客戶留言放在 <p> 裡,而有人往留言框裡打了角括號。不認得的標籤名直接從頁面上消失;跳脫過的錨點變成一份您的員工天然信任的文件裡、可以點的連結註釋。檔案合法、到處都開得了——它只是說出了跟資料不一樣的話
跳脫過的文字在哪裡變回標記
跳脫過的文字變成標記,發生在兩段式渲染器把已解碼文字寫回 HTML、卻不再跳脫的那一刻。第一次解析解出的東西,於是成為第二次解析眼裡的活語法
PDF Library for Delphi(PDFlibPas)的 DrawHTMLText 與 DrawHTMLTextBox 跑兩段,有充分的理由。第一次解析把輸入拆成標籤與詞;渲染器接著解決樣式表層疊——<style> 區塊裡的規則對到每個標籤、與行內 style 屬性合併——然後把整個元素清單寫回成一條每個標籤都帶著最終樣式的正規化 HTML 字串。排版段解析的正是這條字串。PDFlibPas HTML 渲染裡的 flexbox、CSS grid 與腳註排版所描述的選擇器匹配、flexbox、grid 與其餘 CSS 支援,全都依賴這個中間步驟
危險藏在詞怎麼被寫回去。標籤可以按原始形式寫回,詞卻是以解碼後文字持有的——行斷行器量的就是它。把來自 <unsafe> 的詞原樣接到正規化字串後面,第二次解析看到的就是一個 <unsafe> 元素。解碼一次的設計還得堵住三個較小的漏:
- 解碼集裡沒有
&的話,R&D會按字面印出,而且完全沒有辦法把<這個拼寫當文字放上頁面 - 解析結束後繪圖段若再替換一次
,實體的原始拼寫會在最後一刻消失 - 上游的 HTML 生產者——Markdown 轉換器或資料集匯出器——若只跳脫角括號,程式碼範例或儲存格值裡的實體拼寫會被解碼成標記
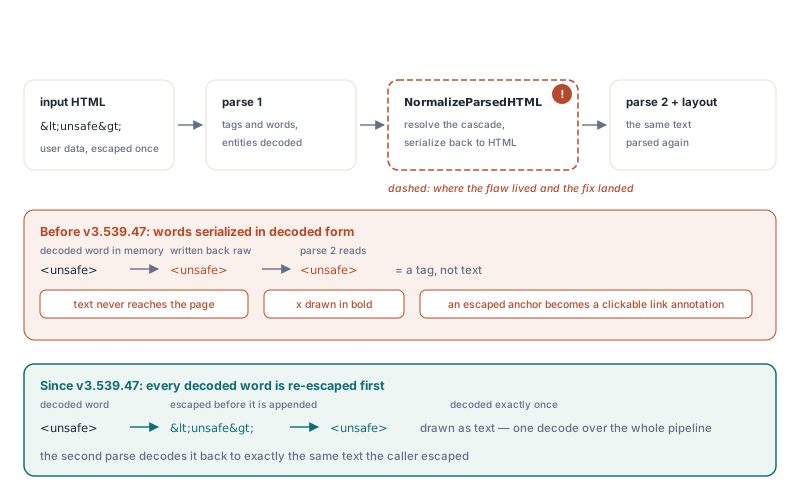
下表列出幾種輸入抵達頁面時的結果,把天真的兩段式渲染器與 PDFlibPas 管線並排比較
| 抵達渲染器的輸入 | 天真的兩段式渲染器 | PDFlibPas |
|---|---|---|
<unsafe> | 被當標籤解析,文字上不了頁面 | <unsafe> 以文字繪出 |
<b>x</b> | x 以粗體繪出 | <b>x</b> 以文字繪出 |
R&D | R&D 按字面印出 | R&D |
&lt; | &lt; 按字面印出 | < |
含 的 Markdown code span | 一個不換行空格 | 以文字繪出 |
資料集儲存格值 < | < | < |
PDF Library for Delphi 怎麼讓每個實體恰好解碼一次?
PDF Library for Delphi 讓每個實體恰好解碼一次,靠的是三條規則同時成立:解析器最後解碼 &、繪圖段什麼都不解碼、每個把解碼後文字寫回 HTML 的地方都先跳脫。三條少任何一條,上表就有一列翻到天真欄
先看什麼會被解碼。文字內容裡,解析器認得 <、>、& 與 ;A 這類數字參照與 " 這類具名實體保持字面文字。這份短清單決定了您該怎麼跳脫自己的輸入——下文還會回到這一點
解碼器內部的順序,就算在同一趟裡也要緊。先解碼 &,輸入 &lt; 變成 <,緊接著的下一次替換把它變成 <——沒有第二次解析的雙重解碼。所以 8 位元詞路徑先替換 <、>、 ,最後才替換 &,它產出的 ampersand 不會再被看第二眼。UTF-16 詞路徑用另一條路到同一個終點——一次兩位元組一步的由左至右掃描,就地改寫每個匹配、然後越過它
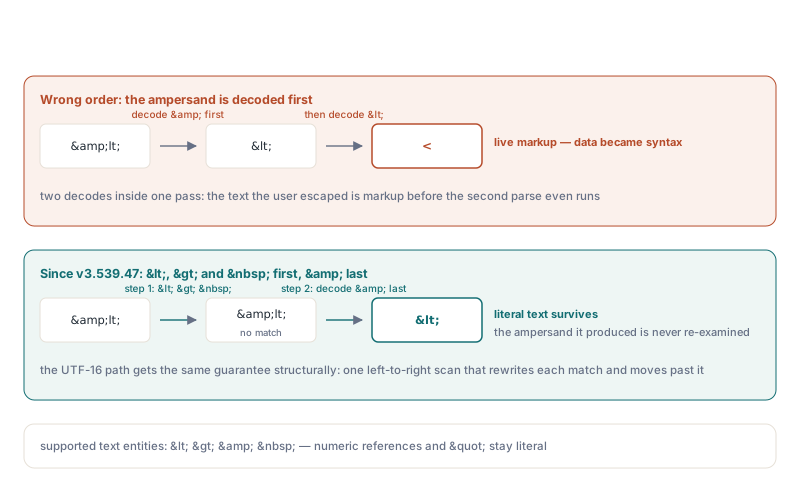
繪圖段不做任何遲到的 替換。抵達斷行器的詞就是最終文字,解碼只住在解析器裡、別無他處
分量最重的是邊界規則。渲染器寫出正規化 HTML 時,把每個解碼詞裡的 &、<、> 跳脫之後才接上去,第二次解析又把它們解回同樣的字元。兩趟合計的淨效果:恰好一次解碼。DrawHTMLTextBox 回傳的接續字串守同一條規則:裝不下的詞先跳脫才進 remainder,remainder 的其餘部分從已跳脫的正規化 HTML 複製。盒子裝下所有內容時回傳空字串
UTF-16BE 的跳脫為什麼不能用位元組層級的替換?
UTF-16BE 的跳脫不能用位元組層級替換,因為一個 ampersand 的兩個位元組可能橫跨兩個毫不相干的字元。唯一安全的工作單位是完整的 16 位元 code unit
渲染器把 Unicode 詞按大端序 UTF-16 裝進位元組字串、高位元組在前,所以 ampersand 是 00 26。拿 U+0100(帶長音符的拉丁大寫 A,位元組 01 00)後面跟 U+2603(雪人,位元組 26 03):緩衝區讀作 01 00 26 03,第二、三位元組拼出 00 26。按位元組搜尋 #0'&' 會找到一個沒有任何字元真正擁有的 ampersand,把 & 接進兩個 code point 的中間,後面每個字元跟著位移一位元組
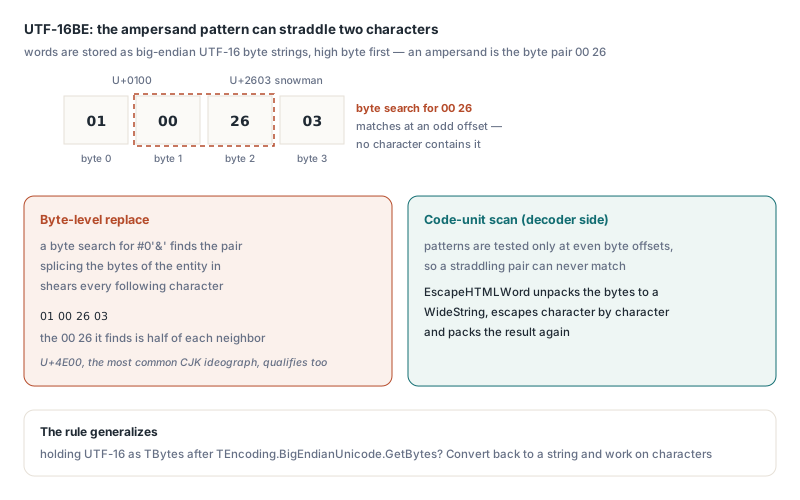
這不是什麼偏僻角落。低位元組為零的任何字元都能供應前半——而 CJK 漢字裡最常見的字之一 U+4E00 正是這種字。角括號同理:只要這類字後面跟著 CJK Extension A 裡 U+3C00 到 U+3EFF 之間的字,00 3C 與 00 3E 就會出現。所以 PDFlibPas 跳脫 Unicode 詞的方式,是把它們解包成 WideString、逐字元跳脫、再打包回去。解碼器基於同樣的理由安全:它只在偶數偏移上測試模式
您自己的程式碼也撞得上同一堵牆。UTF-16 文字一旦住進 TBytes——例如 TEncoding.BigEndianUnicode.GetBytes 之後——對它做位元組模式搜尋就是等著正確字元對上門的 bug。轉回字串、按字元工作
Markdown 程式碼與資料集儲存格:ampersand 最先跳脫
PDFlibPas 裡兩個 HTML 生產者——Markdown 轉換器與資料集匯出器——都在角括號之前先跳脫 ampersand,渲染器裡那一次解碼才能逐位元組還原原始文字
在 MarkdownToHTML 裡,行內 code span 與圍欄或縮排程式碼區塊把 & 映射成 &、< 映射成 <、> 映射成 >;空格變成 、tab 變成四個,縮排因此原樣保留。普通散文只跳脫角括號:散文裡手打的原始 HTML 注入不了標籤,而刻意寫下 & 的作者仍得到一個 ampersand——正如 Markdown 作者的期望。DrawMarkdownText 與 DrawMarkdownTextBox 跑同一套轉換,程式碼區塊照著打的樣子原樣登場:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// 檢視 HTML:code 內,'&' 變成 '&'、'<' 變成 '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // 左上原點,Y 向下增長
Lib.SetMeasurementUnits(0); // 點(points)
// 頁面照著打的樣子顯示程式碼,實體拼寫原樣保留
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;誘人的捷徑住在資料集匯出器裡。若渲染器不解碼 &,跳脫 ampersand 會讓每個含 & 的儲存格印出 &,所以只跳脫角括號看似更友善。第一個值裡恰好含有 < 的儲存格就讓它破功——那個值以 < 的身分登上頁面。正因為渲染器確實解碼 &,PDFlibExportDataSet 背後的匯出器先跳脫 &,R&D < & 這種值一字不差落進 PDF。該匯出器的其餘部分見 在 Delphi 裡把 TDataSet 匯出成 PDF 報表一文
為什麼是「最先」,而不是鏈上隨便哪個位置?先跳脫 < 得到 <;第二步跳脫 &,它變成 &lt;——正確的單次解碼會把它顯示成 < 而不是 <。順序替換鏈只有在跳脫字元本身在任何引入它的步驟之前被處理時才成立
面對 DrawHTMLTextBox,不可信文字該怎麼跳脫?
給 PDFlibPas 跳脫不可信文字內容的方法:替換 &、再 <、再 >,各恰好一次,並且把不可信資料徹底擋在屬性值之外。下面的輔助函式由您自己加上,是純 RTL 程式碼:
uses
System.SysUtils, PDFlibrary;
// 您自己的輔助函式(不是程式庫的一部分):為 PDFlibPas 的 HTML 文字內容
// 跳脫不可信文字。'&' 必須最先替換,
// 否則剛產生的 '<' 裡的
// ampersand 會被再跳脫一次
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;把留言 Try <a href="https://example.com">this</a> & <b> 餵進去,頁面把那些字元一一原樣顯示。在解碼兩次的渲染器下,同一份跳脫輸入會變成活的連結註釋——這就是從外觀瑕疵跨到安全問題的那一步:一則工單留言,不該有能力在送往自家員工的 PDF 裡種下一個可點擊的 URL
注意輔助函式不碰什麼。通用跳脫器還會把 " 變成 "、' 變成 '——對瀏覽器正確、在這裡錯誤:PDFlibPas 的文字解碼只認得前面列的四個實體,這兩個會按字面印成 " 與 '。別拿瀏覽器跳脫器來做這件事。引號在文字內容無害;它們只在屬性值裡要緊,而渲染器根本不解碼屬性裡的實體。對屬性,我們寧可要一條規則而不是更聰明的跳脫器——那裡反正沒有任何跳脫方案被檢查:讓使用者值遠離 href、src 與 style。連結目標真的必須來自使用者輸入時,自己對 scheme 與字元的允許清單做驗證,含引號或角括號的一律拒收
單次解碼直接導出兩個習慣:
- 永遠跳脫
&。跳過它,含<的使用者文字會以<登場——無害,但不是使用者打的字 - 只在一個地方跳脫。經過兩道跳脫器的文字,會把
<渲染成肉眼可見的拼寫<;請找到資料進入 HTML 字串的那唯一一個位置、在那裡跳脫
用 LeftOverText 分頁而不弄壞跳脫
DrawHTMLTextBox 回傳裝不下的 HTML——一般叫 LeftOverText——這份 remainder 帶著字面實體拼寫與已跳脫的角括號進入下一個盒子時原樣保留。請照收到時的原樣傳回去
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // 按 A4 頁面以 points 計的尺寸
  BoxHeight = 740;
  MaxPages = 500;    // 您自己的安全上限

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // remainder 已是跳脫過的 HTML:絕不再跳脫、也不反解
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
把 remainder 當不透明資料。它是每個標籤都已帶上解析後樣式的正規化 HTML;拿自己的跳脫器再跑一遍,每個 < 會變成 &lt;,而對它反解則把活標籤交給下一個盒子。把新的使用者文字接進去,同樣兩種死法各一次。頁數上限只花一次比較:若某個元素永遠塞不進盒子,沒有上限的迴圈沒有天然出口
Markdown 有自己的接續方式。DrawMarkdownTextBox 回傳的 remainder 以一條標記註解開頭,告訴 Markdown 入口在下一次呼叫時跳過轉換。把它交回 DrawMarkdownTextBox 或 DrawMarkdownText——就像把 LeftOverText 交回 DrawHTMLTextBox 一樣。Markdown 的 remainder 歸 Markdown 入口管;只有 DrawHTMLTextBox 的 remainder 才走 HTML 呼叫
這一切背後的形狀——解析、寫回同一種語法、再解析——同樣出現在模板引擎、HTML sanitizer 與 Markdown 轉 HTML 轉 PDF 的鏈條裡,而且失敗有兩個方向。重新編碼太少,資料變語法;編碼太多、或解碼器跑兩次,實體拼寫被亮給讀者看、或被吃掉。只補一個方向往往弄壞另一個,這正是 PDFlibPas 渲染器把 & 解碼、最後解碼它、不做遲到解碼、每個邊界重新跳脫當成一個整體包裹的原因。匯出方向守同一條規則:從 Delphi 做 PDF 轉 Markdown 與 DOCX 的語意匯出裡,每個字面字元對目標語法恰好跳脫一次
HTML 與 Markdown 繪製、資料集報表匯出器與其餘版面引擎,以原生 Pascal 原始碼隨 PDF Library for Delphi 提供,Delphi 與 Free Pascal 都能用。版本、平台涵蓋與試用下載見 PDF Library for Delphi 產品頁