決勝的是半個點。正文 10 pt 的報告裡,以 11 pt 粗體排的章節標題轉成 Markdown 是普通段落;封面上一張 12 pt、常規字重的說明文字,回來卻是 ### Quarterly figures。看起來像弄反了,直到你想起 PDF 頁面實際存的是什麼:座標上的字形、字型名稱與大小。頁面上沒有任何東西寫著「標題」。轉換器輸出的每一個標題,都是從這三個事實推出的猜測,而猜測有門檻
為什麼 PDF 頁面沒有段落可匯出
PDF 頁面裡是顯示文字的運算子,不是段落。每個運算子把一串字形放在一個位置,順序按產生應用程式當時輸出的樣子,ISO 32000-1 沒有要求產生端聲明兩串字形屬於同一句話,更別說同一個清單項或表格儲存格。這個格式精確描述一頁印刷品,而它做到這一點的方式,是把產生這一頁的結構丟掉
所以每個轉換器都在重建產生器丟掉的東西。行來自共用的基線與垂直間距;段落分隔來自間距與縮排的變化;清單是一串以項目符號或數字模式開頭的區塊;表格是邊緣跨列跨欄對齊的文字區塊網格。在遵循一般排版習慣的文件上,這套推導工作得很好;在為視覺效果排版的小冊子上,它幾乎沒有東西可抓
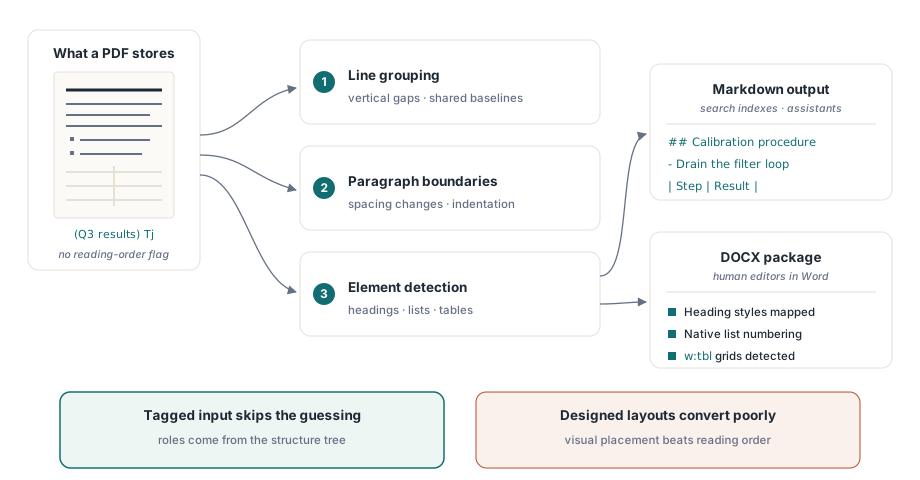
加標籤的 PDF 是大例外。文件帶結構樹時,段落、標題、清單與表格角色由產生端記錄,而不是事後猜測,這也是為什麼加標籤 PDF 的無障礙結構一文描述的工作,同樣在轉換品質上回收。如果你掌控產生端,為輸出加標籤是替日後的轉換者能做的最便宜的一件事
標題層級從哪裡來
PDF Library for Delphi 以兩種方式決定標題層級,取決於輸入。在加標籤的頁面上,結構角色為 H1 到 H6 的區塊保留該層級,H 或 Title 成為層級 1。在未加標籤的頁面上,匯出回退到相對於頁面正文大小的字型大小,而且只考慮 200 字元以內的單行段落
大小規則需要一個比值與一個絕對差距,都以佔優勢的正文大小為基準:
| Markdown 輸出 | 該行最大的文字 | 以 10 pt 正文為基準 |
|---|---|---|
# | 至少 1.6 倍正文大小,且至少大 4 pt | 16 pt 以上 |
## | 至少 1.35 倍,且至少大 2.5 pt | 13.5 pt 以上 |
### | 至少 1.15 倍,且至少大 1.25 pt | 11.5 pt 以上 |
這解釋了開頭的例子。正文 10 pt 之上的 11 pt 粗體標題,以半個點之差錯過第三級,而字重在層級判定裡不起任何作用。12 pt 的封面說明文字過了門檻。絕對差距是為小正文存在的:在 6 pt 腳註大小的文字上,光靠比值會把 7 pt 的行提拔成標題,額外 1.25 pt 的要求擋住這件事
我們認為這是正確的取捨。粗體在正文裡太常見了(引導語、術語定義、摘要列裡的合計),單憑它做標題訊號不可靠,把每一行粗體都提拔的轉換器,會產出帶著幾十個虛假章節的 Markdown。漏掉幾個只有粗體的標題,代價更小。如果你的文件靠正文大小的粗體標題,可靠的修法在上游:給它們加標籤,或把標題大小加大一個半點
輸出裡的粗體與斜體讀自字型名稱。字型名稱含 Bold、Black 或 Demi 的文字串變成 **bold**;Italic 或 Oblique 變成 *italic*。以 F3 這類不透明名稱子集化的產生端,或以描邊常規字形偽造粗體的產生端,沒給匯出任何可讀的東西,這些文字原樣抵達、無樣式
給檢索管線的 Markdown 匯出
目的地是文字管線時——文件網站、搜尋索引、給助理用的分塊語料——該走的是 Markdown 路線。ExportPageMarkdown 以 WideString 回傳一頁,ExportDocumentMarkdown 回傳一個頁碼範圍,SaveMarkdownToFile 與 SaveMarkdownToStream 把同樣的文字以不帶 BOM 的 UTF-8 寫出。省掉 BOM 是刻意的:不少靜態網站產生器與 diff 工具把它當成內容
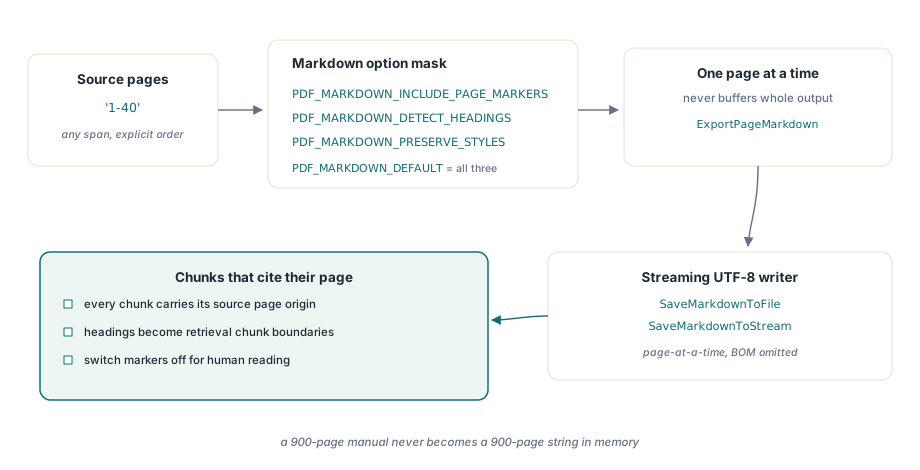
選項是位元遮罩:PDF_MARKDOWN_INCLUDE_PAGE_MARKERS(1)、PDF_MARKDOWN_DETECT_HEADINGS(2)與 PDF_MARKDOWN_PRESERVE_STYLES(4),PDF_MARKDOWN_DEFAULT 是三者的組合。另一個文件層級的設定控制分析本身:SetStructuredTextOptions 接受 PDF_STRUCTURED_* 旗標,預設偵測欄位、偵測頁首頁尾,並接合跨頁延續的表格
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // 頁首頁尾的偵測預設開啟;
    // 再加 EXCLUDE_FURNITURE 會把它們從輸出中剔除
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // 頁面標記與標題,但不要 ** 與 * 強調
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // 每頁一筆條目的 JSON:readingSource 是 tagged、mixed、
    // geometric 或 geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
對檢索語料,我們捨棄 PDF_MARKDOWN_PRESERVE_STYLES。強調逐文字串套用,一段跨多個文字串的粗體片語會變成 **Net** **revenue**,螢幕上讀起來沒問題,卻給每個 embedding 加了雜訊。頁面標記恰恰相反:留著。每個標記是一個 HTML 註解,<!-- page: 12 -->,Markdown 渲染時不可見,切塊時又好解析,取回的段落因此能引用它來自的頁碼。表格從上一頁延續時,新頁的標記會省略,pipe 表格保持完整
有兩個行為會讓逐頁迴圈匯出的人吃驚。第一,頁首頁尾靠重複識別:頁面頂部或底部 12% 內的段落,當同一匯出裡另一頁的同一條帶上出現相符文字時算作設備元素,數位經正規化,所以 "Page 3 of 40" 與 "Page 4 of 40" 相符。單頁呼叫沒有其他頁可比,未加標籤的頁首就留在文字裡。第二,Markdown 裡的影像以 data: URI 內嵌,檔案因此自給自足,也意味著一頁大照片能給檔案添上幾百 KB 的 base64。你的切塊器有大小限制的話,切分前先剝掉以 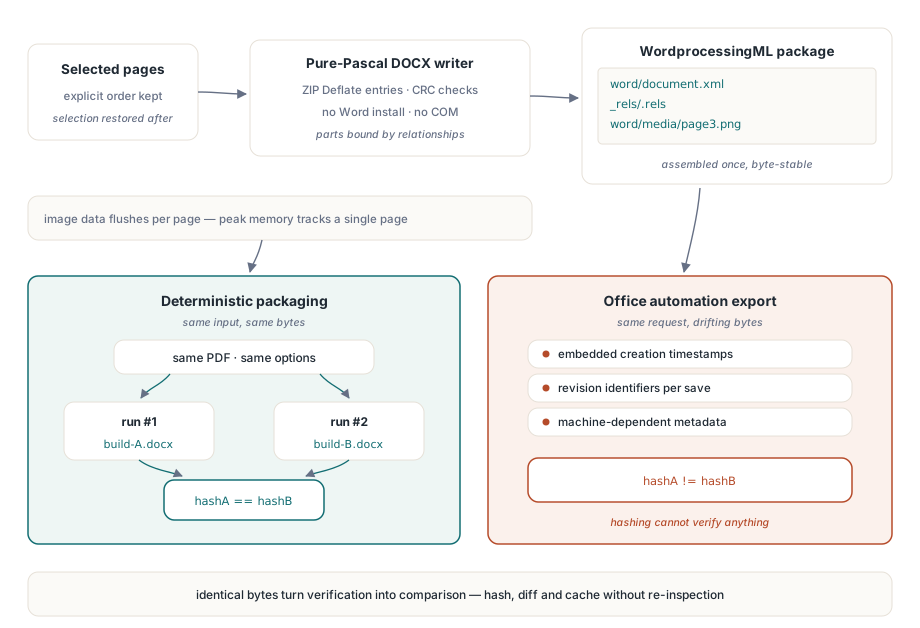
撐起這一點的是兩個決定。每個 ZIP 條目帶同一個固定的 DOS 日期——1980 年 1 月 1 日——而不是執行當下的時間;核心屬性部件不帶建立或修改日期。每個條目只有當 raw Deflate 確實更小時才壓縮,所以本已壓縮的 PNG 媒體原樣儲存。第一點可以用 unzip -v handbook.docx 驗證:每一列顯示的日期都相同
Office 自動化給不了你這些。經 Word 存檔會把當前時間蓋進套件 metadata 與 ZIP 表頭,同一份文件轉兩次,差異足以擊潰雜湊。可重現建置的決定性 PDF ID背後是同一套推理:輸出一旦可重現,驗證就變成一次比對
哪些輸入轉得好,哪些永遠轉不好
轉換品質隨輸入的變化大過隨轉換器的變化,值得事先告訴你的使用者。加標籤的 PDF 與乾淨產生的商業文件(發票、報告、合約)轉得好:標題落成標題、表格存活、清單在 Word 裡重新編號。欄位幾何規律的雙欄學術排版,會以正確閱讀順序通過,診斷會為那些頁面回報 geometric-columns。跨頁斷開的表格靠推導重新接合,記得抽查。為效果而排、不按閱讀順序的重設計行銷素材,給任何轉換器留下的可恢復線索都很少;預期要手工修整結果
掃描文件是另一回事。整頁一張大圖的頁面不含文字物件,沒有文字層就無東西可匯出,跑 OCR 是兩種格式的前置條件。大量批次之前,先抽十幾份代表性檔案,列舉它們的頁面裝了什麼,如文字搜尋與頁面元素列舉一文所述;一頁只有影像沒有文字串的頁面,看一眼比讀轉換結果說得更多
按下一步是什麼來選格式。Markdown 適合機器與管線:標題成為切塊邊界、表格以 pipe 表格保持可讀、頁面標記給每個區塊引用來源。DOCX 適合需要改動文件的人,因為他們要拿回的是 Word 裡可編輯的檔案,帶真正的清單與真正的表格,光有文字給不了這些
PDF Library for Delphi 提供 Delphi、C++Builder 與 Lazarus 版本,另有把同樣的 Markdown 與 DOCX 匯出呼叫暴露給 C#、C++ 與指令碼宿主的 DLL 與 ActiveX 版本。每個選項旗標的參考文件與試用下載都在PDF Library for Delphi 產品頁