倉儲標籤把收貨人 Müller GmbH, Köln 以 UTF-8 存進 Data Matrix 符號,現場每一支手持掃描器讀回來卻都是 Müller GmbH, Köln。把 PDFlibPas 的 BarcodePayloadEncoding 屬性設為 bpeUTF8WithECI,就會在資料前面放上一個 ECI 000026 標記,告訴 Data Matrix 與 PDF417 讀碼器:這些位元組要按 UTF-8 解碼
UTF-8 資料為什麼會被解碼成 Müller?
符號本身不帶任何字元集宣告,讀碼器只好退回該條碼體系的預設單位元組字元集——Data Matrix 是 ISO-8859-1。UTF-8 的 ü 是 C3 BC 兩個位元組,按 ISO-8859-1 對照就成 à 和 ¼;ö 同理變 ö。位元組本身完好無缺。Extended Channel Interpretation 就是條碼世界的字元集宣告:AIM 的 ECI 登記表給每個字元集編了號,000026 對應 UTF-8,開頭帶 ECI 指示碼的符號會告訴合規的讀碼器,之後的內容一律按該字元集解碼。對符號本身而言,指示碼就是普通資料——在本文討論的兩種條碼體系裡都佔兩個字碼,計入容量,並與其後的資料一起受到2D 條碼 Reed-Solomon 錯誤修正的保護
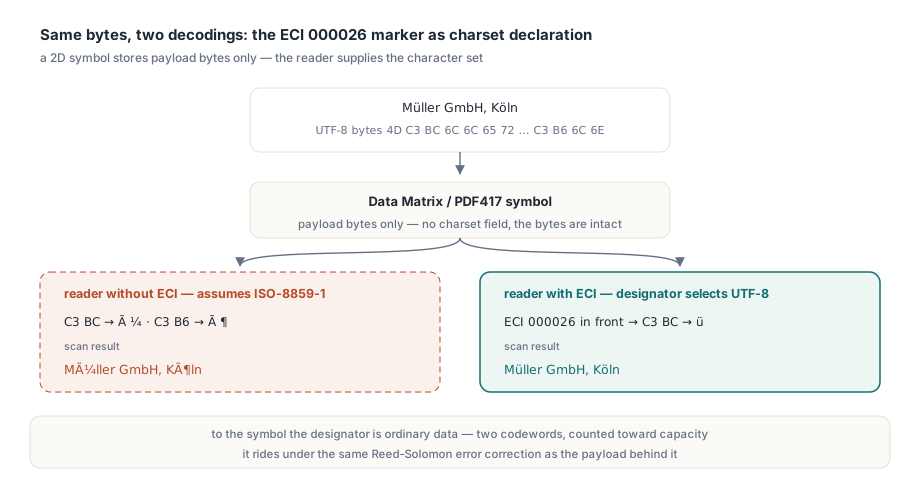
ECI 字碼在 Data Matrix 與 PDF417 中的位置
每種條碼體系都為這個標記保留了固定槽位,放錯地方,符號要嘛解不出來,要嘛解出來開頭是一串亂碼:
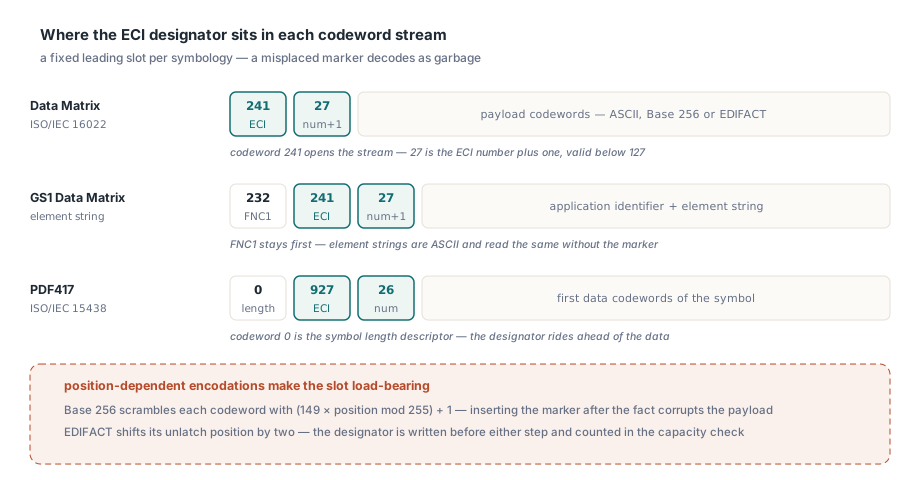
- Data Matrix(ISO/IEC 16022):先放字碼 241,接著以 127 以下數值所用的單字碼形式寫出 ECI 編號加一,UTF-8 即 27。它開啟整個資料流
- GS1 Data Matrix:FNC1(字碼 232)必須守住第一位,因此若您要求加標記,PDFlibPas 會緊隨其後放置;不過 GS1 元素字串取自 ASCII 的子集,不加標記讀起來結果相同
- PDF417(ISO/IEC 15438):字碼 0 是符號長度描述碼,標記緊隨其後,以字碼 927 和 26 出現,位於第一個資料字碼之前
Base 256 是最麻煩的情況。這種編碼是 Data Matrix 用來裝任意位元組的緊湊模式,會用一個由字碼在符號中絕對位置推導的偽隨機值攪亂每個字碼,也就是 (149 × position mod 255) + 1。若攪亂之後才把標記插到最前面,後面每個位元組攪亂時所用的位置都比讀碼器實際看到的位置早兩格,整份資料還原出來全是錯值。EDIFACT 編碼對同一依賴有個較輕的版本——標記插到前面之後,解除 latch 的位置會位移兩格。PDFlibPas 在這兩個步驟執行之前就把標記寫進字碼流,而挑選符號尺寸的容量檢查也已把它算進去。兩種條碼體系通用的標籤程式碼如下:
uses
  SysUtils, PDFlibrary;

procedure PrintConsigneeLabel(const FileName: string);
var
  Pdf: TPDFlib;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.NewDocument;                                // 建立並選取第 1 頁
    Pdf.SetPageSize('A4');
    Pdf.SetMeasurementUnits(1);                     // 公釐
    Pdf.SetOrigin(1);                               // Top 自上緣起算

    Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;   // UTF-8 位元組 + ECI 000026
    if Pdf.DrawDataMatrixSymbol(20, 20, 0.5, 'Müller GmbH, Köln',
      1,      // Encoding:1 = ASCII 編碼
      0,      // SymbolSize:0 = 表中第一個放得下的尺寸
      100) <> 1 then                                // 正常方向,預設 1 模組留白區
      raise Exception.CreateFmt('Data Matrix failed (%d)', [Pdf.LastErrorCode]);

    if Pdf.DrawPDF417SymbolEx(20, 50, 'Zustellung: Müller GmbH, Köln',
      0, 0, 0,  // 方向、欄數、列數:自動
      -1,       // 錯誤等級自動
      0.3, 3.0) <> 1 then
      raise Exception.Create('PDF417 failed');

    // 支援 ECI 的掃描器應對兩個符號都回傳德文原文
    Pdf.BarcodePayloadEncoding := bpeSystemANSI;    // 回到預設值
    Pdf.SaveToFile(FileName);
  finally
    Pdf.Free;
  end;
end;
NewDocument 已經建立並選取了第 1 頁,所以不用呼叫 NewPage,符號就直接落在第一頁上。SetOrigin(1) 把原點移到左上角,Top 從此代表符號上緣到頁面上緣的距離。在預設的左下角原點下,Top 設 10 mm 表示該上緣位於紙張底部以上 10 mm 處,11 mm 的符號就會懸出紙外。DrawDataMatrixSymbol 成功時回傳 1;遇到編不動的資料——把標記算進去後超出最大符號容量的資料,或是您指定的固定尺寸——則回傳 0、把 LastErrorCode 設為 302,而且什麼都不畫,所以範例把一切非 1 的回傳值都當錯誤處理
每張標籤都該帶 ECI 標記嗎?
不用,預設值也反映了這一點。BarcodePayloadEncoding 有三個值可選,各自適合不同的讀碼器族群:
bpeSystemANSI(預設)把文字經系統 ANSI 字碼頁轉換,不寫任何標記,用PDFlibPas QR、PDF417 與 Data Matrix 函式做出的標籤版面預期的就是這種結果bpeUTF8寫出 UTF-8 位元組但不加標記,適合封閉系統——讀條碼的是您自己的軟體,而且本來就假設 UTF-8bpeUTF8WithECI寫出 UTF-8 位元組,並以 ECI 000026 標明
全面加標記的代價是讀碼器支援度。ECI 處理在許多掃描器上只是個設定選項,隨設定不同,設備可能拒收符號,或把指示碼當成文字原樣交給主機:AIM 慣例是反斜線加六位數字,應用程式收到的就變成 \000026Müller GmbH, Köln。請按符號逐一開啟標記——只用於含非 ASCII 文字的資料——並配合掃描器設定檔的調整一起推出。若每個名字都放得進讀碼器假設的字碼頁,單位元組資料仍是合理的選擇:ü 在 Windows-1252 和 ISO-8859-1 裡都是位元組 FC,西歐 Windows 系統上以 bpeSystemANSI 寫出的德文地址,在從沒聽過 ECI 的 Data Matrix 讀碼器上照樣解碼正確。日文文字就沒有這種退路
符號尺寸:自動選擇、固定模板與矩形
標記的兩個字碼很少單獨起作用。ASCII 編碼下,bpeSystemANSI 的收貨人行列把 ü 和 ö 存成 127 以上的單位元組,各花兩個字碼,整行共 19 個字碼,放得進有 22 個資料字碼的 20×20 符號。改用 UTF-8 後,這兩個字母變成四個高位元組,整行要 23 個;加上標記是 25 個,就需要 22×22——這一步純粹是 UTF-8 位元組造成的,因為 23 已經爆掉 20×20。把 SymbolSize 釘死在 9(20×20)的模板,編碼一換就會從 DrawDataMatrixSymbol 拿到 0 和錯誤 302,條碼槽位上什麼都沒畫
自動選尺寸還可能改變形狀。SymbolSize 設 0 時,PDFlibPas 依序走過 ISO/IEC 16022 的尺寸清單,取第一個資料容量裝得下該字碼流的尺寸。六種矩形尺寸就排在這份清單的各個正方形之間。原本塞滿 26×26 符號的資料(44 個資料字碼)加上標記需要 46 個,清單中下一個裝得下 46 的是擁有 49 個的 16×48,排在擁有 62 個的 32×32 之前。以每模組 0.5 mm 計,13 mm 的正方形就變成 8 × 24 mm 的長條。裝滿的 22×22 也一樣:30 個字碼加兩個落進 16×36。小的資料仍是正方形——原本塞滿 10×10 的三個字碼變五個,放得進 12×12,而 12×12 在清單裡排在 8×18 之前。若標籤版面保留的是正方形槽位,就把 SymbolSize 釘在您承受得起的正方形上(32×32 是 16),名字太長時讓錯誤 302 來告訴您;能接受兩種形狀的版面才適合交給自動選尺寸
PDF417 的成長規則不同。ErrorLevel 設 -1 時,編碼器按 ISO/IEC 15438 的建議最低等級規劃錯誤修正,這些門檻在字碼數達 41、161、321 時升級(含長度描述碼)。39 個字碼的流加上標記變 41 個,最低等級從 2 升到 3,規劃的錯誤修正區塊也從 8 個字碼長到 16 個——多出整整十個字碼。欄數與列數設為自動時,編碼器就按這個更大的總數排出矩形,所以剛好卡在門檻下方的資料,多出的面積會遠超兩個標記字碼給人的印象
哪種編碼能讓 UTF-8 的 Data Matrix 保持最小?
直接比較兩種成本。ASCII 編碼把一對數字裝進一個字碼,普通 ASCII 一字元一字碼,但 127 以上的每個位元組都要花兩個:一個 Upper Shift(235)加位元組減 127。Base 256 則一次性支付 latch 和長度欄位——249 位元組以內一個長度字碼,超過則兩個——之後每位元組一個字碼,沒有數字打包。不含連續數字的文字,只要資料裡出現三個高位元組,Base 256 就勝出。Müller 那行早已如此:21 個字碼對 23 個。長串數字則把天平推回 ASCII,因為每對數字在那邊能省一個字碼。下面的輔助函式把兩種成本都算過,用較便宜的模式繪製;純 ASCII 則完全不加標記,因為它在任何字元集下讀起來都一樣:
// 為 Unicode 文字繪製 Data Matrix,採用較便宜的編碼模式
function DrawUnicodeDataMatrix(Pdf: TPDFlib; Left, Top, ModuleSize: Double;
  const Text: WideString): Integer;
var
  Bytes: UTF8String;
  I, HighBytes, AsciiCost, Base256Cost, Mode: Integer;
  Saved: TPDFlibBarcodePayloadEncoding;
begin
  Bytes := UTF8Encode(Text);
  HighBytes := 0;
  AsciiCost := 0;
  I := 1;
  while I <= Length(Bytes) do
  begin
    if (I < Length(Bytes)) and (Bytes[I] >= '0') and (Bytes[I] <= '9') and
       (Bytes[I + 1] >= '0') and (Bytes[I + 1] <= '9') then
    begin
      Inc(AsciiCost);                    // 數字對:一個字碼
      Inc(I, 2);
      Continue;
    end;
    if Ord(Bytes[I]) > 127 then
    begin
      Inc(HighBytes);
      Inc(AsciiCost, 2);                 // Upper Shift + (位元組 - 127)
    end
    else
      Inc(AsciiCost);
    Inc(I);
  end;
  if Length(Bytes) <= 249 then
    Base256Cost := Length(Bytes) + 2     // latch + 一個長度字碼
  else
    Base256Cost := Length(Bytes) + 3;    // latch + 兩個長度字碼

  Saved := Pdf.BarcodePayloadEncoding;
  try
    if HighBytes = 0 then
    begin
      Pdf.BarcodePayloadEncoding := bpeSystemANSI;  // 純 ASCII:不加標記
      Mode := 1;
    end
    else
    begin
      Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;
      if Base256Cost < AsciiCost then
        Mode := 3                        // Base 256
      else
        Mode := 1;                       // ASCII
    end;
    Result := Pdf.DrawDataMatrixSymbol(Left, Top, ModuleSize, Text, Mode, 0, 100);
  finally
    Pdf.BarcodePayloadEncoding := Saved;
  end;
end;
以 東京都千代田区 為例,UTF-8 形式是 21 個位元組,全部高於 127。加上標記後,Base 256 需要 25 個資料字碼,ASCII 編碼要 44 個,按容量表對應到同一模組尺寸下的 22×22 與 26×26 兩種符號。而那個 26×26 已經是滿的,再多一個字碼就得跳到 16×48。GS1 資料(模式 7)不在輔助函式的處理範圍內,因為其元素字串是 ASCII。QR Code 的資料模式透過 DrawQRCode 的 EncodeOptions 引數指定,至於 PDFlibPas 畫出的 Aztec 符號,只要資料位元組是含至少一個非 ASCII 字元的有效 UTF-8,就會自動帶上 ECI 26 旗標
以 Müller 那行為例,標記只花兩個字碼,從 20×20 跳到 22×22——以 0.5 mm 模組計就是 10 mm 變 11 mm——其實是 UTF-8 位元組造成的。若您的標籤槽位擠得出這一公釐,就在收貨人符號繪製之前,把 PDFlibPas Delphi PDF Library 的 TPDFlib 實例設定 BarcodePayloadEncoding 為 bpeUTF8WithECI,同頁的舊符號則設回 bpeSystemANSI