把產生多項式的常數項放在前面、然後又從最高次項開始做除法的 Reed-Solomon 編碼器,根本不是在做錯誤更正。HotPDF 在四個 2D 條碼編碼器——QR、Data Matrix、PDF417 與 Aztec——裡就帶著這種寫法出貨,每個產出的符號都揹著一個沒有任一台合規掃描器讀得懂的檢查區塊
有趣的地方不是算術失誤本身,而是它的擴散方式。先寫好第一個編碼器,除法迴圈被複製到後面三個,每個新格式都繼承了一個從未對照過任何公開測試向量驗證的缺陷。符號照樣渲染得出來,尋找圖案躺在正確的位置,尺寸也都對。只有那些讓 2D 條碼在污漬下還能活下來的位元組是垃圾
一個顛倒的多項式,複製進四個編碼器
根因藏在綜合除法迴圈裡的儲存順序錯配。四個 HotPDF 編碼器都用係數由低到高的方式建產生多項式,所以 Gen[0] 放的是常數項,Gen[High(Gen)] 放的是首一的最高次項係數。除法迴圈走訪訊息時正向索引 Gen[J],這在算術上等於除以顛倒過的多項式。還有一個後果把前一個藏得更深:因為最高次項係數永遠不會落到位置 I,Work[I] 從來沒有被清掉,除法實際上什麼都沒消掉。迴圈仍然會終止,尾巴仍然填著長度分毫不差的陣列
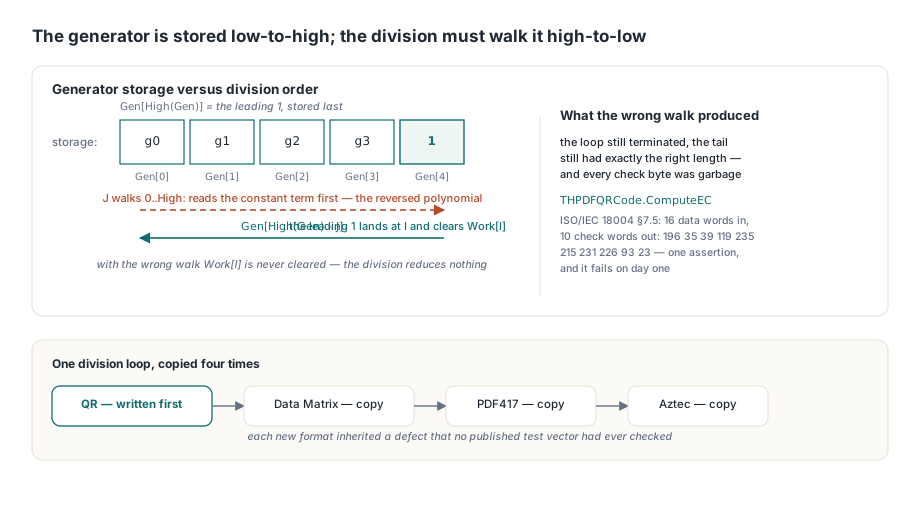
// THPDFQRCode.ComputeEC,位於 HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] 是常數項
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] 是會清掉 Work[I] 的首一係數 1;正向走訪 Gen
  // 等於除以顛倒過的多項式
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
修法只有一個索引表示式 Gen[High(Gen) - J]。改完之後 THPDFQRCode.ComputeEC 就能重現 ISO/IEC 18004 §7.5 的範例:version 1-M 位元組模式的區塊 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 產出十個檢查碼字 196 35 39 119 235 215 231 226 93 23。這只需要一條斷言,而且它第一天就會失敗
為什麼 Aztec 符號連酬載也一起不見?
Aztec 揹的是同一隻 bug 的更重版本,因為 TAztecGF.Encode 是原地除法。這個常式收到的 Words 依序是訊息與清成零的檢查碼字槽位,呼叫端把整個陣列寫進符號。多項式除法在消減的過程中會毀掉被除式,所以一旦迴圈修成真的會消減,訊息碼字沿途就被覆寫了。酬載與模式訊息雙雙壞掉——這正是壞掉版本因為什麼都沒消減而僥倖躲過的失敗
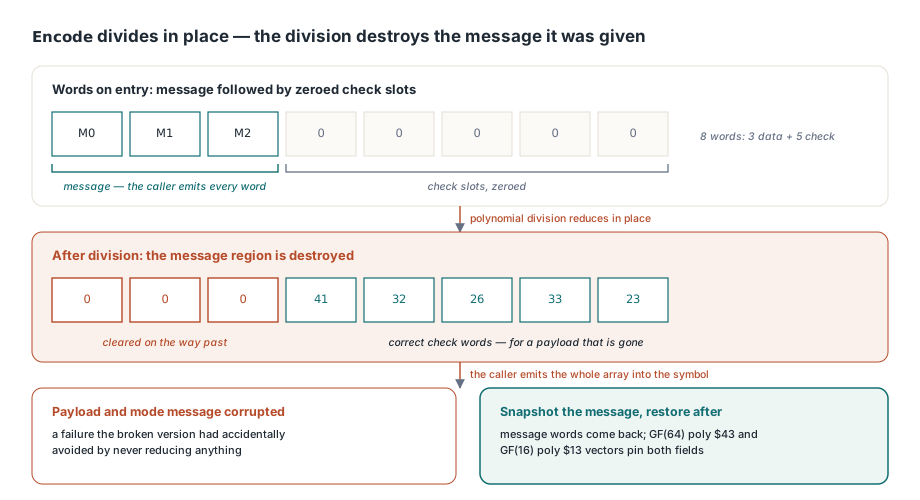
// TAztecGF.Encode,位於 HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// 除法會清掉訊息區段,但呼叫端把整個陣列
// 寫進符號,所以資料碼字必須還原
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec 用到兩個不同的體,回歸測試的 fixture 兩種都會跑到。在 GF(64)(六位元符號的體,由本原多項式 $43 建出)裡,碼字 12 45 3 配五個檢查碼字會產出 41 32 26 33 23,而開頭三個保持原樣。在 GF(16)(模式訊息的體,本原多項式 $13)裡,碼字 5 9 產出 11 15 6 8。兩者都經由 HPDFAztecTestEncode 這個 hook 對照 ISO/IEC 24778
為什麼 Data Matrix 要修兩處而不是一處?
THPDFDataMatrix.ComputeEC 在共通的錯誤之上又疊了一個獨立的錯誤:它用從 α^0 開始的根建產生多項式,而 ISO/IEC 16022 附錄 E 規定根要從 α^1 開始。只修除法索引,標準範例會得到 146 107 90 179 128 這串檢查碼字,看起來跟正確答案一樣合理,卻照樣讀不出來。兩個缺陷都得清掉,數字才會對上
// THPDFDataMatrix.ComputeEC,位於 HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]:根依序是 alpha^1..alpha^ECCount,不是從 alpha^0 開始
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
參考點小到可以寫在註解裡。字串 '123456' 編成 ASCII 碼字 142 164 186,10x10 的符號帶五個檢查碼字,正確區塊是 114 25 5 88 102。HPDFDataMatrixTestComputeEC 把 {$IFDEF HPDF_TESTING} 閘門後面的類別函式暴露出來,所以 fixture 不用實例化編碼器、不用渲染頁面就能斷言這五個值。伽羅瓦體本身從頭到尾都是對的——它由 InitDMTables 以本原多項式 $12D 建進 DMExp 與 DMLog 兩張表——這正是 bug 藏得那麼好的原因
PDF417 在質數體上做除法,符號很重要
PDF417 要改四處而不是一處,因為 GF(929) 是質數體而不是二元擴張體:加法不是 xor、減法不是加法,每個產生器因子的符號是真實運算而不是記號問題。每個因子必須是 (x - 3^i),在程式碼裡代表要乘上 929 - GF929Pow(3, I);消減步驟必須用減法;根依 ISO/IEC 15438 §5.5 從 3^1 開始;Factor 必須在內層迴圈開跑前鎖進區域變數,因為 J = 0 那一趟會寫 Work[I],不鎖的話乘數會在自身底下被換掉。HPDFPDF417TestComputeEC 釘住了修正後的結果:碼字 5 453 178 121 239 配上四個錯誤更正碼字得到 452 327 657 619
// THPDFPDF417.ComputeEC,位於 HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // 因子是 (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // 鎖住:J = 0 會改寫 Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Data Matrix 的尋找圖案被裝反了
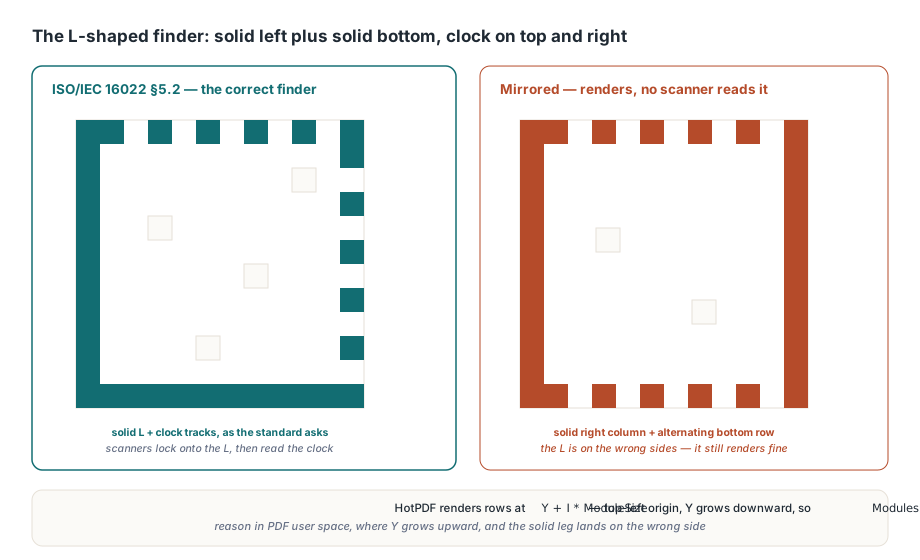
檢查碼字再正確也救不了尋找圖案被鏡像的符號,同一個版本還得把這個也修掉。擺放程式畫的是實心左欄、實心右欄,加上沿著上下兩列跑的交替模組;而 ISO/IEC 16022 §5.2 要求的是實心左欄加實心下列構成的 L 形尋找圖案,交替的時序軌道沿著頂列與右欄跑。這件事之所以很容易做反,是座標慣例的關係:HotPDF 用 Y + I * ModuleSize 逐列渲染模組,這是左上角原點的語意,所以 Modules[Size - 1, *] 是印出來符號的最下列。任何在 PDF user space(Y 向上成長)裡思考的人,都會把實心那條腿放錯邊,而且螢幕上看不出任何異狀
四個壞掉的編碼器為什麼多年來一直過得了測試?
因為測試斷言的是結構,而缺陷在算術裡。既有的 QR、Data Matrix 與 Aztec 測試檢查的是尋找模組、時序圖案與符號尺寸——這些全是真的對的;從來沒有任何測試把檢查碼字拿來跟公開發表的向量比對過。第二個理由更值得推廣。HotPDF 內建一個 QR 解碼器,拿它來驗證編碼器聽起來是很自然的 round trip,偏偏這個解碼器只讀資料碼字、不做任何 Reed-Solomon 更正,所以它把編碼器寫的東西原封不動讀回來,然後回報成功。當編碼器與解碼器共享同一個假設,round-trip 測試證明的只是它們彼此一致,不是其中一個正確。錯誤更正碼必須對照印在標準裡的向量驗證,永遠不要用你自己的解碼器。fixture THPDFBarcodeECCTests 現在每種格式各有一條測試,名稱寫明它釘住什麼,每一條都透過只在 {$IFDEF HPDF_TESTING} 底下編譯的 hook 觸及算術:
QRCheckWordsMatchISO18004Example斷言 version 1-M 位元組模式範例的十個檢查碼字DataMatrixCheckWordsMatchISO16022Example針對碼字 142 164 186 斷言 114 25 5 88 102PDF417CheckWordsMatchGF929Reference在 GF(929) 上以根 3^1 到 3^4 斷言 452 327 657 619AztecCheckWordsKeepMessageAndMatchReference斷言檢查碼字,也斷言訊息碼字在原地除法後仍然健在
四個問題能抓住你在維護的任何編碼器裡大部分這種家族缺陷。你的產生多項式存放順序跟除法索引順序一致嗎,能不能指得出證明它的那一行?根有沒有從標準說的地方開始,Data Matrix 是 α^1、PDF417 是 3^1?原地除法事後有沒有還原訊息區段?至少有一條測試是把檢查碼字——而不是模組數量——拿來跟規格書裡印的數字比對嗎?決定怎麼處置既有產物時,影響範圍也很重要。v2.748.0 之前產生的符號在理想條件下照樣渲染、也常常掃得過,因為乾淨的影像不需要更正就能讀;它們失去的是損傷容錯,而這正是選擇這些格式的全部理由。載有受影響符號的長壽標籤與封存文件,與其拿手機相機隨手驗一下,不如重新產生。編碼器住在HotPDF 的條碼支援裡,旁邊是QR 解碼路徑與它的方向處理,還有把符號放上頁面的報表輸出層;完整的條碼 API 參考隨HotPDF Delphi Component提供,支援 Delphi 與 C++Builder