在一份新生成的 PDF 里搜「two-x」,结果可以是零命中,而页面上明明写着那五个字符。把提取出的字符串按码点转储出来,原因一目了然:连字符回来了,是 U+00AD SOFT HYPHEN;它后面的空格回来了,是 U+00A0 NO-BREAK SPACE。两者在屏幕上看起来一模一样。差别藏在 ToUnicode CMap 里——阅读器靠这张表把字符码换回 Unicode——而它源于一个字体字形被两个码点共享
普通字符串工具会让错配雪上加霜。CSV 导出的分列结果不一样了,diff 工具标出两行在每个查看器里读起来都相同的行,拼写检查器把带软连字符的「two-x」当成生词。Unicode 规范化只救你一半:NFKC 会把 U+00A0 折叠成普通空格,因为 NBSP 带兼容分解;U+00AD 却没有任何分解,软连字符在任何规范化形式下都能存活
为什么提取出的空格变回 U+00A0?
当 ToUnicode CMap 以字形为键、而一个字形可以从两个码点到达时,提取出的空格就变成 U+00A0。在 Arial 里,glyph 3 同时服务 U+0020 和 U+00A0,连字符字形同时服务 U+002D 和 U+00AD。从字形侧建出来的 CMap 必须对 CID 0003 说点什么,而 PDFium 在 FPDFText_LoadFont 里的生成器最后说了两件事:一条把它映射到 U+0020 的 bfchar 条目,和一个把同一 CID 映射到 U+00A0 的数组形式 bfrange
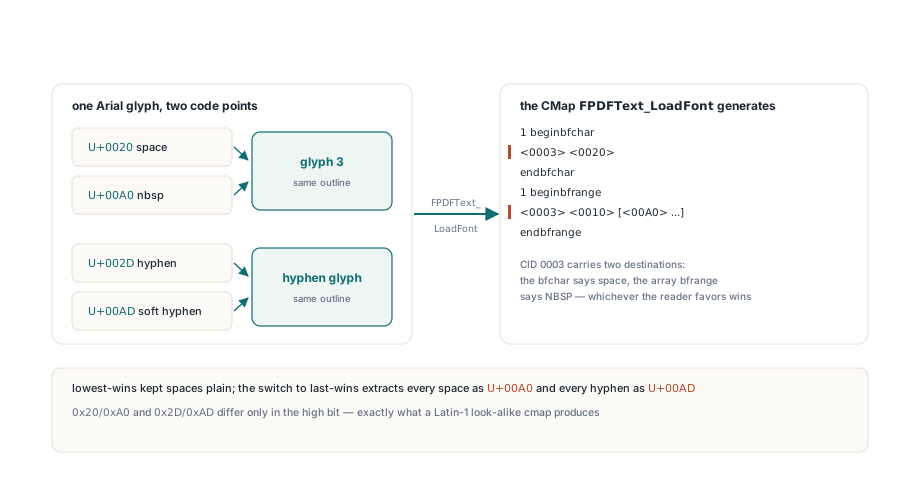
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 描述了 bfchar 和 bfrange 如何把字符码映射到 Unicode,却没说两条条目声明同一个 CID 时哪条赢。读取器各自选一条优先级规则。保留最低或第一条映射的阅读器提取出普通空格;PDFium 的读取器保留最后一条,而数组 range 又排在 bfchar 块之后,于是凡经按字形建键的 CMap 写出的空格都提取成 NBSP、每个连字符都提取成软连字符。同一份文件的同一段文本,因此可能在两个查看器里提取出不同结果
这些配对有规律可循。0x20/0xA0 和 0x2D/0xAD 只差最高位,这正是字体的 cmap 把 Latin-1 相似字符送进 ASCII 字符已有轮廓时的产物。希腊大写 Omega(U+03A9)和 Ohm 符号(U+2126)在 Arial 里也共享一个字形。如果从前正常的提取代码如今在你看不见的字符上翻车,请把码点打印出来,别信调试器的字符串视图;从页面读出文本的基础见在 Delphi 里用 PDFium 从 PDF 文档提取文本
PDFium Component 如何按码点为系统字体建键
对带有 Unicode cmap 的系统字体,PDFium Component 从不让引擎生成那种 CMap。TPdf.AddText 需要字体时,组件读字体自己的 sfnt cmap 表,优先 format 12 子表,退回 format 4。码点返回时已排序去重,CID k+1 分给第 k 个码点,CID 0 留作 .notdef。一个显式 CIDToGIDMap 把每个 CID 指到它的字形。于是 U+0020 和 U+00A0 拿到两个不同的 CID、画同一个轮廓,组件写出的 ToUnicode CMap 把每个 CID 恰好映射到一个码点
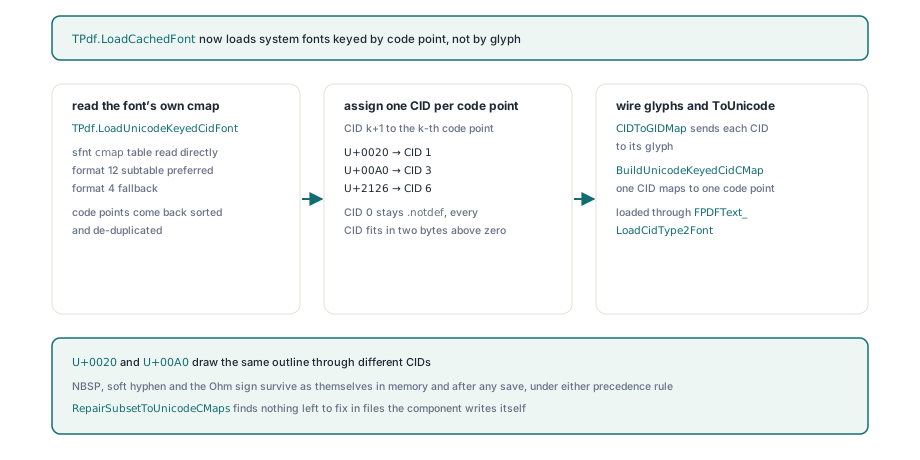
字体经 FPDFText_LoadCidType2Font 加载——也就是带显式 CID-to-GID 映射的 CID Type 2 字体嵌入里字形级写入背后的同一个入口。之后 FPDFText_SetText 写字符串时,反向查找每个字符都落在一个 CID 上。这件事完全不依赖读取器的优先级规则,因为没有第二条映射可供规则挑选。存出的文件同样带着组件自己的 ToUnicode 流,所以重新加载之后的提取看到的,与活文档用的一对一表相同
代价是一个更大的 CIDToGIDMap:字体覆盖的每个码点两字节。假设一个字体映射约 3000 个码点,这张图就约 6 KB,随每个字体交给引擎。这笔交易任何时候都值得做:几千字节换来的是在 PDFium、在保留第一条映射的查看器、以及明年客户跑的随便什么索引器里都读得一致的提取
下面的往返测试写入一个含全部麻烦配对的字符串,从未保存的文档提取一次,保存、重载后再提取一次。两个结果都应与输入完全一致;CodePoints 辅助函数只为了让错配可读:
uses
  SysUtils, PDFium;

const
  // 空格/U+00A0 与连字符/U+00AD 共用一个 Arial 字形,
  // 希腊 Omega(U+03A9)与 Ohm 符号(U+2126)也一样
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // 活的、未保存的文档
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // 完整保存并重新加载之后
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
即使你的文档很少含有 NBSP 和软连字符,也把它们留在示例字符串里。只写 ASCII 的测试对着按字形建键的 CMap 一样能过,因为它里面的任何内容都没让阅读器在两条映射之间做选择
为什么一个 bfrange 条目能抹掉整个块?
一条 CID 区间跨过 xxFF 边界的 bfrange 会让 PDFium 丢弃它所在的整个块。ISO 32000-1 §9.10.3 只允许目标值的最后一个字节在范围内变化,而 CID 一侧在 PDFium 的解析器里有一个对应的陷阱:它把高 CID 推导成 (low and $FFFFFF00) or (high and $FF)。从 CID 00FE 到 0101 的区间被读成 00FE 到 0001,low 大于 high,整个块被标为无效。SetText 成功,页面渲染正常,提取却给那个块里的每个字符返回 U+0000
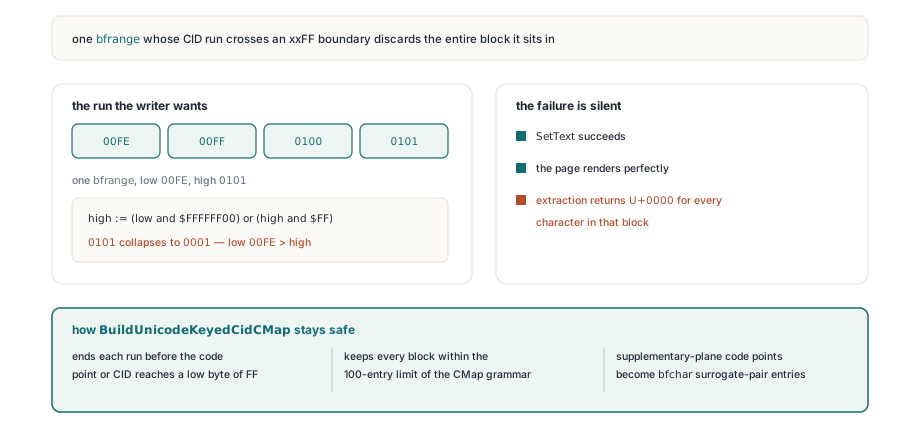
按码点建键的字体恰恰是这个问题咬人的地方。CID 致密且连续,所以任何超过 255 个码点的字体,其 CID 区间只要写入器简单合并连续条目就会跨过 00FF、01FF 等边界。PDFium Component 写出的 CMap 在码点或 CID 的低字节到达 FF 之前就结束区间,并把条目拆成至多 100 条的块——这是 CMap 语法给每个 beginbfrange 和 beginbfchar 节定的上限
U+FFFF 以上的码点各拿一条 bfchar 条目,目标为 UTF-16 代理对,因为在区间内递增代理对没有定义过的含义。代理对那部分故事见Delphi 里的 emoji、CJK 与代理对处理。纯 bfchar 的 CMap 能完全绕开边界问题,代价是体积翻好几倍,所以 range 仍是主形式,拆分规则承担重担
修复其他工具产出文件里的 ToUnicode 冲突
FPdfCompress 单元里的 RepairSubsetToUnicodeCMaps 修复组件没有写过的文件中的按字形建键冲突。TPdf.SaveAs 在每次完整、非增量保存时运行它,你也可以直接对任意流调用。对每个带两个目标的 CID,bfchar 条目赢;CID 没有 bfchar 时,只差最高位的一对解析成较小的 base-Latin 码点。任何其他冲突保留第一条映射
修复只对冲突的十六进制值做原位等长替换。块布局、CID 覆盖和流里其他每个字节都保持原样,所以 CMap 仍处于 PDFium 读取器已经接受的形状。干净重建的 CMap 在十六进制转储里会好看些,但它也改变了严格读取器已经接受的流的结构——当错的只是少数几个目标值时,这是一场没有上行空间的赌博
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // 只做等长编辑;没有可修复冲突的文件,
      // 以及交叉引用流或对象流文件,原样复制
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.这个例程重建经典交叉引用表,所以使用交叉引用流、混合引用或对象流的文档逐字节原样通过。增量保存(saIncremental)按设计跳过修复,因为增量修订必须保持只追加。对组件自己写的文本,两种情况都无关紧要:它的按码点建键字体从不产生可供修复发现的冲突
按码点建键的路径覆盖哪里
按码点建键的路径覆盖每个暴露 Unicode cmap 子表的字体,其余交给 PDFium 的按字形加载。依赖它之前值得知道的细节:
- 只有 (3,0) cmap 的 Symbol 字体,以及 CID 路径无法加载的任何字体,走
FPDFText_LoadFont,那里两个码点共享的字形仍受读取器优先级规则的支配 - 只有 format 4 子表时,映射覆盖基本多文种平面(BMP);平台 (3,10) 或 Unicode 平台上的 format 12 子表把增补平面码点也纳入
- 字形 0 和代理码点被排除在外,条目数封顶 65535,让每个 CID 都装得进零以上的两个字节
- TrueType Collections 要多留个心眼:GDI 的
GetFontData返回整个 .ttc,而FPDFText_LoadCidType2Font没有 face index 参数,直接把集合传过去会嵌入 face 0 的 SimSun,哪怕你从 simsun.ttc 请求的是 NSimSun。组件把家族名对到字体的 name 表(nameID 1 和 16)上,把请求的 face 以独立 sfnt 交付;解析不了的集合整个传下去、使用 face 0 - 若请求名称的系统字体读不出来,
AddText把字体名交给FPDFPageObj_NewTextObj,由它在 PDFium 的标准字体里查找
在索引层折叠不可见字符,在文本里保留它们
提取返回真实码点之后,另一个问题浮上来:搜索索引该怎么对待作者刻意敲进去的真 NBSP 或软连字符?在索引层折叠它们,TPdf.Text 保持原样。提取出的字符串是文档说了什么的记录;索引是为匹配构建的有损视图,折叠规则属于它
下面的辅助函数由你自己加进代码。它把 NBSP 映射成空格、丢掉软连字符——按 Unicode 标准,软连字符只标记一个可以断行的地方。它刻意不动 U+2126:NFC 规范化会把 Ohm 符号变成 Omega,因为 U+2126 有到 U+03A9 的标准单一分解,而资料表搜索该不该匹配这两个,是产品决策而非提取决策:
uses
  SysUtils, Classes, PDFium;

// 你自己的搜索索引辅助函数;不属于 PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // 原样文本留在 Pdf.Text 里
    end;
  finally
    Pdf.Free;
  end;
end;
对第一个例子里生成的 codepoints.pdf 跑 IndexDocument,索引行应读作「two-x yz ΩΩ」——十一个字符,最后一个就是 Ohm 符号;而 Pdf.Text 仍返回全部十二个原始字符,NBSP 和软连字符都在
按码点建键的字体、CMap 修复和文本提取在 Delphi、C++Builder 和 Lazarus 上共用同一个页面模型;字体与文本 API 在 PDFium Component for Delphi 产品页面上有完整介绍