PDFium Component 通过 AddCidType2Text 在字形级别把文本写入 PDF 页面,把你提供的 TrueType 数据以 CID Type 2 字体的形式内嵌。它会为每一个字形实例分配一个连续的 CID,生成显式的 CID 到 GID 映射和 ToUnicode CMap,并把落在同一基线上的字形合并成一个原生文本对象。可选的子集化能让文件保持紧凑,并为子集化失败时该怎么办制定了明确的策略
当文本已经完成成形处理时,字形级别的写入正是你需要的方式。阿拉伯语、天城文以及任何带有上下文变形的文字,都会产生一串不再与字符一一对应的字形标识符序列,因此一个只接受字符串和字体名称的 API 无法表达这样的结果。直接交出字形与位置信息,是把成形正确的复杂文字文本放进 PDF 的唯一方式
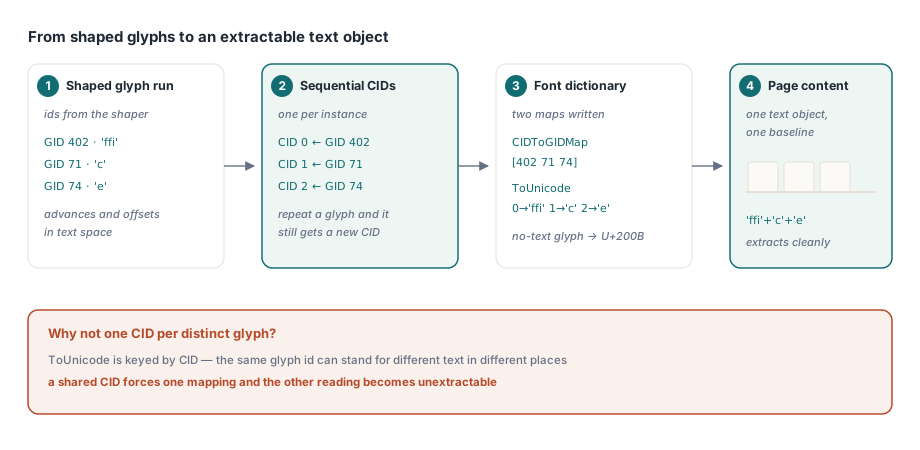
为什么每个字形实例都要有自己的 CID
一个诱人的优化是去重:每个不同的字形标识符只用一个 CID,在它出现的每个地方重复使用。这样确实能得到更小的字体,但也会破坏文本提取,因为同一个字形在不同的位置,完全可能合理地对应不同的 Unicode 内容
连字字形就是最典型的例子。同一个 "ffi" 字形,在一个词里可能代表这三个字符,而在经过另一种成形决策之后,别处又可能代表别的内容。ToUnicode 映射是按 CID 建立索引的,因此一个共享的 CID 只能承载一种映射,无论是哪一段文本在这场争夺中落败,都会变得无法提取
因此每一个字形实例都拥有自己的 CID,每一条映射也可以自由对应多个 UTF-16 码元。一个没有实际文本含义的字形——装饰性元素、仅用于定位的字形——会显式映射到 U+200B(零宽空格),这样每一个 CID 都有一个可观察的提取结果,而不是一个空缺
uses
  PDFium;

var
  Pdf: TPdf;
  Glyphs: TPdfCidGlyphs;
  Options: TPdfCidFontOptions;
  Report: TPdfCidFontReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'label.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;

    // 每个已成形的字形对应一项:字形 id、它所代表的文本,
    // 以及它在文本空间中的前进量和偏移量
    SetLength(Glyphs, 3);
    Glyphs[0].GlyphID := 402;  Glyphs[0].UnicodeText := 'ffi';
    Glyphs[0].Advance := 18.4;
    Glyphs[1].GlyphID := 71;  Glyphs[1].UnicodeText := 'c';
    Glyphs[1].Advance := 9.8;
    Glyphs[2].GlyphID := 74;   Glyphs[2].UnicodeText := 'e';
    Glyphs[2].Advance := 9.2;

    Options := TPdfCidFontOptions.Default;   // 优先子集化
    Options.VerifyExtraction := True;

    if Pdf.AddCidType2Text(LoadFileBytes('NotoSans.ttf'), Glyphs,
         11, 72, 700, Options, Report) then
      Writeln(Format('%d glyphs, %d unique, font %d -> %d bytes, match=%s',
        [Report.GlyphCount, Report.UniqueGlyphCount,
         Report.OriginalFontBytes, Report.EmbeddedFontBytes,
         BoolToStr(Report.ExtractionMatches, True)]));
  finally
    Pdf.Free;
  end;
end;
子集化,以及一个返回码无法告诉你的那些检查
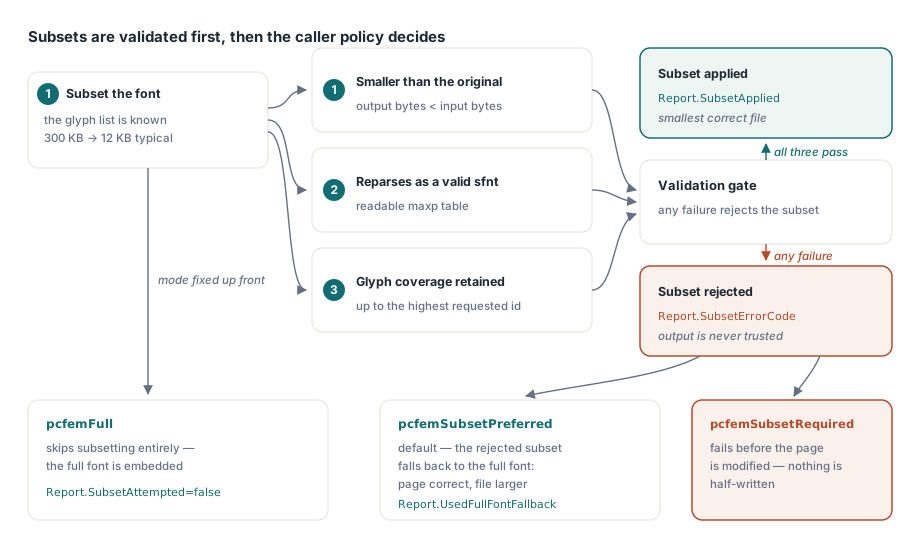
把字体子集化到只包含实际用到的字形,是内嵌 300 KB 还是内嵌 12 KB 的差别,而在一份包含多种字体的文档上,这决定了这份文件能不能通过邮件发送。平台的子集化路径可以直接接受一份字形列表,这与本 API 完美契合,因为调用方本就已经知道所有正在使用的字形标识符
它给不了你的是信心。子集化调用可能报告成功,却返回一个不可用的结果,因此本组件在接受结果之前会校验三项属性:输出必须比原始字体更小,它必须能作为一个有效的 sfnt 重新解析且带有可读的 maxp 表,并且必须保留到所请求的最高原始标识符为止的所有字形。任何一项失败,子集都会被拒绝
接下来发生什么由调用方的策略决定。在默认的 pcfemSubsetPreferred 下,一个被拒绝的子集会回退到内嵌完整字体,因此页面依然正确,只是体积更大。在 pcfemSubsetRequired 下,操作会在页面被修改之前失败,这正是一个受体积约束的处理流水线所需要的。pcfemFull 则完全跳过子集化。报告会通过 SubsetAttempted、SubsetApplied、UsedFullFontFallback 和 SubsetErrorCode 告诉你走的是哪一条路径
不会产生误判的校验
启用 VerifyExtraction 后,本组件会确认它写入的内容能够被正确读回。实现这一点的一种朴素做法是提取整个页面并搜索期望的字符串,而这种做法是错的:一个本来就已经包含那段文本的页面,即使新写入的文本本身有误,也会通过这项检查
正确的做法是重建文本页面,并按插入顺序单独读取由本次调用插入的各个对象句柄,再拼接起来。结果会与期望文本做比较,报告中会同时暴露这两段字符串以及那个布尔值,因此一次不匹配可以被诊断出来,而不只是被检测到
在开发阶段以及任何以可提取性为要求的流水线中都应该打开这个选项——可搜索归档、无障碍合规、下游文本挖掘。它的代价是每次调用要重建一次文本页面,这也是它在高频循环中默认不开启的原因
预算与原子性失败
字体字节数、字形实例数和 Unicode 码元数都会在分配之前分别设定上限,字体格式、TTC 索引、字形标识符范围以及几何数值也会在写入任何内容之前先做校验。几何值必须是有限数,这听起来理所当然,直到某个成形引擎从一个格式错误的字体里给你递来一个 NaN 前进量为止
失败是在页面级别原子性发生的。如果字体加载、对象写入、内容生成或提取校验中的任何一步失败,本次调用插入的所有对象都会按相反顺序移除,页面内容会重新生成。一次失败的调用会让页面保持原样,而不是留下半截文本行
它在文本处理流水线中的位置
这里的分工值得说清楚。成形——把字符转换成带位置的字形——不是这个 API 的职责,那属于成形引擎,本组件自身的双向文字和复杂文字支持见 emoji、CJK 与代理对处理。这个 API 是你在拿到成形器产出的字形序列之后才调用的下一步
对于没有上下文成形需求的普通拉丁文文本,更简单的基于字符串的文本 API 才是正确的工具,代码也更简洁。当你已经有了成形好的输出、需要精确控制字形标识符,或者字体必须从你手上的字节内嵌而不是按名称解析时,才应该使用 CID Type 2 写入——按名称解析字体的替代方案是 控制 PDF 字体替换 中所述的提供者机制
部署方面有一点要提醒:内嵌字体既是一个技术问题,也是一个授权许可问题。不同字体在是否允许内嵌、是否只允许用于查看、还是允许用于编辑上各不相同。库会内嵌你交给它的任何字节,而检查授权许可是你自己的责任,不是文件格式的责任
字形级别文本写入、字体供给和文本提取,在 Delphi、C++Builder 和 Lazarus 中共用同一套页面模型;完整 API 说明见 PDFium Component for Delphi 页面