PDFium Component 经 FPdfDocumentFontSubset 单元的 SubsetPdfDocumentFonts 子集化已嵌入既有 PDF 的字体。只有当字体资源自身能证明文档可引用的每一个字形时,函数才会把嵌入的 TrueType /FontFile2 程序换成更小的;字形域证明不了的字体原样保留
想用它的常见理由是一批不是你产出的档案。老生成器出的发票、对账单和报表,常常每个文件都带完整的 Arial 或整副 CJK 字体,两页文档背上几百 KB 字体,摊到几百万份就是大数目。从源头重新生成几乎不可行。你手里只有这份 PDF,唯一安全的问题是:每个嵌入字体能裁掉多少,而一页都不丢字符
为什么子集化既有 PDF 有丢字形的风险?
子集化既有 PDF 有丢字形的风险,因为后处理器不知道原作者用过哪些字形。嵌入字体的生产者了解自己的文本;事后跑的工具得重建那份了解,而漏掉的任何一个字形都会变成空框或 .notdef 形状——留在没人看的页面上,直到某个客户看到
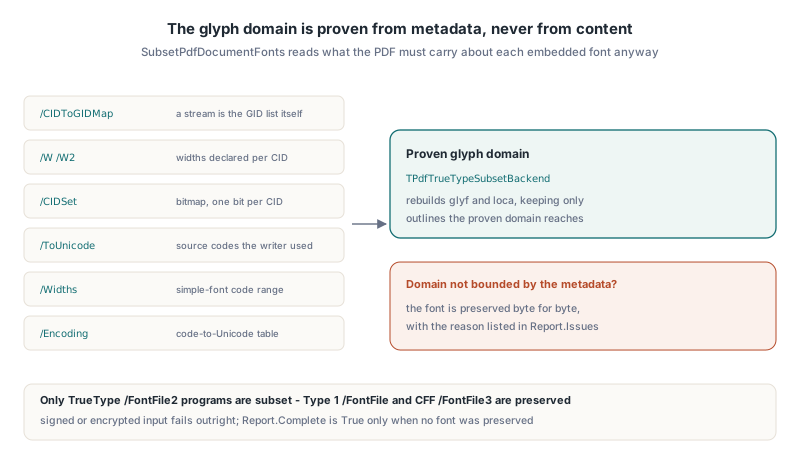
想当然的做法是解析每条内容流、每个 Form XObject、每个注解外观和每个字段默认外观,收集每种字体显示过的码,保留那些字形。它一路工作,直到撞上跨页面与 form 共享的字体资源、外观由阅读器从 /DA 重新生成的表单字段、或扫描器没建模的操作符序列。SubsetPdfDocumentFonts 刻意不扫内容流。它从 PDF 无论如何都要为每种字体携带的元数据推导字形域:/CIDToGIDMap、/W 与 /W2 宽度数组、/CIDSet 位图、/ToUnicode CMap、简单字体的 /Widths 数组和 /Encoding。元数据框不住域时,字体原样不动
保留原始字形 ID,内容流一字不动
SubsetPdfDocumentFonts 背后的子集后端 TPdfTrueTypeSubsetBackend 保留每个原始字形 ID 槽位,所以任何内容流、CID 或 /CIDToGIDMap 都不需要重写。它重建 glyf 与 loca 表,给每个未用字形一个零长 loca 区间,maxp.numGlyphs 保持不变。子集化之后字形 4711 还是字形 4711;只是文档够得着它时才有轮廓
这个选择消除了子集化成品文档最危险的部分。重排字形号意味着重写使用该字体的每条内容流里的每个字符串、映射流、以及一切缓存字形 ID 的地方。保留 ID 略费尺寸——loca 为每个原始字形留一个条目——但 TrueType 程序的大头是轮廓数据,去掉的正是它。复合字形追到其组件,所以带变音符的字母保住基础字母和构成它的变音符;循环或过深的复合引用让整个字体失败,而不是产出破闭环
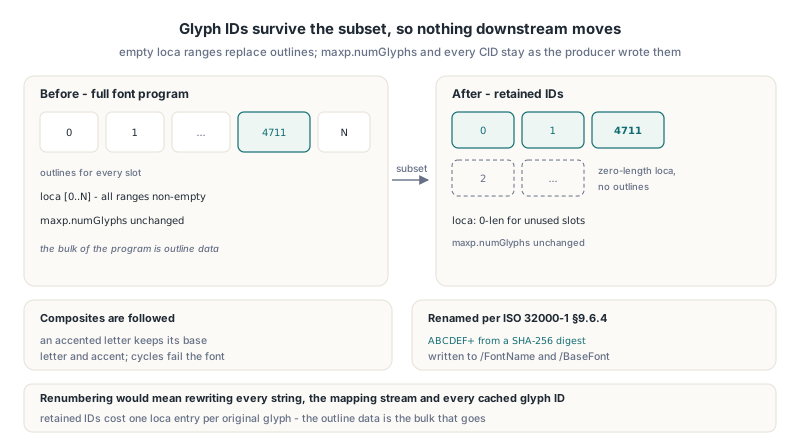
改名后的字体也遵循 ISO 32000-1 §9.6.4——它要求子集字体名以六个大写字母加加号开头。组件从新字体程序的 SHA-256 摘要导出那六个字母,先剥掉已有的 ABCDEF+ 前缀,解决同一文档内字体间的撞名,把新名字写进描述符的 /FontName 和字体字典的 /BaseFont——包括 CIDFont 的 Type0 父级
uses
  System.SysUtils, System.Classes, FPdfDocumentFontSubset;

procedure SubsetEmbeddedFonts(const SourceName, TargetName: string);
var
  Source, Target: TFileStream;
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Source := TFileStream.Create(SourceName, fmOpenRead or fmShareDenyWrite);
  try
    if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
      raise Exception.Create('Font subsetting failed: ' + Report.ErrorMessage);
  finally
    Source.Free;
  end;
  // 输出永远是完整 PDF:Report.Applied 为 True 时是重建的文件,
  // 否则是源文件的逐字节副本
  Target := TFileStream.Create(TargetName, fmCreate);
  try
    if Length(Output) > 0 then
      Target.WriteBuffer(Output[0], Length(Output));
  finally
    Target.Free;
  end;
end;
SubsetPdfDocumentFonts 怎么证明 CIDFont 的字形域?
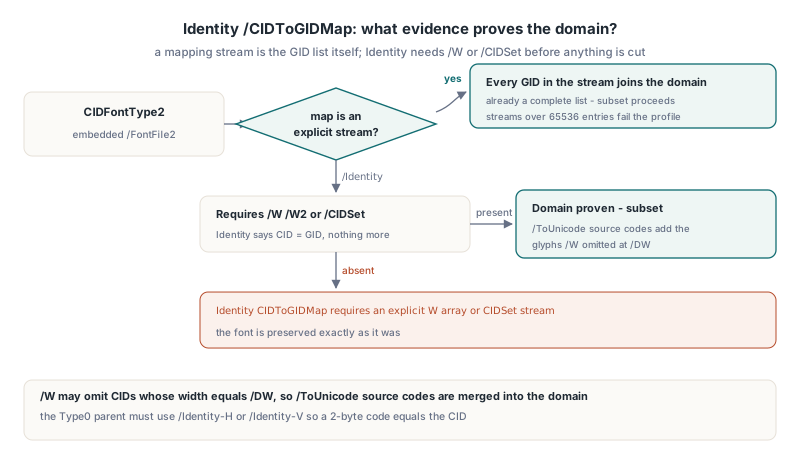
SubsetPdfDocumentFonts 从 CID 到字形的映射证明 CIDFontType2 字体的字形域,而映射决定还需要多少额外证据。显式 /CIDToGIDMap 流(ISO 32000-1 §9.7.4.2)本身就是该字体可寻址每个字形的清单,流里的每个 GID 都入域。映射流超过 65536 项、或字节数为奇数,超出有界 profile,字体保留
/CIDToGIDMap /Identity 是难啃的情形,也是现代文件里最常见的。Identity 说 CID 等于 GID,对文档用了哪些 CID 什么也没说。因此组件要求一手证据:显式 /W 或 /W2 宽度数组(§9.7.4.3)——其 CID 条目标记生产者为哪些字形声明过度量——或字体描述符里的 /CIDSet 流(§9.8.3),每个 CID 一位、高位在前的位图。两者皆无的裸 Identity 字体被保留,理由是 Identity CIDToGIDMap requires an explicit W array or CIDSet stream
拿 /W 当证据的陷阱在 /DW。规范允许生产者省略宽度等于默认宽度的每个 CID,优化得好的写入器对最常见的字形宽度正是这么干的。域若只来自 /W,那些字形会悄悄从子集里消失。为堵住这个缺口,组件遍历每台 /DescendantFonts 指向该 CIDFont 的 Type0 字体,要求其 /Encoding 为 /Identity-H 或 /Identity-V——保证 2 字节码即 CID——并把其 /ToUnicode CMap(§9.10.3)里每条 beginbfchar 与 beginbfrange 条目的源码并入域。其他任何编码、或预算内解不开的 /ToUnicode 流,都让字体保留
简单 TrueType 字体:从 Widths 到字形 ID
单字节 /Subtype /TrueType 字体经码域与编码证明,再经字体程序自己的 cmap 解析到字形 ID。组件要求 0 <= FirstChar <= LastChar <= 255,以及长度恰为 LastChar - FirstChar + 1 的 /Widths 数组;过短、过长或含非数字的数组意味着码域未被证明,字体保持原样
该范围内的每个码,外加 /Differences 点名或 /ToUnicode 覆盖的码,随后按 ISO 32000-1 §9.6.6 描述的方式映射。/WinAnsiEncoding、/MacRomanEncoding 或 /StandardEncoding 下的码经对应表转 Unicode。/Differences 字形名经 Adobe Glyph List、uniXXXX 与 uXXXX 命名、258 个标准 Macintosh 字形名以及字体自己的 post 格式 2.0 名表解析。得到的值在格式 0、4、6 和 12 的 cmap 子表里查找,包括 Unicode 的 (3,1)、(3,10) 和 (0,*),Mac Roman 的 (1,0),以及 Windows Symbol 的 (3,0) 于 F000 加码
字体完全没有基础编码时,组件标记所有合理解释的并集,而不是挑一个。这会多留几个大概用不上的字形——往安全方向错。反过来的情形则严格:/Differences 里映射不到任何已证字形 ID 的名字会拒绝整个字体,因为一个解析不了的名字就意味着域不完整
procedure ReportFontSubset(Source: TStream; Log: TStrings);
var
  Options: TPdfDocumentFontSubsetOptions;
  Report: TPdfDocumentFontSubsetReport;
  Output: TBytes;
  I: Integer;
begin
  Options := TPdfDocumentFontSubsetOptions.Default;
  Options.SubsetOptions.MinimumSavingPercent := 10;  // 每字体
  Options.MinimumDocumentSavingPercent := 5;         // 整个文件
  if not SubsetPdfDocumentFonts(Source, Options, Output, Report) then
  begin
    Log.Add('Rejected: ' + Report.ErrorMessage);
    Exit;
  end;
  Log.Add(Format('Fonts %d, subset %d, preserved %d, glyphs %d',
    [Report.FontCount, Report.SubsetFontCount, Report.PreservedFontCount,
     Report.GlyphCount]));
  Log.Add(Format('Font bytes %d -> %d, file bytes %d -> %d',
    [Report.OriginalFontBytes, Report.SubsetFontBytes,
     Report.SourceByteCount, Report.OutputByteCount]));
  for I := 0 to High(Report.Issues) do
    Log.Add(Format('  object %d kept: %s',
      [Report.Issues[I].ObjectNumber, Report.Issues[I].Reason]));
end;
SubsetPdfDocumentFonts 对哪些东西不动手?
SubsetPdfDocumentFonts 不碰它证明不了的每种字体,并把每一台连同对象号与理由记进 Report.Issues,而不是让整个文档失败。只有没有任何字体被保留时 Report.Complete 才是 True。在承诺缩减尺寸之前,值得知道这些保留情形:
- Type 1 的
/FontFile与 CFF 或 OpenType 的/FontFile3程序,报为Only TrueType FontFile2 programs are supported - 没有
/W、/W2或/CIDSet的 Identity CIDFont,以及既无映射流也非/Identity的 CIDFont - 字体程序被字体描述符之外的地方引用,以及描述符被既非
CIDFontType2也非简单TrueType的消费方共享 - 子集达不到
SubsetOptions.MinimumSavingPercent的字体;重建文件达不到MinimumDocumentSavingPercent时则所有字体——此时Report.Applied为False,输出是原始字节
有两种输入是直接失败而不是保留。已签名文档与带签字段的文档被拒,因为替换字体对象会让每个签名的字节区间失效;加密文件需要先解密。成功的运行以稀疏更新写出替换对象,然后经 孤儿对象修剪与资源去重指南描述的同一趟可达性遍历重建文件,于是旧字体程序不会以不可达对象的形态存活,结果是一个干净的单修订版
保存时子集化新文本:saSubsetNewFonts
PDFium Component 在当前会话里嵌入的字体是另一回事,由保存选项 saSubsetNewFonts 而不是 SubsetPdfDocumentFonts 处理。saSubsetNewFonts 对应 PDFium 的 FPDF_SUBSET_NEW_FONTS 标志,它让原生 HarfBuzz 子集化器处理经 TPdf.AddText 之类原生调用从系统加载的字体,包括 OpenType CFF 字体。上游 PDFium 仍把这个标志标为实验性。它不碰文件里本来已有的字体
var
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(0, 595, 842);
    Pdf.AddText('Quarterly statement', 'Arial', 14, 72, 770, clBlack, $FF, 0.0);
    if not Pdf.SaveAs('statement.pdf', saSubsetNewFonts) then
      raise Exception.Create('Save failed');
  finally
    Pdf.Free;
  end;
end;
在组件的探针里,带 Arial 文本的文档在 saSubsetNewFonts 下从 590 KB 降到 22 KB,保存文件里的文本提取仍然完全一致。一个 COLR v0 彩色字体——7.0 MB 的 Segoe UI Emoji——走过同一条路降到 10.5 KB,按其基础轮廓渲染,因为 PDF 没有 COLR 层的概念。可变字体是例外,拦在子集化器之前:GDI 的 GetFontData 为 1.85 MB 的 Segoe UI Variable 文件返回了 18.3 MB 的替代流,文本对象创建在任何子集化开始之前就失败了。从 Delphi 嵌入 CID Type 2 字体的走读讲了那些字体先要经过的嵌入路径
证明的尽头
SubsetPdfDocumentFonts 内的证明,强度恰好等于生产者写下的字体元数据。证据只有 /W 的 Identity CIDFont 仍有一个盲点:宽度等于 /DW、没有 /ToUnicode 条目、描述符的 /CIDSet 里也没列出的字形。这样的字形从资源出发不可证明,而组件不做它刻意回避的内容流扫描就无从知道它存在。同时省掉 /ToUnicode 与 /CIDSet 又压缩 /W 的生产者很少,但存在——所以对来历不明的生成器产出的档案,前后各渲染一份样本,比对像素与提取文本
跑批次之前,弄清对手是谁也有帮助。用 PDFium Component 读取 PDF 字体属性的做法告诉你哪些字体嵌入了;干跑一遍的 Report.Issues 告诉你其中哪些会被保留、为什么。默认选项也给工作设了界:1024 台字体、总计约一百万字形、128 MB 源和固定的工作预算,长批次任务可配可选的 CancellationToken
FAQ
SubsetPdfDocumentFonts 会改变 PDF 的文本或布局吗?
不会。原始字形 ID、CID、宽度和内容流全部保留,文本提取与渲染用的还是那些字形;只有够不着的轮廓被移除,字体名拿到新的子集前缀
为什么某个嵌入字体没被子集化?
看 Report.Issues。每台被保留的字体都带着理由——Identity CIDFont 上缺 /W 或 /CIDSet、非 TrueType 程序、畸形的 /Widths 数组,或节省低于阈值
saSubsetNewFonts 与 SubsetPdfDocumentFonts 是一回事吗?
不是。saSubsetNewFonts 在保存时子集化当前会话嵌入的字体;SubsetPdfDocumentFonts 处理一份既有 PDF 流,替换的是别的生产者早已嵌入的字体
文档字体子集化、保存时字体子集化及其背后的孤儿修剪遍历,都随 PDFium Component for Delphi and C++Builder 发布,它为 Delphi、C++Builder 与 Lazarus 项目封装 PDFium