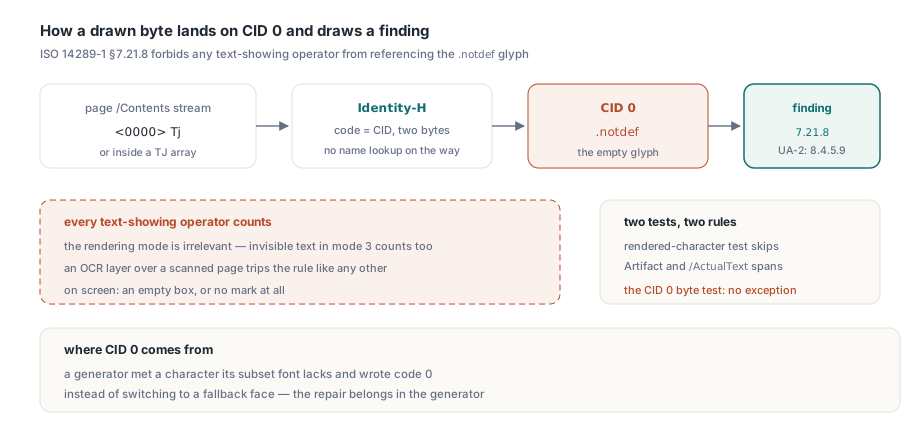
veraPDF 在 ISO 14289-1 §7.21.8 上判一份带标签的季度报告失败,因为一个 Tj 操作符显示了字节 <0000>——在 Identity-H 下这是 CID 0,也就是 .notdef 字形。这条条款和它的邻居 §7.21.6(限制 TrueType /Differences 数组可用的字形名)在 Delphi 里作为独立的旗标出现在 PDFium Component 的 TPdf.ValidatePdfUa 结果中
哪些文本操作符会引用 .notdef 字形?
操作数映射到 0 号字形的文本显示操作符都算。简单字体里,.notdef 是一个字形名;CID 键控字体里同样的角色归 CID 0,ISO 32000-2 §9.7.4.2 要求每个 CIDFont 都含有 CID 0 的字形描述,“类似简单字体里的 .notdef 字符名”。常见的 Identity-H 编码下,字符码与 CID 是同两个字节,内容流用 Tj 或在 TJ 数组里显示 <0000> 就是在画 CID 0。ISO 14289-1 §7.21.8 禁止任何文本显示操作符这么干,PDF/UA-2 在 §8.4.5.9 里写着同样的要求。文本渲染模式无关紧要:模式 3 的隐形文本——比如扫描页上的 OCR 层——照样算数。屏幕上结果通常是几磅宽的空框,或者什么都没有,两种情况都不会告诉明眼校对者有一个字符丢了
常见来源是生成器遇到子集字体里没有的字符,本该切到后备字体却写了码 0。这让字节级检查精确得令人愉快:只解码每页 /Contents 引用的流,在用 Type 0 字体的文档里找喂给 Tj 或 TJ 的 <0000>,图像、ICC profile 和 CMap 保持压缩。一个解析细节决定你找不找得到那些页:ISO 32000-1 §7.3.5 在下一个分隔符处结束名字记号,所以不带空格的 /Type/Page 是合法的页字典,搜带空格的 /Type /Page 会漏掉它。在 Differences 数组里命名 /.notdef 本身不触犯这条规则;只有显示落在那个槽位上的码才算
哪些 /Differences 字形名算 Unicode 合规?
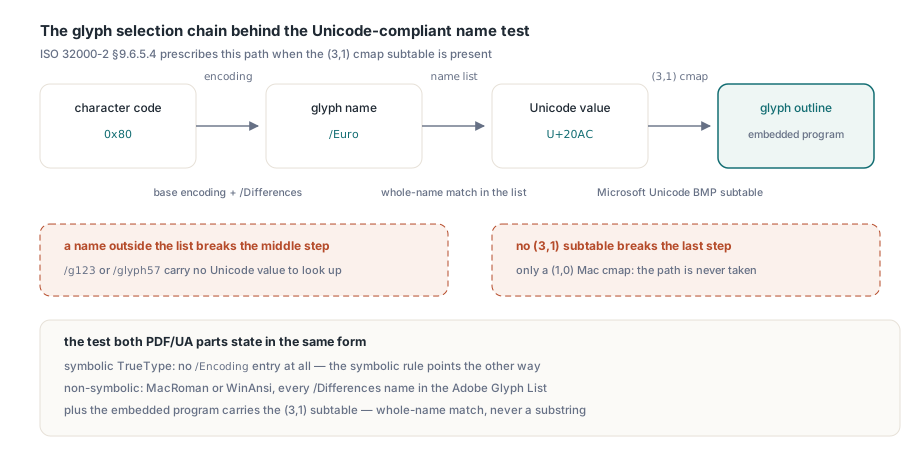
出现在 Adobe Glyph List 里的名字算,前提是内嵌字体程序还含有 (3,1) cmap 子表。背景是 ISO 32000-2 §9.6.5.4,它建议非符号 TrueType 字体使用 MacRomanEncoding 或 WinAnsiEncoding 且不带 Differences 数组;PDF/UA 把这个建议变成要求,只留一个逃生口。两个 PDF/UA 部分都以 veraPDF 采用的同一形式陈述测试:字体是符号字体,或其编码是 MacRoman 或 WinAnsi,且要么没有 /Differences 数组,要么数组里每个名字都 Unicode 合规。(3,1) 条件来自 §9.6.5.4 在该子表(Microsoft 平台、Unicode BMP)存在时规定的字形选择顺序:字符码经编码到字形名,字形名经 Adobe Glyph List 到 Unicode,Unicode 经 (3,1) 子表到字形。清单外的名字断掉中间一步,没有子表的字体根本不走这条路。符号字体规则指向另一头:符号 TrueType 字体根本不许带 /Encoding 条目
| 字体字典 | 结果 |
|---|---|
非符号,/Encoding /WinAnsiEncoding,无 Differences | 通过 |
非符号,WinAnsi 基编码,Differences 含 /Euro /bullet /.notdef,字体有 (3,1) cmap | 通过 |
非符号,Differences 含 /g123 或 /glyph57 | 失败:名字不在字形清单 |
| 非符号,Differences 合规,内嵌字体只有 (1,0) Mac cmap | 失败:没有 (3,1) 子表 |
非符号,WinAnsi 基编码带 Differences,未内嵌 FontFile2 | 本规则不裁定;内嵌规则(§7.21.4)判它失败 |
非符号,无 /Encoding 条目 | 失败 |
符号字体,任何 /Encoding 条目 | 触犯符号规则而失败 |
第二行是自建字形清单翻车的地方。veraPDF 随字体代码发布的清单 font/AdobeGlyphList.txt 有 4,282 个条目,第一行是 .notdef 0000。手工拼的或取自其他来源的表常常缺这个条目,因为 .notdef 不代表任何真实字符。建在这种表上的校验器会报告每个 Differences 数组提到 /.notdef 的字体,而子集字体拿它填未用槽位时这个名字经常出现。匹配按整个名字来:子串搜索会因为 /grave 在清单里就放过 /grav。未用的 Differences 槽位尽管放心用 .notdef 填;跟随 veraPDF 的校验器接受它
字体规则按生成方写下的字节来判
顺手的捷径是存一份归一化的文档副本再扫描它,重写过的文件好解析。对字体规则这招不行:任何重新序列化 PDF 的工具都可以重建字体字典——把 Differences 数组折进新编码、改字形名、重编对象号。编码规则因此必须对着生成方写下的字节来查。TPdf.ValidatePdfUa 在它加载的文件或内存缓冲上跑字体测试,直接解码 FontFile2 流以到达 TrueType 表目录。字符级测试(画出的字符是否映射到 Unicode 0?)用页面渲染的文本,跳过标记为 Artifact 或被 /ActualText 覆盖的内容;CID 0 字节测试不留这种例外。发现项以独立值的形式进入 issue 集,报告因此能说清是哪条规则触发了:
uses
  SysUtils, PDFium, FPdfPdfua;

procedure ReportFontFindings(const FileName: string);
const
  FontIssues: TPdfUaValidationIssues = [pvuaiPdfiumNotDefGlyph,
    pvuaiTrueTypeEncodingInvalid, pvuaiSymbolicTrueTypeEncoding,
    pvuaiFontNotEmbedded, pvuaiFontMissingToUnicode];
var
  Pdf: TPdf;
  Report: TPdfUaValidationResult;
  Found: TPdfUaValidationIssues;
  Coverage: TPdfUaUnicodeCoverageReport;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.CreateFmt('Cannot open %s', [FileName]);
    Report := Pdf.ValidatePdfUa;
    Found := Report.Issues * FontIssues;
    if pvuaiPdfiumNotDefGlyph in Found then
    begin
      Writeln('Text references .notdef / CID 0 (7.21.8, 8.4.5.9)');
      // 定位映射不到任何 Unicode 值的已渲染字符
      Coverage := Pdf.InspectPdfUaUnicodeCoverage;
      for I := 0 to High(Coverage.Objects) do
        if Coverage.Objects[I].MissingUnicodeCharacterCount > 0 then
          Writeln(Format('  page %d, object %d: %d character(s)',
            [Coverage.Objects[I].PageNumber,
             Coverage.Objects[I].PageObjectIndex,
             Coverage.Objects[I].MissingUnicodeCharacterCount]));
    end;
    if pvuaiTrueTypeEncodingInvalid in Found then
      Writeln('Non-symbolic TrueType encoding or Differences (7.21.6, 8.4.5.7)');
    if pvuaiSymbolicTrueTypeEncoding in Found then
      Writeln('Symbolic TrueType font carries an /Encoding entry');
    if pvuaiFontNotEmbedded in Found then
      Writeln('A font program is not embedded (7.21.4)');
    if pvuaiFontMissingToUnicode in Found then
      Writeln('A font has no usable Unicode mapping (7.21.7)');
    if Found = [] then
      Writeln('No font findings');
    // 预期:文件唯一的错是 Differences 数组里的 /g123 时,
    // 只打 7.21.6 那一行
  finally
    Pdf.Free;
  end;
end;
修复属于写出文件的那个程序
两条发现项都不能事后靠改字典安全修掉。CID 0 引用意味着字符在所用字体里没有字形,生成器需要为那个字符配后备字体。把 <0000> 改写成别的码,画出来的是任意字形,还挂着错误的 Unicode 值。带 /g123 这类名字的 Differences 数组通常来自子集化一个字形没有标准名的字体。干净的修法是把那个字体按 CID 键控 TrueType 内嵌——CID Type 2 字体内嵌用的就是这套配置——配 Identity-H 和 /ToUnicode CMap。简单字体的编码规则就此出局
把 Symbolic 旗标设上让 §7.21.6 消失是错招。符号 TrueType 字体根本不许带 /Encoding。原本告诉读屏器每个代码代表哪个字符的 Differences 名字会跟着消失,此后每个查看器都按原始码经 (3,0) 或 (1,0) 子表挑字形。旗标清掉了,文本的含义也随之而去
内嵌字体程序有 (3,1) cmap 吗?
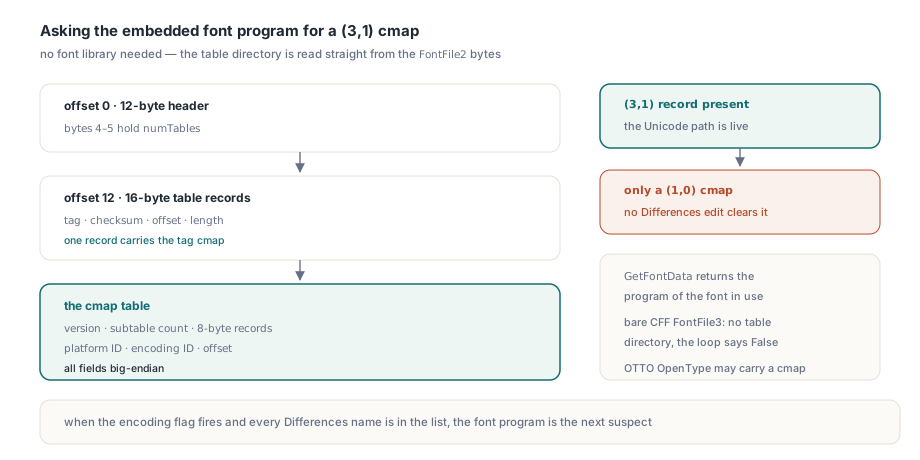
直接问字体程序,因为编码旗标覆盖测试的两半,说不出是哪一半失败。旗标触发而每个 Differences 名字都在清单里时,下一个嫌疑人是字体程序。TrueType 文件以 12 字节头开始,字节 4–5 存表数,后跟 16 字节的表记录(tag、校验和、偏移、长度)。cmap 表以版本和子表数开始,后跟 8 字节记录——平台 ID、编码 ID 和偏移,全部大端。不需要字体库。TPdf.GetFontData 返回页面对象所用字体的内嵌程序,辅助函数因此能跑遍一页上的每个文本对象:
function BE16(const B: TBytes; P: Integer): Integer;
begin
  Result := (B[P] shl 8) or B[P + 1];
end;

function BE32(const B: TBytes; P: Integer): Cardinal;
begin
  Result := (Cardinal(B[P]) shl 24) or (Cardinal(B[P + 1]) shl 16) or
    (Cardinal(B[P + 2]) shl 8) or B[P + 3];
end;

// TrueType 程序含有 (Platform, Encoding) 的 cmap 子表时为 True
function HasCmapSubtable(const Font: TBytes; Platform, Encoding: Integer): Boolean;
var
  Tables, I, Rec, CmapOfs, Count: Integer;
begin
  Result := False;
  if Length(Font) < 12 then
    Exit;
  Tables := BE16(Font, 4);
  CmapOfs := -1;
  for I := 0 to Tables - 1 do
  begin
    Rec := 12 + I * 16;
    if Rec + 16 > Length(Font) then
      Exit;
    if (Font[Rec] = Ord('c')) and (Font[Rec + 1] = Ord('m')) and
       (Font[Rec + 2] = Ord('a')) and (Font[Rec + 3] = Ord('p')) then
      CmapOfs := Integer(BE32(Font, Rec + 8));
  end;
  if (CmapOfs < 0) or (CmapOfs + 4 > Length(Font)) then
    Exit;
  Count := BE16(Font, CmapOfs + 2);
  for I := 0 to Count - 1 do
  begin
    Rec := CmapOfs + 4 + I * 8;
    if Rec + 8 > Length(Font) then
      Exit;
    if (BE16(Font, Rec) = Platform) and (BE16(Font, Rec + 2) = Encoding) then
      Exit(True);
  end;
end;

// 只有 Mac Roman (1,0) cmap 的字体打印 cmap(3,1)=False
procedure ListTextFonts(Pdf: TPdf; PageNo: Integer);
var
  I: Integer;
begin
  Pdf.PageNumber := PageNo;
  for I := 0 to Pdf.ObjectCount - 1 do
    if Pdf.ObjectType[I] = otText then
      Writeln(Format('%-32s embedded=%-5s cmap(3,1)=%s', [
        string(Pdf.GetFontBaseName(I)),
        BoolToStr(Pdf.GetFontIsEmbedded(I), True),
        BoolToStr(HasCmapSubtable(Pdf.GetFontData(I), 3, 1), True)]));
end;
共用一个字体的文本对象会重复打印同一行,这里无害。裸 CFF 程序(FontFile3 带 /Type1C 或 /CIDFontType0C)没有表目录,辅助函数对它答 False;由于规则只管 TrueType 字体,这个答案在这里不决定任何事。CFF 轮廓的 OpenType 字体不同:它们带 OTTO 标签的 sfnt 目录,可能含有 cmap,同一个循环能找到。程序在内存里时,它的 hmtx 步进宽度也值得与字体字典的 /Widths 比一比,PDF/UA 另有宽度一致性规则,字形宽度、CharSet 与 CIDSet 审计从 PDFlibPas 一侧执行了它
如果 §7.21.6 旗标背后的字体让 HasCmapSubtable 返回 False,怎么改它的 Differences 数组都消不掉这条发现项,生成器需要把那个字体按带 ToUnicode CMap 的 Type 0 字体内嵌。在重新生成的文件上再跑一次 PDFium Component for Delphi 校验,预期 pvuaiTrueTypeEncodingInvalid 从 Report.Issues 中消失