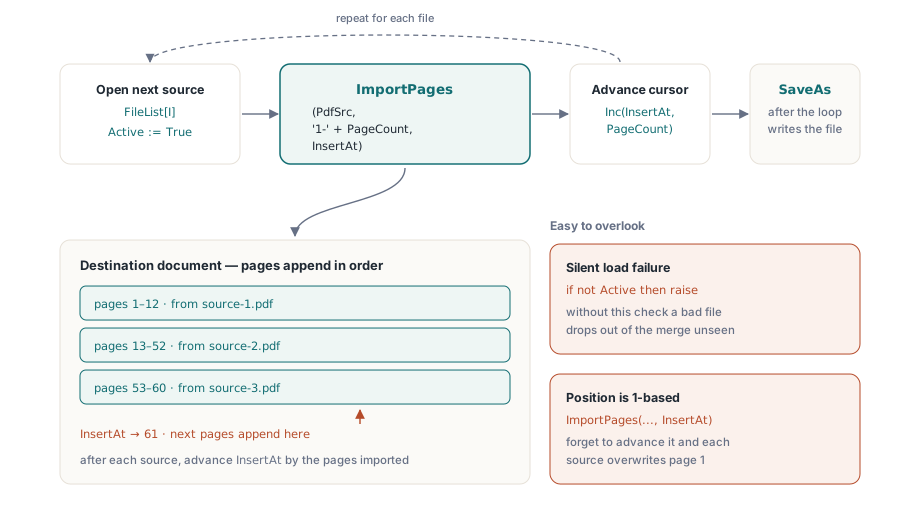
每次调用都把插入位置传 1 的合并循环,产出的文件页数正确、文档顺序却是反的。列表里最后一个文件落在第 1 页,因为位置 1 的意思是“插到当前第一页之前”,每个新来源都把先前的往后面挤。什么东西都没丢——这正是这个错误能逃过快速页数检查、直到有人真的去读那份合集才暴露的原因
用 ImportPages 逐页循环
PDFium Component 在 Delphi 里用两个 TPdf 实例构建合并 PDF:一个用 CreateDocument 建出的空目标文档,一个依次打开每个输入文件的来源。TPdf.ImportPages(Pdf, Range, PageNumber) 把 Range 点名的页面从 Pdf 复制进目标,成功返回 True。PageNumber 1 起算、默认 1,它指明第一批导入页面落位的目标位置,所以 1 是前插,PageCount + 1 是追加
让文件保持列表顺序的最省心做法,是干脆不维护游标,直接问目标文档它的结尾在哪。滚动一个 InsertAt 计数器也行,但它必须按实际导入的页数前进,而一旦范围字符串进场,这个数很容易算错。PdfDest.PageCount + 1 永远是对的:
procedure MergeFileList(const FileList: TStrings; const OutputPath: string);
var
  PdfDest, PdfSrc: TPdf;
  I: Integer;
begin
  PdfDest := TPdf.Create(nil);
  PdfSrc  := TPdf.Create(nil);
  try
    PdfDest.CreateDocument;
    for I := 0 to FileList.Count - 1 do
    begin
      PdfSrc.FileName := FileList[I];
      PdfSrc.Active   := True;            // 失败时不抛异常
      if not PdfSrc.Active then
        raise Exception.CreateFmt('Cannot open %s', [FileList[I]]);

      // 1 起算的位置:PageCount + 1 追加到最后一页之后
      if not PdfDest.ImportPages(PdfSrc,
        '1-' + IntToStr(PdfSrc.PageCount), PdfDest.PageCount + 1) then
        raise Exception.CreateFmt('Page import failed for %s', [FileList[I]]);

      PdfSrc.Active := False;             // FileName 只有在非激活状态才能改
    end;

    if not PdfDest.SaveAs(OutputPath) then
      raise Exception.Create('Cannot write ' + OutputPath);
  finally
    PdfSrc.Free;
    PdfDest.Free;
  end;
end;
那个循环里有两处检查真正有分量。设 Active := True 永不抛异常:文件缺失、损坏或需要密码时,TPdf 捕获加载错误、把 Active 留在 False。组件保持一致的关闭状态,窗体不会因坏文件崩溃。但跳过检查的合并循环只会安静地产出一份更短的输出。第二处检查是 ImportPages 的布尔结果,范围字符串解析不了或位置越过 PageCount + 1 时它返回 False。另注意 FileName 和 Password 只能在组件非激活时赋值,所以每轮结尾把来源关闭
范围字符串:解析器接受什么
范围参数是逗号分隔的单页和闭区间列表,按来源文档 1 起算编号。'1-3' 取前三页,'2,4,6' 取指定三页,'1,3-5' 取封面加一份三页摘要。数字永远指来源;这些页面落到目标哪里,只由位置参数决定
开区间是让人摔跤的地方。'7-' 这样的字符串看着像“第 7 页到末尾”,但 PDFium 范围解析器要求区间两端齐全,整个字符串都会被拒。反向区间('5-3')、页码 0、或超出来源页数的任何页码同样如此。一个坏条目让整次调用失败:ImportPages 返回 False,该字符串一页都不会被复制。这就是上面循环拼 '1-' + IntToStr(PdfSrc.PageCount) 而不是直接写 '1-' 的原因
手里已经握着页索引数组时,ImportPagesByIndex(Source, PageIndices, InsertAt) 免掉字符串这一步。但注意约定变了:那里索引和 InsertAt 都是 0 起算,所以追加是 InsertAt = PdfDest.PageCount,封面加摘要的选择变成 [0, 2, 3, 4]。传空数组导入所有页
有没有一次调用合并一串文件的办法?
有。TPdf.MergeFiles(Sources, Options, Report) 接受 TPdfBatchMergeSource 记录数组,每个用 TPdfBatchMergeSource.FromFile(FileName, PageRange, Password) 构造,逐个打开,并把发生的一切填进 TPdfBatchMergeReport。空的 PageRange 意味着所有页。范围语法是同样的逗号加区间格式,畸形范围变成报告里的一条逐文件错误,而不是悄悄跳过
改任何默认值之前值得先知道 TPdfBatchMergeOptions.Default 给了什么。CreateDestination 为 True,非激活的目标文档会替你创建。InsertAt 为 -1,意思是追加;其他任何值都是 0 起算索引,与 ImportPagesByIndex 一致而与 ImportPages 不一致。ErrorPolicy 为 bmepStop,RollbackOnCancelOrFailure 为 True,所以一个读不了的文件终止整轮并移除这轮已加入的所有页。CopyViewerPreferences 复制第一个成功导入来源的阅读器偏好
procedure BuildBundle(const OutputPath: string; Log: TStrings);
var
  Dest: TPdf;
  Sources: TPdfBatchMergeSources;
  Options: TPdfBatchMergeOptions;
  Report: TPdfBatchMergeReport;
  I: Integer;
begin
  SetLength(Sources, 3);
  Sources[0] := TPdfBatchMergeSource.FromFile('cover.pdf');
  Sources[1] := TPdfBatchMergeSource.FromFile('annual-report.pdf', '1,3-5');
  Sources[2] := TPdfBatchMergeSource.FromFile('appendix.pdf', '', 'user-password');

  Options := TPdfBatchMergeOptions.Default;
  Options.ErrorPolicy := bmepSkip;        // 遇到读不了的文件继续前进

  Dest := TPdf.Create(nil);               // 非激活:MergeFiles 会创建它
  try
    if not Dest.MergeFiles(Sources, Options, Report) then
      raise Exception.Create('Merge failed: ' + Report.ErrorMessage);

    for I := 0 to High(Report.Issues) do
      Log.Add(Format('%s: %s',
        [Report.Issues[I].FileName, Report.Issues[I].MessageText]));
    Log.Add(Format('%d pages from %d of %d files',
      [Report.ImportedPageCount, Report.ImportedSourceCount, Report.SourceCount]));

    Dest.SaveAs(OutputPath);
  finally
    Dest.Free;
  end;
end;
用哪种错误策略取决于缺一份文件对输出意味着什么。合同包或发票批次里少一份就是错的文档:保留默认的 bmepStop 加回滚。只有尽力而为的集合才换 bmepSkip,比如每周报告摘要,而且要把 Report.Status 里的 bmrsCompletedWithErrors 当作必须有人过目的信号。无论选哪个,都要读 Report.Issues:每个条目带来源序号、文件名和消息,直接回答“罪魁是哪个文件”——手写循环得靠自己的异常来回答这个问题
长跑作业还有两个选项要紧。OnProgress 和 CancellationToken 让 UI 显示当前文件并叫停整轮,取消的一轮像失败的一轮一样回滚。ResourcePolicy 默认 bmrpSourceScoped,把每个来源选中的页面用一次原生调用导入,这些页面共享的字体和图像只复制一次。bmrpChunked 按 PageChunkSize 页分批导入,取消点更细,代价是共享资源每批都重拷一遍
导入的页面带走什么,什么留在来源里
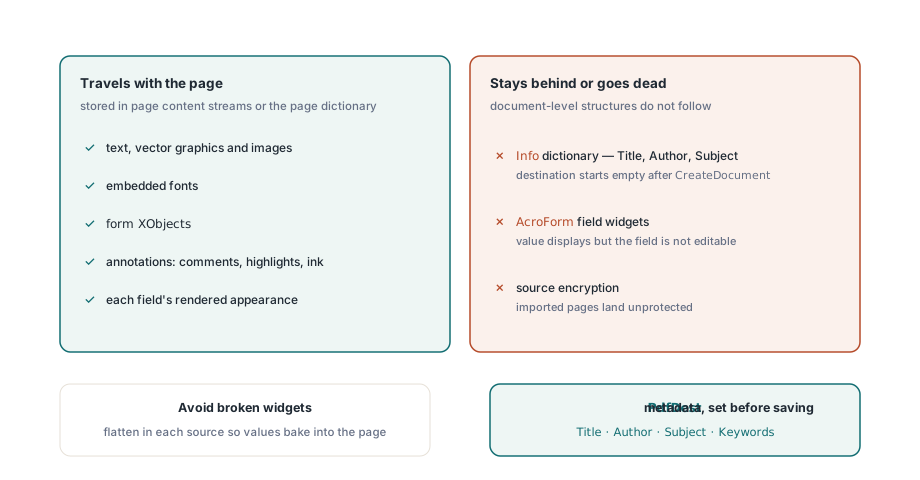
导入的页面带走从它的页面字典可达的一切:内容流、资源里的字体、图像和表单 XObject,以及它的注释,包括批注、高亮和墨迹。住在来源文档层面的东西不会跟来,因为 ISO 32000-1 把它们放在页面树之外
- 文档信息字典(ISO 32000-1 §14.3.3)留在原地,所以合并文件没有各来源的 Title、Author 或 Keywords。
TPdf上的Title和Author属性是只读的,正好用来在关闭每个来源前记录它声明了什么 - 书签(§12.3.3)在默认
OutlinePolicy为bmopDiscard时被丢弃;bmopReject则把带书签的来源变成一条逐文件错误。要保留书签,FPdfMerge单元提供了MergeFilesWithNavigation:重建书签树、默认用Imported_前缀给撞名的命名目的地改名、并重映射页面之间的链接;书签编辑与页面重映射一文讲了这些目的地如何改写 - 加密(§7.6)属于来源文件。受保护的来源用它的
Password打开,但CreateDocument建出的目标不加密,复制进去的页面也不加密。如果合并文件必须受保护,用SaveAsEncrypted而不是SaveAs写出
为什么表单字段合并后就不好使了?
表单字段横跨 PDF 的两个层级。画出文本框的 widget 注释在页面上,而字段本身连同它的名字和值,列在目录交互式表单字典的 /Fields 数组里(ISO 32000-1 §12.7.2)。原生页面导入把 widget 连同其他页面注释一起复制,却没有任何东西把它加进目标的字段树。文本框仍然画出它最后一次的外观。可是从 /AcroForm 构建表单模型的阅读器没有字段可挂这个 widget,值改不了,任何遍历字段树的表单操作都跳过它
对普通合并,TPdfBatchMergeOptions.FormPolicy 给出三种答案。bmfpPreserveNative(默认)保持上述原生导入结果。bmfpFlatten 在导入前于内存中生成外观并把每个带表单来源的选中页拍平,值变成普通页面内容;磁盘上的源文件不被修改。bmfpReject 把任何带 AcroForm 或 XFA 表单的来源变成逐文件错误
字段必须保持可填写时,用 FPdfFormMerge 单元的 MergeFilesWithForms。它导入页面内容、从每个来源的字段树重建 widget、并把字段嫁接进目标表单。字段名是难点。按 §12.7.3.2,两个完全限定名相同的字段就是同一个字段、共享一个值,所以发票里的 Total 和送货单里的 Total 会互相覆盖。默认 CollisionPolicy 是 pagcpReject,第一次撞名就叫停合并:
uses
  PDFium, FPdfCompress, FPdfFormMerge;

procedure MergeFillableForms(Dest: TPdf;
  const Sources: TPdfBatchMergeSources; Log: TStrings);
var
  Options: TPdfFormMergeOptions;
  Report: TPdfFormMergeReport;
begin
  Options := TPdfFormMergeOptions.Default;
  // 撞名的字段获得 RenamePrefix(不改就是 'Imported_')
  Options.GraftOptions.CollisionPolicy := pagcpRename;

  if Dest.MergeFilesWithForms(Sources, Options, Report) then
    Log.Add(Format('%d fields grafted, %d renamed',
      [Report.GraftedFieldCount, Report.RenamedFieldCount]))
  else
    Log.Add('Form merge failed: ' + Report.ErrorMessage);
end;
pagcpNamespace 改为把每个来源的字段放进自己的前缀下(Imported 加来源序号);pagcpMergeCompatible 只在类型与选项一致时合并同名字段。MergeFilesWithForms 作用于 AcroForm 来源和没有签名字段的目标。它断然拒绝 XFA 表单和已签名文件,因为改写已签名文件会使 ISO 32000-1 §12.8.1 描述的签名字节区间失效。打开着的目标还必须未加密:合并进受密码保护的文件会失败,事后再用 SaveAsEncrypted 加保护。一个来源里同一页被选两次(如 '1,1')需要显式的 RepeatedPagePolicy
目标文档只有在暂存结果被重新打开并检查之后才被替换。字段名、值和类型逐页比对,失败的表单合并让 Dest 保持原样。AcroForm 嫁接一文更深入地讲撞名处理
保存合并后的文档
SaveAs 有文件重载和 TStream 重载,都接受可选的 TSaveOption(默认 saNone)和 TPdfVersion(默认 pvUnknown,头部留给库定)。两者都返回布尔值,批处理作业里这个返回值值得与 Active 同等对待。只在下游系统坚持特定头部时才用 pv17 之类钉住版本
反方向的活儿——把一份文件切成几份——用同样的范围字符串、同样的 1 起算位置;拆分一文从头走了一遍
ImportPages、MergeFiles 和这里的表单感知合并随 PDFium Component 交付,把这些页面操作带给 Delphi 与 C++Builder 应用