对象号 1 不是第 1 页。仅这一件事就绊倒了比格式其他任何部分都多的 PDF 处理代码,而原因只有在你不再盯着阅读器渲染出什么、开始看阅读器实际读取的对象图时才会浮现
PDF 文件是一堆带编号的间接对象。每个对象带着对象号和代号(generation),其他对象用写作 N G R 的引用指向它——3 0 R 表示对象 3 的当前版本。页面和其他对象一样也是对象,但它在文件里的位置、它携带的编号,对显示顺序只字未提。顺序来自 /Pages 树。按编号顺序扫描对象,你在相当一部分真实文件上都会把页面拼错序
树还是许多不那么显眼的行为的栖身之处。它的形状决定阅读器跳到第 8,214 页有多快,它的内部节点悄悄把页面尺寸和字体下传给下面的叶子,而让整个结构跑得飞快的 /Count 总数却没有任何机制强制。这三件事我们都会讲,从顺序本身开始
页面树决定顺序
每份 PDF 都有一个文档目录(ISO 32000-2 §7.7.2),目录的 /Pages 条目指向页面树的根节点。根是一个带 /Type /Pages 的字典,有一个 /Kids 间接引用数组和一个给出其下叶子页数的 /Count。显示顺序就是对这棵树深度优先、从左到右的遍历。规则全部如此
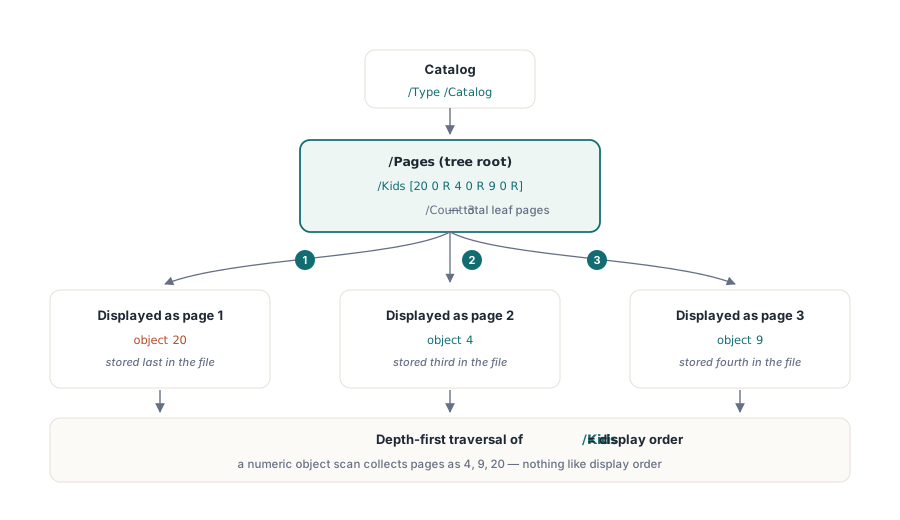
一个最小的三页文件把事情说清楚:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% 对象 4 在文件里排第三存储,显示顺序上却是第 2 页
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% 对象 9 排第四存储,却是第 3 页
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% 对象 20 最后存储却是第 1 页;起决定作用的是 Kids[0],不是对象号
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
/Kids 数组读作 [20 0 R 4 0 R 9 0 R],所以对象 20 是第 1 页,对象 4 是第 2 页,对象 9 是第 3 页。按数字顺序迭代对象、把带 /Type /Page 的都收进来的代码会把这个文件搞错。更糟的是输出看起来仍然像样:页数对,每页内容能认出来,就是顺序不对
生成器产出这种布局都有平凡的理由。预先给所有页面保留对象号的库按创建顺序编号,然后按序列化器顺手的顺序写字节。合并工具为了避免冲突给每个源文档的对象重新编号,页面对象于是散落在合并后对象表的各处,而新的根 /Kids 数组握着正确顺序。增量更新把新对象追加到文件尾部、发新号,于是一次修订中加入的页面住在字节流末尾附近,哪怕它逻辑上属于第 1 页
最后这种情况最咬人。单一工具产出的测试语料可以全数通过,然后合并流程出的文件、或经过几次修订的文档就开始乱序。启发式修复守不住,因为失败取决于生成器和文件的编辑历史。真正的修复很短:从目录出发,解析 /Pages,递归走 /Kids,按遇到的顺序输出叶子。我们的页面顺序调试案例正是沿着这个症状从一次误诊走到根因,附递归遍历代码和检查结果的 qpdf 步骤
分支因子是性能决策
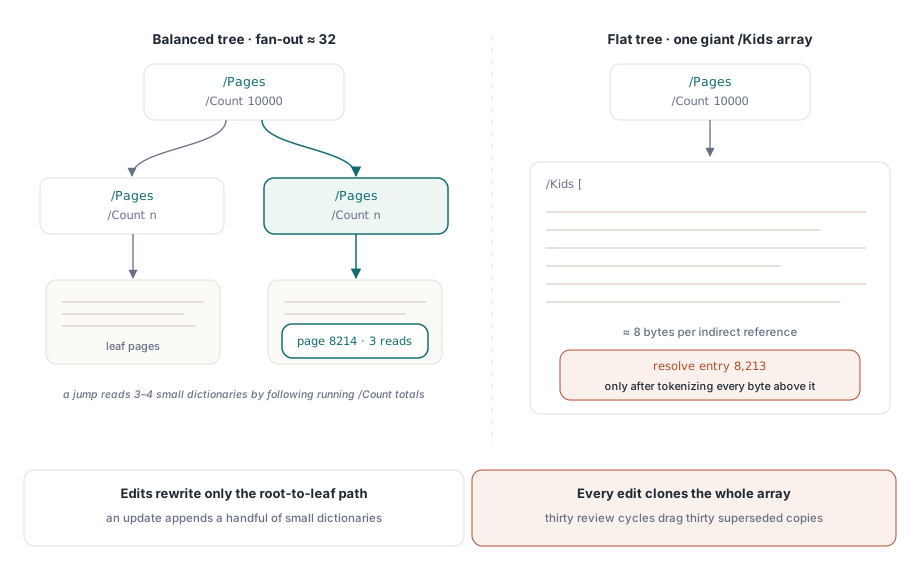
规范允许两种形状。朴素的生成器输出扁平树:一个根 /Pages 节点,/Kids 里除了 /Page 叶子什么都没有。没有任何力量强制嵌套,一份 10,000 页、单数组里塞 10,000 个叶子引用的文档完全合规。不过 PDF Reference 建议大文档用平衡树,主流生成器也听从这个建议,取适中的分支因子——通常每个中间节点几十个 kid,每个中间节点有自己的 /Kids 和自己的 /Count
原因在于阅读器在能显示任何东西之前必须读什么。考虑在那份 10,000 页的文件里直接跳到第 8,214 页。扁平树下阅读器得先解析根,而根是一个巨大数组:按每个间接引用约 8 字节算,那是一个 80 KB 的对象,必须从头到尾完成分词,第 8,213 项才解析得出来。分支因子 32 的平衡树下,同一跳读根节点、用累进的 /Count 总数比较选出正确的孩子、然后下降。三四个小字典,每个几百字节。这种 O(log n) 随机访问正是这棵树的设计目标,也是 /Count 存在于中间节点上的全部理由——读的人可以整棵子树跳过,不必打开里面任何一个对象
树的形状还决定编辑的成本。插入一页的增量更新必须重写所有 /Kids 或 /Count 变了的节点,也就是从新叶子的父节点到根的这条路径。平衡树下这条路径是追加到文件里的几个小字典;扁平树下这条“路径”就是那个巨大的根数组,每次修订全量复制一份。一份经历三十轮审阅批注的合同,字节流里最后可能拖着三十份被顶替的同一 80 KB 数组
对处理代码而言,嵌套有个更直接的后果:你不能假设第一层 /Kids 里就是页面,每个孩子都得检查——/Type /Pages 意味着递归,/Type /Page 意味着叶子。停在第一层的代码在遇到的每个扁平文件上都工作正常,直到某个生成器第一次决定嵌套,它就无声地丢掉整棵子树
内部节点携带可继承属性
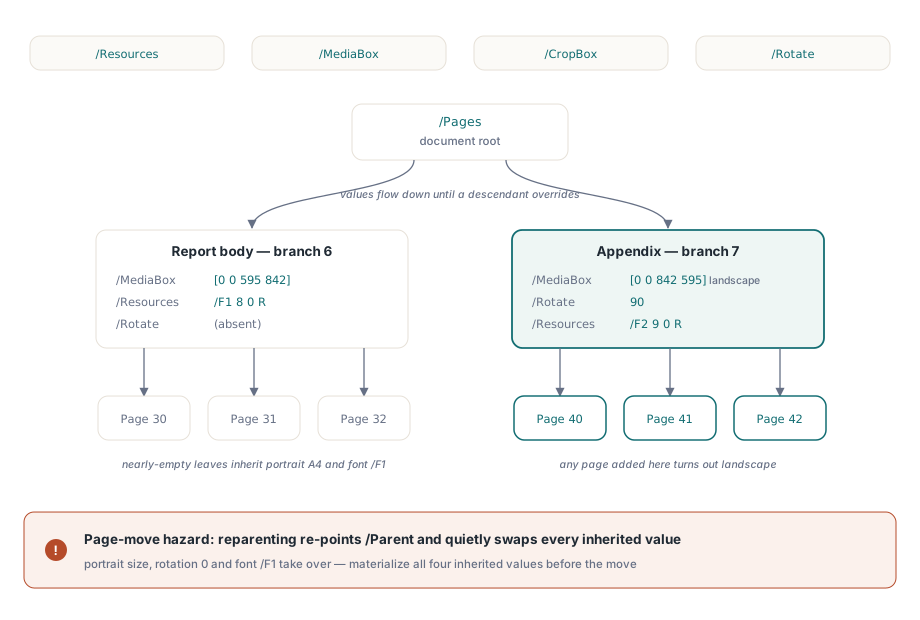
中间节点不只是给查找带路。四个页面属性可继承(ISO 32000-2 §7.7.3.4):/Resources、/MediaBox、/CropBox 和 /Rotate。它们任何一个都可以放在 /Pages 节点上,作用于其下每一片叶子,除非后代覆盖。要产出带横向附录的报告,写入器可以直接在树里表达这种布局:
5 0 obj   % 文档根
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % 报告正文:纵向 A4,正文字体
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % 附录:横向 A4,带旋转,自己的字体
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % 附录页:继承尺寸、旋转和字体
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
对象 40 到 42 几乎是空的。页面尺寸、旋转和字体资源全部来自节点 7,这让文件保持紧凑且自我维护:在附录节点下加第四页,它自动就是横向的,谁都不用碰
这也意味着页面的属性不全在页面上。对象 40 没有 /MediaBox 键,而这完全合法——把缺失键当成畸形输入的阅读器会拒掉有效文件。查找必须沿 /Parent 链上溯,直到找到条目或抵达根。这趟上溯需要环防护。损坏的文件可能带着指回已访问节点的 /Parent 引用,没有已访问对象集合,查找就会永远打转
同一机制造就了经典的页面搬移隐患。假设某个工具把对象 40 挪进报告正文:改两条 /Kids 数组、把 /Parent 改指节点 6。搬移在结构上成立,但对象 40 从此继承纵向 /MediaBox、无旋转和字体 /F1——而它的内容流仍在选 /F2,已经解析不到。一次编辑,页面缩小、转正、文字消失。靠得住的重排代码会在重新挂父之前,把全部四个可继承属性的已解析值写到页面字典上。如果你曾在编辑器里拖动一页、看着它变尺寸或变方向,你看到的就是这个机制
扁平化:合法、常见、偶尔代价高昂
不少工具反其道而行。极简写入器输出单层树,图的是简单;很多合并拆分工具把读到的树一律重建成一个扁平 /Kids 数组,因为平衡输出是额外工作而扁平输出永远合规。正确的重建必须同时解析继承。叶子原本继承的每个属性都得复制到叶子上,若全文档统一也可升到新根;漏掉这一步,输出就会像页面搬移案例那样改变几何
对典型文档,扁平化无害。它在大规模时疼,疼法就是前文说过的两种:根数组变成一个所有打开和每次跳页都要完整解析的大对象,每次结构编辑都要整体重写它。扁平化没有摧毁的是经由间接引用的共享。一棵 10,000 页全指向同一个 /Resources 字典对象的扁平树依然是去重的——丢掉的只是“把条目从页面上省略、让祖先供给”这个选项
/Count 撒谎的时候
/Count 是纯记账。它必须等于节点子树里的叶子页数,而文件格式没有任何东西强制这一点。野外见到的说谎计数,大多数能归到两种损坏模式
第一种是增量更新留下的过期计数。编辑器插入一页,用新的 /Kids 和更新过的 /Count 重写直接父节点,把两者追加进文件——然后再也不碰祖先:
% 原始修订
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% 追加的修订:一页插入中间分支。
% 对象 14 被顶替;对象 12 从未重写
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
树里现在有十片叶子,根还说九。信根的阅读器页码器显示九。用内部计数做二分跳页的计算,插入点之后每页的索引都算错。完整遍历找到十。一份文件,三种答案
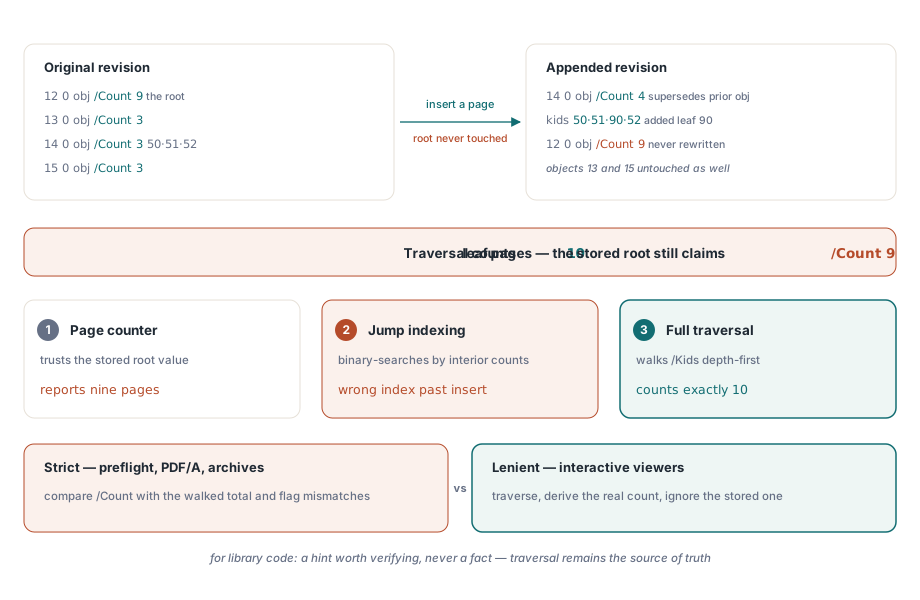
同一份文件还有一种更安静的咬人方式。读根计数、开始走树、收满那么多页就停的代码,永远见不到第十页。没有异常,没有警告,只有一份少一页的文档。把 /Count 当循环边界或边界检查才是错误所在;遍历必须跑到树枯竭为止,不管存储的数字说什么
第二种模式是从头就不可能对的计数:负数、有内容的节点上为零、或大得离谱。它们来自模糊测试、传输损坏,偶尔来自编辑器里的算术 bug。它们的危险恰恰针对信 /Count 做分配的代码。按 -3 的 /Count 定数组尺寸,最好情况是抛个范围错误;按二十亿的 /Count 分配就是一次拒绝服务。把这个值当不可信输入对待,跟文件里其他所有数字一样
解析器在这些问题上分成两营。严格消费方——预检工具、PDF/A 校验器、归档流水线——拿 /Count 对遍历结果做比对,拒绝或标记文件。交互式阅读器几乎一律宽松:它们自己遍历、推出真实计数、悄悄无视存储值,这正是过期计数文件能无诉无怨流传多年、直到在某条自动化流程里撞上更严格解析器的原因。对库代码,我们认为中间道路是正确默认:把 /Count 当预分配提示,验证过后再用于子树跳过,让遍历始终是事实来源
在生产环境,这些失败很少以树问题的面目自我通报。它们表现为页面乱序、合并末尾少一页、或重排后某页变了尺寸或方向。调试案例把这样一份报告沿树追到了根。想了解周围的文件解剖(对象、交叉引用数据、trailer),从PDF 文件结构总览入手最合适
HotPDF Delphi Component 在内部处理这一切:它遍历任意深度的嵌套树,在复制或移动页面时解析可继承属性,并拿 /Count 与实际叶子数核对而不是轻信它,所以其 API 里的页面索引永远指逻辑页