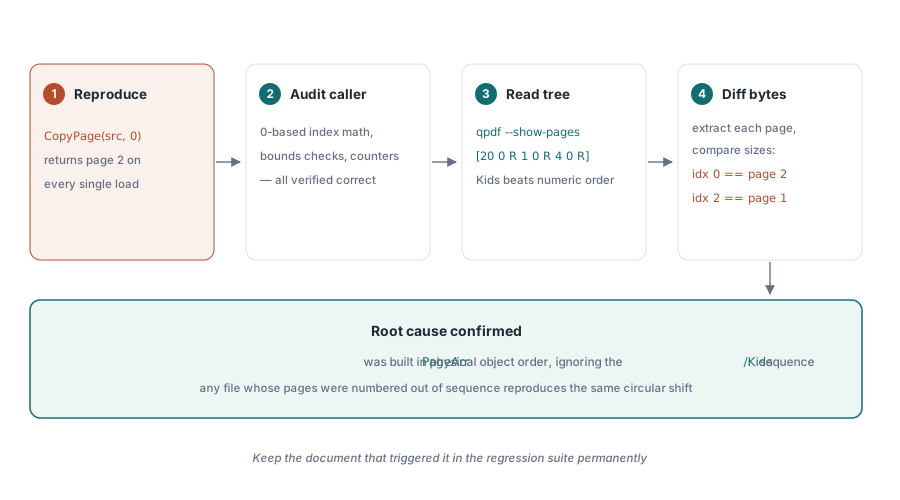
经典症状长得像差一错误:页面复制例程向一份三页文档要第 1 页,却次次都拿到第 2 页。索引逻辑挑不出毛病:调用用的是从 0 开始的逻辑索引,算术正确,边界条件也没问题。可吐出来的页面回回都错
原因根本不在复制代码里,而在加载器如何搭建页面数组——这是 PDF 解析里最容易踩的陷阱之一
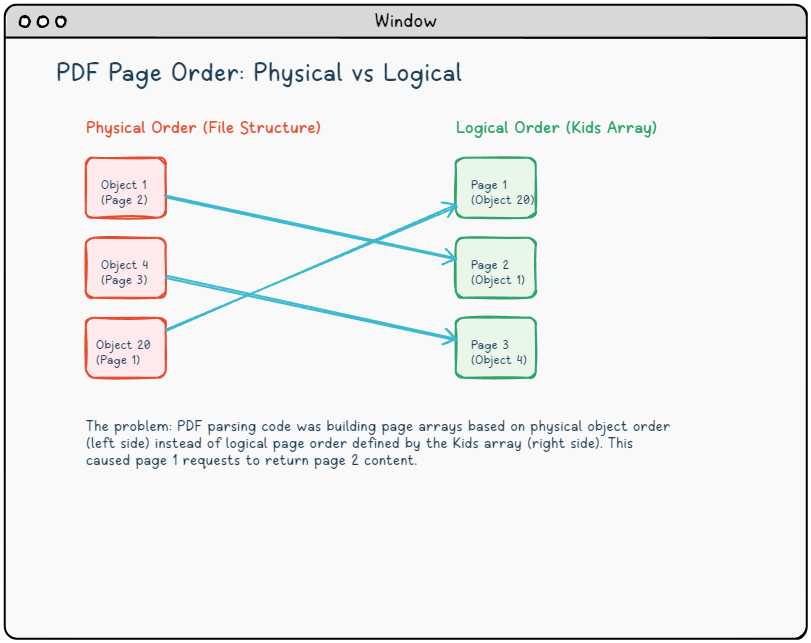
两套顺序,一个混乱之源
PDF 文件说白了就是一堆间接对象(indirect objects)的集贸市场,每个摊位(对象)头上都顶着个对象号。可这文件的物理结构压根没打算让这些号码去凑什么阅读顺序的热闹。对象 1 完全可以大摇大摆地装着第 2 页的内容;对象 20 里头也能坦然地躺着第 1 页。真正拍板定下阅读顺序的,是那棵页面树(page tree):那是一个由 /Pages 字典搭起来的层级结构,里头的 /Kids 数组白纸黑字地排好了页面引用的座次,阅读器就是得照着这个单子按顺序翻页(ISO 32000-1 规范第 7.7.3 节)
下面这份页面树正好把这个陷阱暴露出来:
{ 页面树根节点,对象 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logical page 1 }
         1 0 R    { logical page 2 }
         4 0 R]   { logical page 3 }
>>
endobj
好巧不巧,这文件在字节流里,硬是把对象 1 和对象 4 排在了对象 20 的前头。随便换哪个解析器来,要是它只知道蒙着头顺着文件里的物理顺序挨个去翻这些间接对象,只要摸到一个页面类型的字典就往它的 PageArr 数组里盖个戳,那最后数组的坑位绝对是这么排的:对象 1 占着索引 0,对象 4 霸着索引 1,对象 20 被挤到了索引 2。逻辑上的第 1 页,就这么被塞进了 PageArr[2] 里。这时候你跑去要索引 0 的页面,它当然只能把逻辑上的第 2 页给你扔回来
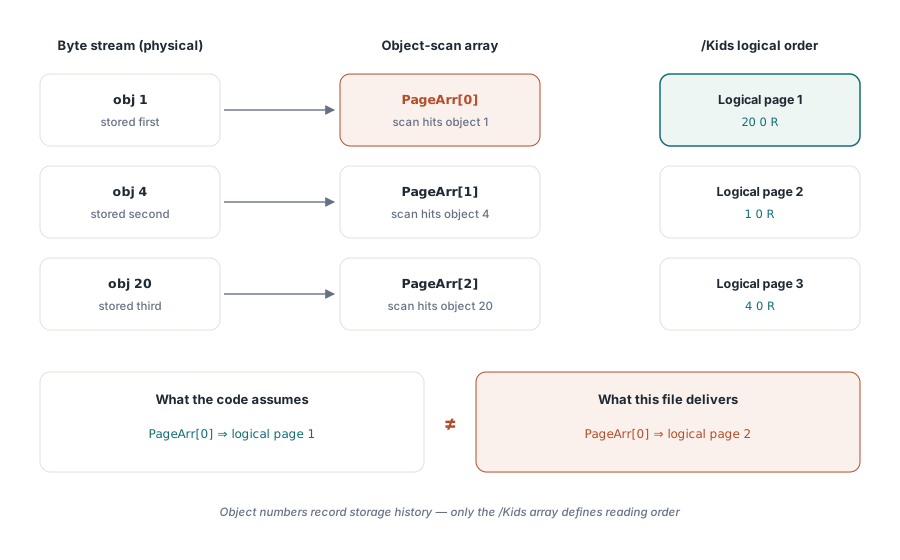
验证猜想
动手改代码之前,先证实错位,而不是假设它。qpdf 命令行工具让这件事非常直接:
{ shell }
qpdf --show-pages input.pdf
{ 输出显示 Kids 顺序:20 0 R,然后 1 0 R,再然后 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ 显示按阅读顺序排列 /Kids 的 Pages 字典 }
把每一页单独导出再比对文件大小,映射关系就得到了确认:对象扫描出来的 PageArr[0] 吐出的内容其实属于逻辑第 2 页,而 PageArr[2] 装的才是逻辑第 1 页。这个循环移位就是铁证。它也解释了为什么这个症状在许多不同的源文档上反复出现:只要哪份 PDF 的页面对象碰巧拿到比某个更早的逻辑页面更小的对象号,就会触发
PDF 会被搞成这个状态,原因其实很直白。增量更新保留它所改对象的对象号,但它新增的东西——比如插到文件开头的封面页——会拿到一个比文件里已有一切都大的新号码,而它的引用却插到 Kids 数组开头。合并或重组文档的工具按自己顺手的次序重排对象号;有些生成器写页面时只图内容流输出方便,并不照逻辑页序来。PDF 格式对它们没有任何一条强制要求
正确的做法:跟着 Kids 数组走
搭页面清单要沿着从 catalog 根出发的 /Kids 链走,而不是去扫间接对象。这个遍历必须递归,因为大文档通常把页面拆在中间 /Pages 节点上;它还应当防着畸形树指回自己某个祖先的情况。在下面的示意代码里,TPdfDict 和 TPdfArray 代表你的解析器所用的字典和数组类型:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // 环,或者病态深的树
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // 跟随间接引用
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // 中间节点
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // 叶子:显示顺序里的下一页
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// 用法:从 catalog 的 /Pages 条目开始
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
两处细节是刻意的。没有 /Type 条目的叶子仍然当作页面处理,因为有些写入器会省掉它,而阅读器照样打开那些文件。最后那次 /Count 对比分文不花,却能在调用者拿索引去访问之前,抓住被截断或被手工改过的树
如果你用 HotPDF 加载文档,这件事在文档加载时就已解决:页面索引跟随页面树的显示顺序,包括嵌套的 /Pages 节点,所以索引 0 永远是阅读器显示的第一页。上面的遍历在你自己的代码直接解析 PDF 结构时才需要操心
用 CopyPageFromDocument 按逻辑索引复制
因为 HotPDF 在加载时就解析好了页序,逻辑页索引与调用者的预期一致。更高层的 CopyPageFromDocument 接受一个从 0 开始的逻辑索引,把正确的页面复制进目标文档:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { 复制逻辑页 0(用户看到的第一页) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;由于索引是显示顺序索引,即使面对物理顺序与逻辑顺序分道扬镳的文档,CopyPageFromDocument 也能正确行事。批量操作时,InsertPagesFromDocument 接受一个逻辑索引数组,一趟全部复制
这对 PDF 解析意味着什么
PDF 规范写得明确:逻辑页序由页面树的 /Kids 数组定义,而不是对象号或字节偏移(ISO 32000-1 §7.7.3.2)。任何拿别的顺序当捷径的解析器,在它见到的大多数文档上都会碰巧给出正确结果,因为多数生成器按自然顺序写页面、发连续的对象号。这个错误一直潜伏,直到有人加载一份被增量编辑过、被别的工具重组过、或由选了不同布局的软件生成的 PDF
只拿自己生成的 PDF 测试,这类问题完全测不出来。页面顺序处理需要一份来自不同来源的文档测试库:增量保存的文件、塞了插入封面页的扫描件、由线性化或以别的方式优化对象图的工具产出的 PDF。任何一份物理顺序与逻辑顺序分岔的文档,都值得在这个测试库里占一个永久席位
HotPDF Delphi Component 页面列有页面操作的全部 API,包括 CopyPageFromDocument、InsertPagesFromDocument 和 MovePage