文档入库流水线会接收来自陌生来源的文件 发票、扫描件、网页表单附件都声称自己是 PDF 并携带数百个数值供解析器执行 这些值都是文件生成方写下的,包括流长度、图像参数、字节偏移、对象引用,上传被截断或恶意构造都会使某个数字落在危险点上 耗子型异常出现的区别在于是否用了通用的防御性习惯 这些习惯不依赖于某个 PDF 库的特性也不会随着组件切换而失效
这些实践都从一个前提开始 任何从文件读取到的值都只是声明,只有和解析器自身测得的事实对齐后才变成可执行值 流长度必须和真实字节数一致,解码结果长度必须与缓冲分配匹配,偏移和递归深度必须在文件规模内才能安全继续
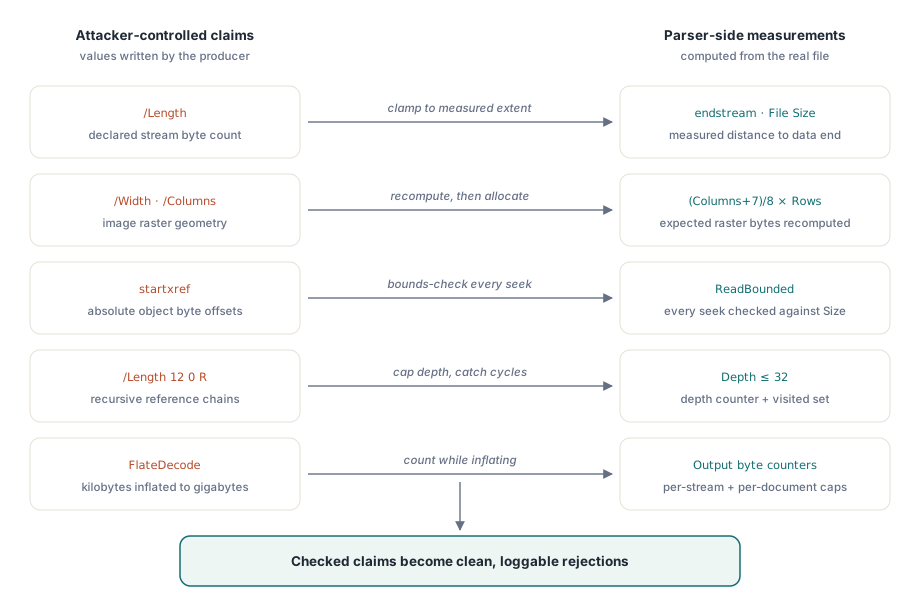
声明长度只是一个声明,不是测量结果
最常见不一致发生在流长度,PDF 对象在字典里声明 /Length,真实字节区间在 stream 与 endstream 之间 这两个值不保证一致 截断文件通常声明长度更大,破损文件可能声明长度越过文件尾 直接按声明分配内存并拷贝到 endstream 可能越界 按声明直接读取也可能在文件尾后面读取到空数据导致边界错误 声明值应先用实际数据长度进行钳位后再用于分配 与其“修复”不如显式拒绝 例如扫描 endstream 标记或直接报错退出
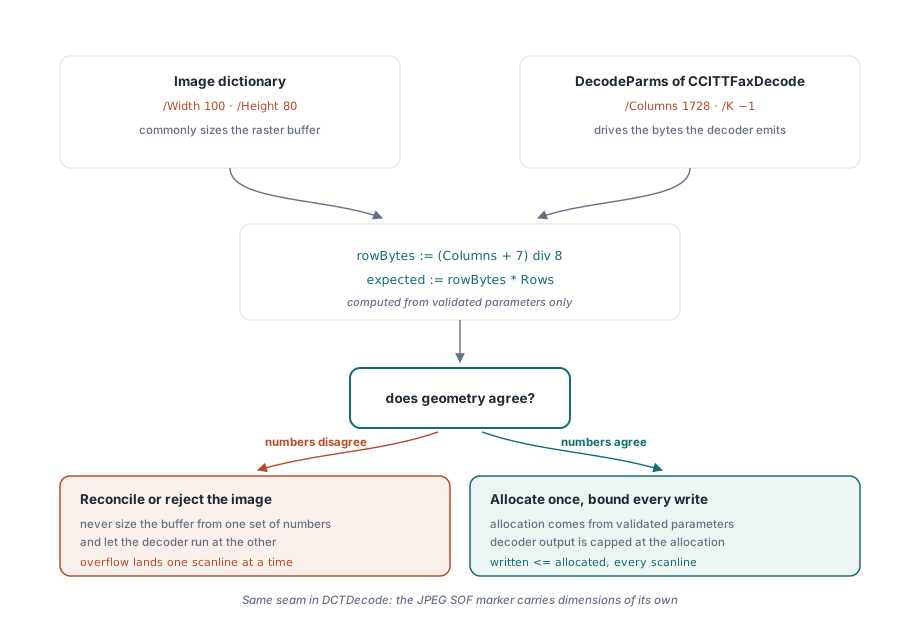
图片参数可能描述出比你分配的更大栅格
图像流会同时携带两组几何参数 词典里的 /Width 和 /Height 描述目标位图,解码过滤器也有自己的尺寸。CCITTFaxDecode 依赖 DecodeParms 里的 /Columns、/Rows 和 /K,其中 /K 决定 Group 3 或 Group 4 模式,并按每行 (Columns + 7) div 8 字节输出 如果文件声明 /Width 100 而实际给了默认 /Columns 1728,解码输出会比目标缓冲大十几倍以上,越界写发生在每一行 也会出现 /Rows 缺失时按数据长度持续写入的情况 不能只按词典几何分配 也不能在解码过程中不校验输出结果
防御规则是先用已验证的解码参数计算期望输出,再与上限做比较 再用该结果分配缓冲,解码中持续核对是否越界 词典尺寸与过滤器参数冲突时,要么协商一致要么拒绝解析,这是唯一不越界的做法
Delphi 算术与分配陷阱
三类 Delphi 行为会让“明明做了校验”的代码失效 第一是 32 位乘法求值,即使中间结果赋给更宽类型,两个 Integer 相乘也可能先在 32 位溢出 30000×30000×3 理论上是 2.7 亿字节 在有些场景会溢成负值或很小的正数,导致 SetLength 分配不足。正确方式是从第一个乘数就转成 64 位,再和上限比较后才进入 SetLength
第二是范围检查。Delphi 默认发布配置常关闭,文件来源的越界下标不会触发异常而是写入相邻内存,风险常被掩盖。把每个以文件数据驱动索引的单元置顶,打开 {$R+},并在算术有可能溢出处同时打开 {$Q+},可以把静默污染变成可捕获异常
第三是 TMemoryStream.SetSize 与长整型在不同 RTL 版本中的不一致,超大长度在旧 RTL 上可能静默缩窄。当前 RTL 可能直接抛出分配异常,新旧行为一致都不是“安全”的默认值;旧 RTL 把 $100000010 转成 16 后成功分配,真实写入却越界。每次分配都必须先验算来源长度和硬上限
偏移可能指向文件外
xref 表提供对象号到绝对字节偏移的映射,损坏或恶意文件会把偏移指向文件外或无关结构 TStream 在偏移到文件尾后不报错 直接读取常返回短读并让后续逻辑接着消费旧数据。把每次定位与读取都置于统一函数中检查偏移和长度是最有效的防线
uses
  System.SysUtils, System.Classes;

const
  MAX_OBJECT_BYTES = 64 * 1024 * 1024; // 单个对象不得超过 64 MB

type
  EPdfBoundsError = class(Exception);

// 所有由文件驱动的定位与读取都从这里经过。Offset 和 Count
// 是文件提供的声明;Source.Size 是它们必须符合的测量值。
procedure ReadBounded(Source: TStream; Offset, Count: Int64;
  var Buffer: TBytes);
begin
  if (Offset < 0) or (Count < 0) or (Count > MAX_OBJECT_BYTES) or
     (Offset > Source.Size) or (Count > Source.Size - Offset) then
    raise EPdfBoundsError.CreateFmt(
      'object extent %d+%d exceeds file size %d',
      [Offset, Count, Source.Size]);
  SetLength(Buffer, Count);
  if Count = 0 then
    Exit;
  Source.Position := Offset;
  Source.ReadBuffer(Buffer[0], Count);
end;
跨文件偏移、流区间和嵌入文件读取都应经过统一闸口,越界时统一返回结构化错误 把错误放在文件驱动接口边界上,异常信息包含原始偏移和长度,能让运营系统快速追溯问题
对象图中的循环与深度
PDF 是图结构 而不是树结构 间接引用和间接引用嵌套都可能形成循环 /Length 12 0 R 指向 13 0 R 再指回前者就能形成环。递归解析若只靠自然栈深度控制,循环会把调用栈耗尽而触发进程退出 要求两个约束并存 一是深度上限 够用即可不影响正常文档 二是访问集合检测二次访问并立即中断 这样可以把循环报成结构错误而不是运行时栈溢出
两个防线应同时启用:一是显式深度上限,覆盖合法但非常深的引用链;二是访问集合,重复访问同一对象即判为循环并抛出结构化错误。这样不会把正常文档误判为攻击,也不会把攻击留给本机调用栈处理
uses
  System.SysUtils, System.Generics.Collections;

const
  MAX_RESOLVE_DEPTH = 32; // 比任何合法的引用链都深得多

type
  EPdfStructureError = class(Exception);

  TPdfValueKind = (pvNull, pvNumber, pvName, pvString, pvArray,
    pvDictionary, pvStream, pvReference);

  TPdfValue = record
    Kind: TPdfValueKind;
    RefNumber: Integer; // 当 Kind = pvReference 时有意义
    // ...其余类型的负载字段
  end;

// LoadObject 是你自己的例程:它查找 ObjNumber 的
// xref 偏移,用 ReadBounded 读取该对象,然后解析它。
function ResolveObject(ObjNumber, Depth: Integer;
  Visited: TDictionary<Integer, Boolean>): TPdfValue;
begin
  if Depth > MAX_RESOLVE_DEPTH then
    raise EPdfStructureError.Create('reference chain exceeds depth limit');
  if Visited.ContainsKey(ObjNumber) then
    raise EPdfStructureError.CreateFmt(
      'circular reference through object %d', [ObjNumber]);
  Visited.Add(ObjNumber, True);
  try
    Result := LoadObject(ObjNumber);
    if Result.Kind = pvReference then // 例如 /Length 12 0 R
      Result := ResolveObject(Result.RefNumber, Depth + 1, Visited);
  finally
    Visited.Remove(ObjNumber); // 兄弟对象可能合法地共享此对象
  end;
end;
解压缩是放大器
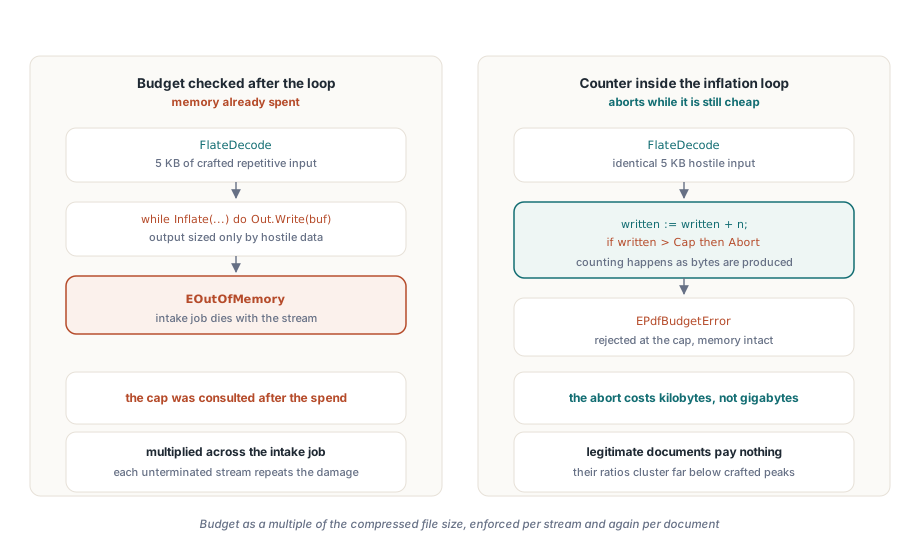
几 KB 的压缩输入可能解压到上百 MB FlateDecode 重复性文本越高,压缩越好,解压器越容易被放大 如果不约束每个对象输出大小和全文件累计输出,内存会被轻易耗尽 约束应放在输出循环内部 按块统计累计输出并即时中断 一旦任何对象超额立即结束本次解压 同时把全文累计预算设为原始压缩体积的若干倍能防住“多对象小对象拼接”这类误判
在模块边界之外做防御层
同样的缺陷也会在上层库里出现 本文两篇案例展示了相关修复方向:PDFium 本地 Pascal 引擎曾出现整数溢出、递归膨胀和未初始化缓冲,Hardening a Pascal PDF Parser Against Malicious Files 有完整讨论;绑定 PDFium C 引擎时也会遇到约定调用方式、整数宽度和生命周期问题,Hardening a PDFium Component Binding 给出可直接复用的策略。针对公开上传、未认证邮箱或第三方提交入口,建议把解析与解码移到单独低权限进程,这样越权越界攻击最多导致作业失败而不是服务整体下线
预检清单
发布前把这条清单跑一遍 流缓冲从“声明长度”改为“声明与实际最小值”每条流都如此 分配前校验 CCITT 与 DCT 实际解码尺寸 每一个尺寸乘积用 Int64 计算并与上限比较 开启 {$R+} 和 {$Q+} 并覆盖所有文件驱动索引 统一的寻址读取函数做边界保护 递归解析加上深度上限和访问集合 防御性解析循环中解压输出也要按对象预算和文档预算同时计量 这些检查在合法文档上可忽略不计 但它们能把内存破坏转成可审计拒绝而不是未定义行为
Note: the losLab HotPDF Delphi Component, PDF Library for Delphi Delphi PDF Library, and PDFium Component apply these bounds checks, depth limits, and expansion caps internally, so an intake pipeline built on them starts from a hardened baseline