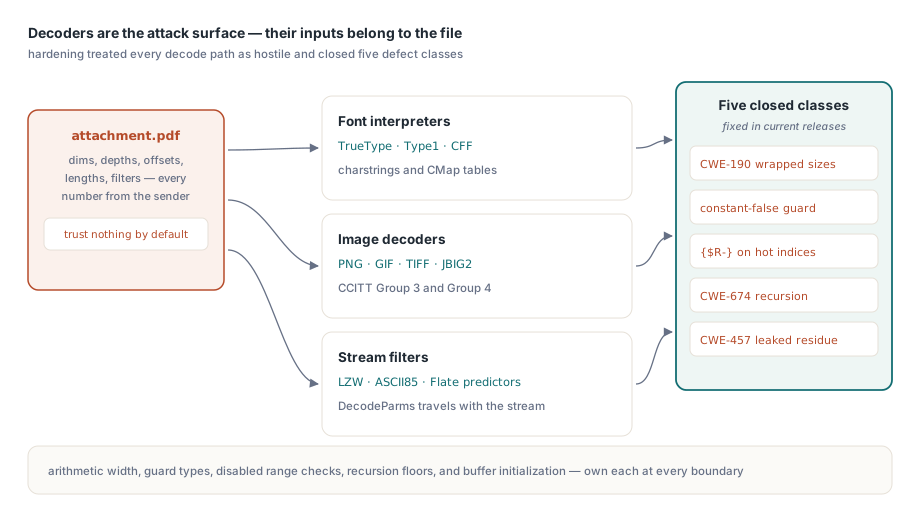
PDF 不是一个你打开的文档,它更像一个你运行的小程序。每个嵌入字体都像一个等待 charstrings 的栈式解释器,每张图像都带着由文件自己声明的宽度、高度和位深字段交给解码器处理,而每个 stream 又都包裹在同样由文件参数控制的 filter 里。这些数字没有一个来自你自己,它们来自文件的生产者,而在真实业务里,这可能是客户的发票,也可能是未知发件人的附件。把这些字节转换成像素和字形的解码器,就是实际的攻击面;如果解析器在这里信任输入,那么距离崩溃甚至更糟的结果,往往只差一个畸形文件
PDF Library for Delphi 把整个解码路径都视为敌对输入:字体程序(TrueType、Type1、CFF 和 CMap 表)、图像解码器(PNG、GIF、TIFF、JBIG2 以及 CCITT Group 3 和 Group 4),还有 stream filters(LZW、ASCII85 和 Flate predictors)。下面要讲的,就是这条路径必须堵上的五个内存安全陷阱,每一个都扎根于使其成为可能的那个具体 Delphi 行为;同样的形状也会在任何解析不受信任输入的 Pascal 代码里反复出现
一个会把过小缓冲区交给你的整数溢出
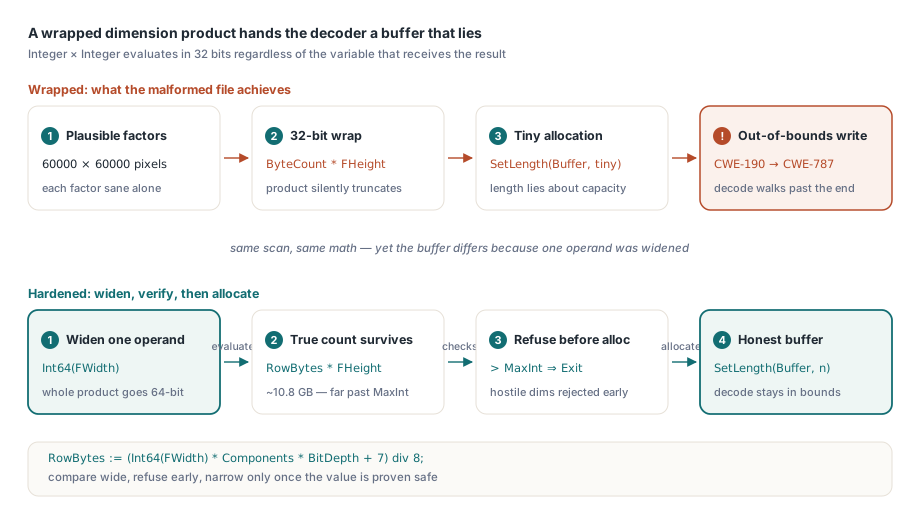
图像解码器中最经典的内存安全错误,是尺寸乘积发生回绕。解码器读取 width、height、component count 和 bit depth,用这些字段相乘来计算输出大小,按这个结果分配字节数,然后再按图像的真实尺寸写入数据。如果乘法是在 32 位算术里完成,即使每个单独因子都还在看似合理的范围内,最终乘积也可能回绕成一个很小的值,于是分配虽然成功,但得到的缓冲区远小于真实需要,接下来的解码过程就会直接越过末尾继续写入。这就是 CWE-190,也就是整数溢出,并在下一步演化成 CWE-787,也就是堆外越界写入
当独立解码器自己计算尺寸时,只在共享图像路径上把每个维度限制到 65535 以内是不够的。像 ByteCount * FHeight 这样的行字节数乘高度表达式,或者像 FWidth * Components * BitDepth 这样的按像素表达式,只要两个操作数都是 32 位整数,在 Delphi 里就是 32 位乘积,与你把结果赋给多宽的变量无关。60000 的宽度和高度对一幅大型扫描图来说各自都合理,但它们的按字节乘积会冲破有符号 32 位范围,长度算出来就变小了。同样的陷阱也藏在 BitsPerComponent * Colors * Columns 这样的 predictor stride 里
修复方式是确保至少有一个操作数是 Int64,让整个表达式在 64 位范围内求值,然后在把结果缩回去调用 SetLength 之前,先和 MaxInt 比较,超出就直接拒绝文件
// 在分配之前就拒绝,而不是在写入之后才拒绝。
// 用 Int64 计算乘积,这样就不会在 32 位处回绕。
RowBytes := (Int64(FWidth) * Components * BitDepth + 7) div 8;
if (RowBytes <= 0) or (RowBytes * FHeight > MaxInt) then
  Exit;  // 恶意或不受支持的尺寸;拒绝这张图像
SetLength(Buffer, RowBytes * FHeight);
之所以说这是一个很典型的 Delphi 问题,而不只是通用问题,是因为这里存在静默收窄。把一个过宽表达式赋给 32 位目标类型,在编译器默认设置下是合法转换,不会自动发出警告;而 range checking 也捕捉不到发生在索引真正使用之前的回绕。如果你把乘积继续留在 32 位里,语言就会悄悄给你一个关于即将触碰多少内存的错误长度
一种让防护条件永远无法触发的字段类型
TIFF 文件是一串 image file directories 的链表,每个目录都携带下一个目录的字节偏移量。恶意文件可以把这条链指回自己,如果读取器没有停止条件,就会永远在里面打转。这属于 CWE-835,也就是由攻击者可控输入驱动的无限循环。对应的防御办法,是加一个计数器,只要遍历次数超过任何正常文件都不可能达到的上限,就强制停止
现在把页计数器声明成 Word——在 Delphi 里它的取值范围是 0 到 65535——再给循环一个形如"当 page count 超过 65535 时停止"的终止防护。它看上去完全正确,直到你注意到操作数和阈值共享同一个上界。一个 Word 永远不可能大于 65535,所以这个比较在结构上永远为 false:当计数器到达 65535 后,下一次递增会把它回绕到 0,防护条件永远看不到超过上限的值,于是一个循环的 IFD 链就能让读取器无限旋转下去
治疗办法是把字段放宽,让防护条件能表达计数器真正可能持有的值。TPDFTIFF.FPageCount 声明为 Integer 之后,FPageCount > 65535 这个比较就变得可达,循环也能终止。凡是一个边界检查长着 Value > MaxValueOfType(Value) 的形状,而操作数本身恰好就是按那个最大值声明的类型,这个条件就必然是常假:要么放宽类型,要么改成对最大值的相等判断,让它有机会触发
在热路径上关闭了范围检查
开启 range checking 时,Delphi 会在每次数组或字符串索引处插入边界检查,这正是"越界索引抛出可捕获的 ERangeError"与"同一个索引读写不属于该结构的内存"之间的差别。热路径有时会用局部 {$R-} 指令把它关掉,只要索引仍然可信,这么做站得住脚;而索引一旦变得不可信,它就站不住了
字体解释器依赖的列表访问器 TPDFlibStringList.Get 正是这样一条路径。它在 Windows 下是以关闭 range checking 的方式编译的,并且直接索引底层存储,因此超出范围的索引不再是一个普通错误,而会直接变成原始内存访问。只要索引总是正确,这不会出问题;但在 CFF 或 Type2 charstring 解释器里,索引完全可以由文件内容驱动。一个从空 operand stack 中弹值的 charstring 会产生负一索引;一个和 glyph count 差一位的 glyph identifier,会落到末尾之外的那个槽位。关闭 range checking 之后,这两种情况都会从可捕获异常变成真实的越界访问,而由于这些槽位里保存的是带引用计数的 AnsiString,一次错误读取甚至还可能把字符串的引用计数一并破坏掉
PDF Library for Delphi 在这条热路径上继续保持 range checking 关闭,转而让索引变得可证明有效:解释器在取 operand stack 顶部之前先检查栈非空;所有索引防护都写成对 count 的严格小于,而不是允许 off-by-one 混进来的小于等于。这条指令把边界责任从编译器移交给你们自己,它所移走的那些验证,必须在每个入口点手工补回来
charstring 解释器里的无限递归
Type2 charstring 可以调用 subroutine,而 subroutine 本身也是 charstring,又可以继续调用别的 subroutine,所以 local 和 global subroutine call 操作符事实上允许文件自己决定递归深度。一个直接或间接调用自己的 subroutine 会无限递归下去,直到本机栈耗尽,进程被直接拖垮。这属于 CWE-674,也就是无控制递归
Type1 解释器用一个 call-depth 计数器和上限 PLType1MaxCallDepth 来防这类问题,超过上限就拒绝继续向下,这也对应 Type1 规范自己点名的深度限制。陷阱在于:一个后来编写的、结构上相似的解释器(比如 Type2 那个)并不会自动继承这道守卫,于是一个手工构造、让 subroutine 调用自身编号的字体,就能径直穿过这处缺失的检查,一头撞进 stack overflow
// 两个 charstring 解释器都需要的深度守卫的形状。
// 在嵌套调用中跟踪深度,超过上限就拒绝继续递归。
Inc(CallDepth);
if CallDepth > PLType1MaxCallDepth then
  Exit;  // 恶意的自引用 subroutine;停止继续下降
// ……解释该 subroutine,返回时再 Dec(CallDepth)
PDF Library for Delphi 给 Type2 路径与 Type1 兄弟路径相同的受限深度。凡是沿着攻击者可控结构进行的递归下降——无论是字体 subroutine、嵌套数组还是 cross-reference chain——都需要一个输入无法抬高的深度上限
泄漏到输出里的未初始化内存
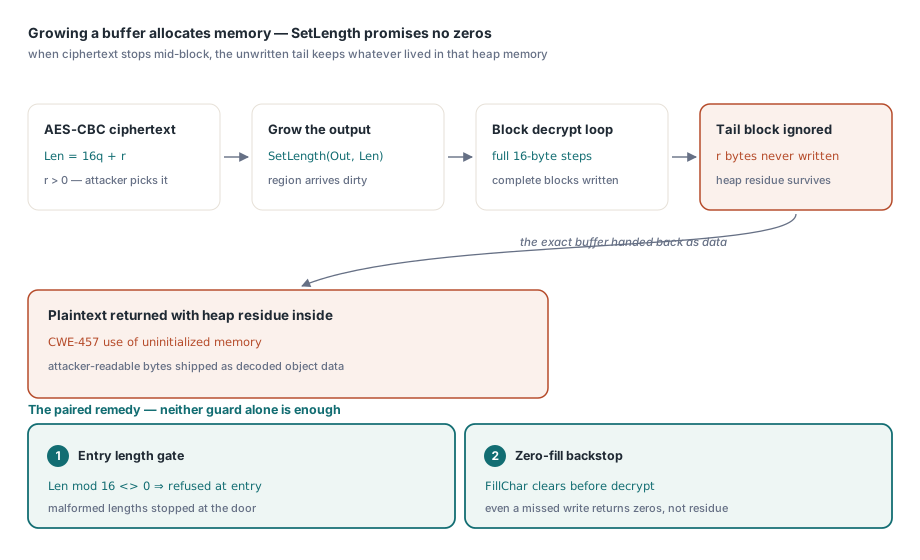
最隐蔽的那个问题,会把堆内容泄漏到解密输出里,而罪魁祸首是一条很容易被忘记的 SetLength 语义。对 AnsiString 调用 SetLength 扩容时,Delphi 会分配字节,但不会自动清零,所以新区域里保留的是那块堆内存此前留下的内容。如果后续路径一定会覆盖全部字节,这无关紧要;但只要有某条路径留下了部分区域未写入,然后仍然把这个缓冲区当作有效结果返回,那些陈旧字节就会一起被带出去。这属于 CWE-457,也就是使用未初始化内存;一旦结果跨越了信任边界,它就成了真实的信息泄漏
AES-CBC 的解密路径恰好踩中这个问题。用 SetLength 给输出缓冲区定长,一次处理一个 16 字节密文块;当密文长度不是 16 的倍数——这个长度由攻击者说了算——尾部那个不完整的块就永远不会被写入,于是最后那几个字节保留着 SetLength 留下的堆内容,而缓冲区会作为某个文档对象的解密明文被返回。治疗办法是两道守卫,单独任何一道都不够:PDF Library for Delphi 的解密入口拒绝任何长度不是块大小整数倍的密文;作为兜底,输出在使用前先用 FillChar 清零,这样任何没写入区域的路径返回的都是零,而不是堆残留
这五个陷阱的共同点是什么
这五个缺陷彼此不同,但它们的韵脚非常相似。一个会回绕乘积的整数宽度,一个把防护条件钉死成常假的字段类型,一个在索引不再可靠时仍被关闭的范围检查,一个没有地板线的递归路径,以及一个语言没有替你清零的缓冲区。在每一种情况里,Delphi 都只是忠实执行了它自己的规则,因为这门语言本来就提供会回绕的算术、静默收窄、可关闭的边界检查、没有内建深度上限的递归,以及不自动初始化的分配行为。契约就是这样,而 Pascal 解析器要想在文件可控边界上守住它,就必须手工接管四件事:整数宽度、范围检查、递归深度和缓冲区初始化
PDF Library for Delphi 这套面向 Delphi 和 C++Builder 的引擎,对这五类陷阱都设了防。如果你的工作还涉及文件如何声明自己受保护,配套的加密与权限审计和PDF/A 与 PDF/UA 预检笔记覆盖的是同一个解析器在分析侧的一面;所有这些能力都随 PDF Library for Delphi Delphi PDF Library 交付,与本博客其他文章介绍的加载、渲染和签名 API 并肩同行