两个线程共享同一个覆盖 .xlsx 包的 TFileStream。线程 A 把 Position 设到 sheet1.xml 的第一个压缩字节,片刻后线程 B 把它设到 sheet2.xml 的第一个字节,随后 A 的 Read 返回的缓冲区里装的是另一个成员的数据。A 的解压器此刻正在解码别人 deflate 流的中段;zlib 通常会在几个块之后以 Z_DATA_ERROR 停下,就算碰巧产出了输出,成员的 CRC32 也对不上。这里的问题不在 deflate:竞态完全住在流的位置游标里,而只要在“定位加读取”这一对操作外套一把锁,许多 worker 就能同时解压同一个包里的成员
大家想要这么做的原因是内存。假设一个工作簿在磁盘上 80 MB,工作表 XML 解压后膨胀五到十倍。先把每张工作表 Extract 进缓冲再解析的打开路径,要为这些膨胀后的字节买单,叠加在它正在构建的工作簿之上,而峰值出现在第一个单元格存在之前。本文讲的是包级并发,它把 Extract 这一步整个去掉;它上面的分配器天花板在并行 XLSX 解析与内存管理器一文里,而从头到尾不构建工作簿的只读一次 API 在流式 direct reader 实战一文里
暂存式设计,以及它把什么留在了内存里
把 XLSX 打开并行化的谨慎做法是一条三阶段流水线,只有中间阶段上 worker。阶段 A 在调用线程上遍历工作表列表、创建每个工作表、读取其关系部件,并把整段解压后的工作表 XML 复制进私有的 TMemoryStream。阶段 B 把 XML 解析扇出到线程池。阶段 C 回到归档上——仍在调用线程——取那些小的附属部件:批注、线索批注、绘图、图表和表格
这个形状的论证听起来无懈可击:ZIP 归档和解压状态都不是线程安全的,那就把所有归档操作留在一条线程上,锁都省了。代价是:一个有八张繁忙工作表的工作簿,在同一时刻攥着八份完整解压的工作表缓冲,而这些缓冲正是打开路径上最大的临时对象。按前文的 80 MB 包来算,那是几百 MB 的 XML 文本,存在的唯一意义是让解析器读一遍
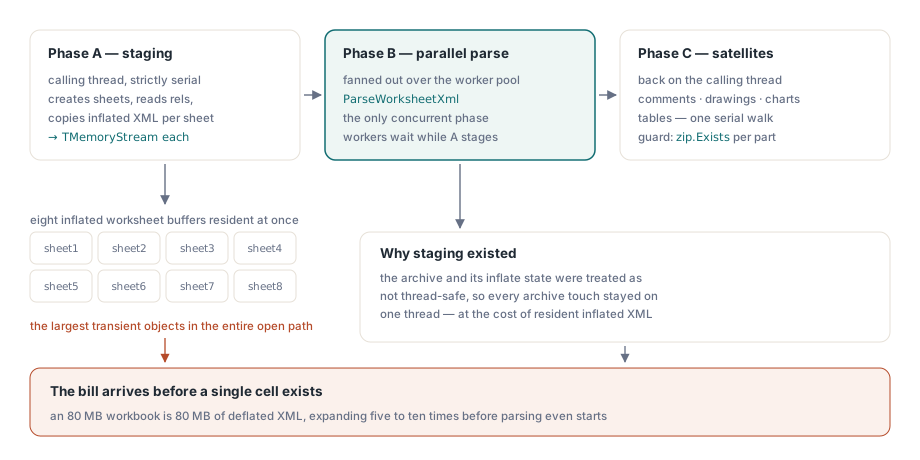
HotXLS 保留阶段 A 和 C,但把复制去掉。阶段 B 的每个 worker 在共享包上打开自己的条目流,直接交给 XML 阅读器,解压后的工作表从头到尾不以整块形式存在。这能成立,是因为 "不是线程安全" 那句论证其实混着两件不同的事
两个线程能不能从同一个 ZIP 流解压
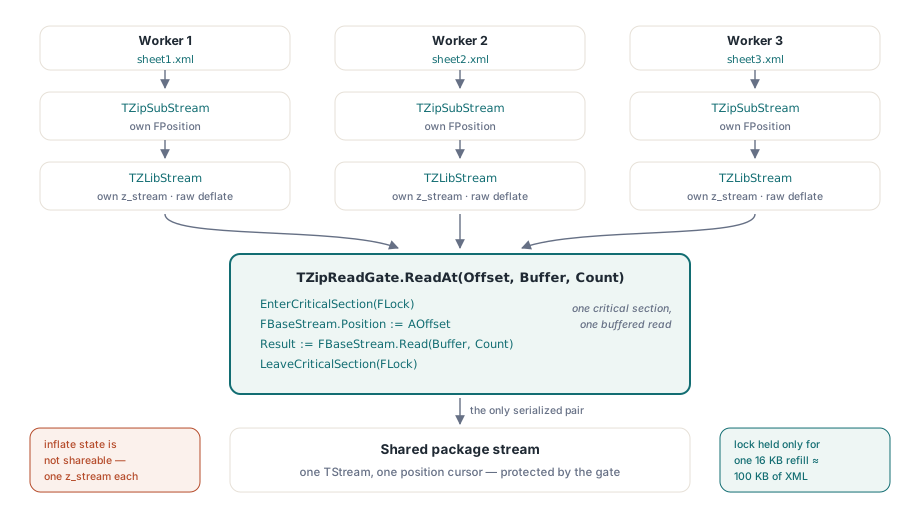
能——前提是每个线程拥有自己的解压器,而共享的字节源在读取处被串行化。谨慎派论证把两种状态折进了同一句话。解压状态确实不能共享:一个 zlib z_stream 承载着 RFC 1951 定义的 32 KB 滑动窗口、当前的霍夫曼表以及某一个压缩成员内部的位位置,两个线程往同一个 z_stream 里塞字节,产出的只会是垃圾。字节源是另一回事:文件流值得保护的可变状态只有一处——它的位置
ZIP 容器让这个拆分合法。PKWARE 的 APPNOTE(第 4.3 节)把包铺成独立成员:每个成员有自己的本地文件头、自己偏移处的压缩数据、记录在中心目录里的自己的 CRC32 和大小。没有哪个字典像 7z 的 solid 块那样横跨成员,所以条目 N 的解压不需要读条目 M 的一个字节。给每个 worker 配一个私有解压器、罩住它自己的字节区间,剩下的唯一冲突就是定位。在 HotXLS 里,这个冲突由 lxZipArchive.pas 中的 TZipReadGate 处理,整个类一屏就放得下
type
  TZipReadGate = class
  private
    FBaseStream: TStream;
    FLock: TXLSCriticalSection;   // lxPlatform 对临界区的封装
  public
    constructor Create(ABaseStream: TStream);
    destructor Destroy; override;
    function ReadAt(AOffset: Int64; var Buffer; Count: Longint): Longint;
  end;

function TZipReadGate.ReadAt(AOffset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  if Count <= 0 then
  begin
    Result := 0;
    Exit;
  end;
  XLSEnterCriticalSection(FLock);
  try
    FBaseStream.Position := AOffset;
    Result := FBaseStream.Read(Buffer, Count);
  finally
    XLSLeaveCriticalSection(FLock);
  end;
end;
TZipReadGate 保护的是什么,又刻意不保护什么
TZipReadGate.ReadAt 只守护一个不可分割的操作——给共享流定位并从中读取。中心目录解析完成后,TZipArchive.OpenArchive 会建好这道闸门,文件名和 TStream 两个重载都一样;归档释放时它随之释放。为写入创建的归档永远不会有闸门,因为没有人会并发地读它
其余一切都留在锁外,因为它们要么已经是私有的,要么已经是冻结的。TZipArchive.OpenFile 返回的每个条目流,在自己成员内部维护自己的位置,只在调用 ReadAt 的那一刻才换算成绝对的包偏移。包在外面的解压器按条目创建,窗口大小 -15——zlib 读作不带 zlib 头的裸 deflate——且从不交给另一个线程。中心目录连同本地头在任何 worker 启动前就已解析完毕,并发开始时按名字查条目已经是只读的哈希查找。查找不区分大小写,并拒绝包含 .. 段的名字
当你拿着自己的流调用 TXLSXWorkbook.Open(Stream) 时,有一个后果要记住:闸门包住的是你那条流,它的锁只协调库里 worker 彼此之间,对你的代码一无所知。如果应用的另一个线程在 Open 运行期间读取或移动同一条 TStream,第一段那个游标竞态就回来了——所以把流通手给 Open,然后在 Open 返回之前别再碰它
争用情况下,这道闸门的代价有多大
比 "给归档加一把全局锁" 听起来要小,关键在于每次拿锁覆盖了多少工作。解压器以 64 KB 压缩字节为单位补充输入,于是过一次闸门就给 worker 喂了 64 KB 的 deflate 数据,它随后在不持有任何锁的情况下解码并解析。按前文五到十倍的膨胀算,这一次补充折合大约 320 到 640 KB 的工作表标记。锁本身罩住的定位读取,通常由操作系统的文件缓存直接服务
这个比例在三种地方反转,全都关乎输入或机器。未压缩存储的成员每次读取调用都要过一次闸门,两次拿锁之间没有解压工作来摊薄成本;多数写入器会对工作表部件做 deflate,但一个全部用存储方式产包的工具会让串行化重得多。慢速或网络存储上的冷文件会拉宽临界区,因为里面的读取成了真实的传输。而 worker 一多,闸门反正也不是第一堵墙:工作表解析大量分配内存,Delphi 内存管理器跨线程串行化分配,远在读闸门饱和之前
最后这一点决定了线程数。TXLSXWorkbook.ParallelParseThreads 默认 0,即每个逻辑处理器一个 worker,且永不超过工作表数。在四到八逻辑处理器的笔记本上,这个默认值没问题。在三十二线程的构建服务器上打开几十张工作表的工作簿时,请设一个显式的小上限,比如 4:多出来的 worker 基本都在分配器上排队,而每一个都攥着自己的解压器和缓冲。想为你的文件找到合适数字,把属性依次设为 1、2、4、8,在循环里打开同一个有代表性的工作簿,比较墙钟时间与任务管理器或 Process Explorer 里的峰值工作集
把条目读到末尾,CRC 校验才会触发
归档返回的每个条目流都会自我校验,但只在末尾。字节经过时它累积一个滚动 CRC32,位置到达中心目录记录的解压后大小时,比较两个值并多探测一个字节。失败以带字面消息的异常浮现:'ZIP entry uncompressed size mismatch'、'ZIP entry CRC32 mismatch'、'ZIP entry exceeds its declared size',提前耗尽的成员则是 'ZIP entry ended before its declared size'
XML 阅读器读到闭合的 </worksheet> 标签就停。它后面的东西——常常只是一个结尾换行——保持未读,位置永远到不了声明的大小,比较也就永远不会运行。暂存式设计白得这个检查,因为把条目复制进缓冲会读每一个字节;直接读条目流的解析器没有这个福利,所以每个 HotXLS worker 在释放流之前,用一个 32 KB 的暂存缓冲把解析器剩下的部分排干,释放最外层流的同时也释放解压器和它底下的子流
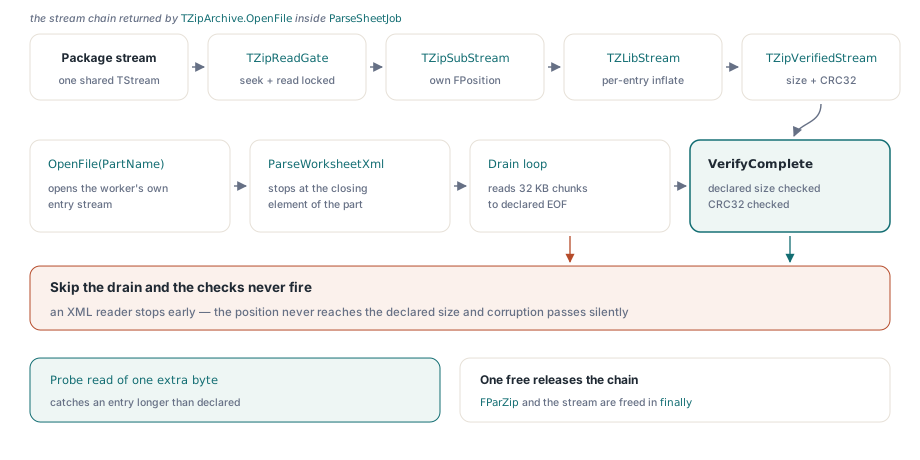
你自己的代码直接用 lxZipArchive 的 TZipArchive 时——比如在把包交给工作簿加载器之前做个体检——同一条规矩适用。一个只读每个部件开头几 KB 来嗅探根元素的函数,证明不了任何完整性。要读到末尾:
uses
  Classes, SysUtils, lxZipArchive;

// 把一个包部件读到它声明的末尾,大小与 CRC32 校验才会运行。
// PartIsIntact 是你自己写的辅助函数;它不是库的一部分
function PartIsIntact(Zip: TZipArchive; const PartName: WideString;
  out Problem: string): Boolean;
var
  Stream: TStream;
  Buffer: array [0..32767] of Byte;
begin
  Result := False;
  Problem := '';
  Stream := Zip.OpenFile(PartName);   // 部件不存在时返回 nil
  if Stream = nil then
  begin
    Problem := 'part not found';
    Exit;
  end;
  try
    try
      while Stream.Read(Buffer, SizeOf(Buffer)) > 0 do
        ;
      Result := True;
    except
      on E: Exception do
        Problem := E.Message;          // 例如 'ZIP entry CRC32 mismatch'
    end;
  finally
    Stream.Free;
  end;
end;

var
  Zip: TZipArchive;
  Problem: string;
begin
  Zip := TZipArchive.Create;
  try
    Zip.OpenArchive('quarterly-consolidation.xlsx');
    if not PartIsIntact(Zip, 'xl/worksheets/sheet1.xml', Problem) then
      Writeln('sheet1.xml: ', Problem);
  finally
    Zip.Free;
  end;
end;
那段代码里的第二个陷阱是回退。条目流只进不退:读 Size 没问题——声明的大小一开始就知道——但在窥探之后设 Position := 0 会抛 'ZIP entry stream is forward-only'。某个组件非要定位的话,用 OpenFile 把条目再打开一遍,这很便宜,而且给你一条位于偏移零的全新流。对同一个以读取方式打开的归档,多个线程可以各自调 OpenFile——工作簿加载器干的正是这件事——只要流还活着,就别释放归档
依然串行运行的部分,以及把这一切整体关掉的开关
阶段 A 仍在跑,只是少了提取。它在调用线程上创建每个工作表并读取其关系,这正是 worker 开跑后所有共享映射保持不可变的原因。共享字符串表和单元格格式表在阶段 B 开始前就已完备,期间也绝无写入。阶段 C 之后仍按顺序遍历工作表,处理批注、绘图、图表和表格,包里缺部件的工作表直接跳过
uses
  SysUtils, lxHandleX;

var
  Wb: TXLSXWorkbook;
begin
  Wb := TXLSXWorkbook.Create;
  try
    Wb.ParallelParse := True;        // 默认;False 时一次解析一张工作表
    Wb.ParallelParseThreads := 4;    // 0 = 每个逻辑处理器一个 worker
    Wb.SelectedSheets.Add('Q3 Detail');  // 可选:只解析这一张工作表的单元格
    if Wb.Open('quarterly-consolidation.xlsx') <> 1 then
      raise Exception.Create('Workbook open failed');
    // 无论哪条路径解析,加载出的工作簿都一样
  finally
    Wb.Free;
  end;
end;
在 Open 之前把 ParallelParse 设为 False,同样的按工作表作业会以线程数一运行,线程池退化成调用线程上的普通循环。只有一张工作表的工作簿无论如何都走这条路。诊断打开问题时记住这个开关:一行代码就把多线程从方程里去掉,而两条路径跑的是同一套解析代码,拿回来的工作簿不因设置而异
错误同样保持串行形状。某个 worker 抛异常后,不再派发更多工作表,所有 worker join,工作表索引最小的那个异常在调用线程上重新抛出——损坏的 sheet3.xml 仍表现为来自 Open 的一次异常。RecoveryMode 设为 True 时,解析失败的工作表被跳过,并作为警告记入工作簿诊断。没进 SelectedSheets 的工作表压根不会打开自己的条目流,MetadataOnly 则完全跳过并行阶段。打开路径的更多调优见Delphi 大型工作簿性能指南
这里的读取闸门、并行打开阶段和条目级 ZIP 访问都是面向 Delphi 与 C++Builder 的 HotXLS Delphi Excel component 的一部分,随附完整源码,你可以对照产品页上描述的 TXLSXWorkbook 打开属性直接阅读 lxZipArchive.pas