用八个工作线程解析八工作表 XLSX 包的 Delphi 加载器,CPU 曲线可能几乎不高于一个核心;把线程数从 2 扫到 8,秒表几乎纹丝不动。两个线程时加载甚至可能比朴素的串行循环更慢。解析代码自己不加锁,各工作表也不共享数据,所以等待发生在源代码从未提到的地方:内存管理器内部——每个工作线程为每个元素名、属性值和单元格都要调用它
线程数是人人先去拧的那个旋钮。对受分配限制的代码,它几乎拧不动任何东西。真正挪动曲线的,是每个单元格要付出的堆分配次数
HotXLS 如何把 Open 拆成三个阶段
默认情况下,HotXLS 在工作线程上解析多工作表 XLSX 包的工作表。TXLSXWorkbook.ParallelParse 初始为 True,ParallelParseThreads 初始为 0,即操作系统报告的每个逻辑处理器一个工作线程,且绝不超过待解析的工作表数。Open 的三个阶段中只有一个跑在这些工作线程上。阶段 A 是串行的:它读取 workbook 部件、共享字符串和样式,按名称与可见性创建每个工作表,并解析每个工作表的 relationships 文件,让超链接和表格目标提前解析完毕。等工作线程启动时,它要查的每一张查找表都已完整,且只会被读取
阶段 B 把每个工作表交给一个工作线程。工作线程用 interlocked 增量从共享计数器认领工作表索引,所以一个有一张大表、七张小表的工作簿无需调度器就能自我均衡:谁做完一张小表,谁就取下一个索引。ZIP 容器是无法天真共享的那部分,因为 deflate 流逐块携带状态,两个线程无法推进同一个解压器。于是每个工作线程在自己的工作表条目上打开自己的解压器,把 XML 直接流入自己的读取器。文件句柄是唯一的共享资源,围绕它的锁一次只覆盖一次压缩字节的 seek-and-read。解压与解析都在并行进行,任何工作表的 XML 都不会完整解压后驻留内存。解析结束后,工作线程会把条目读到末尾,让 ZIP 的大小与 CRC 校验照常运行
阶段 C 回到单线程,处理挂在每个工作表上的外围部分:普通批注与线程批注、绘图与图表、表格、打印设置。在大多数工作簿里,这些与单元格 XML 相比都很小
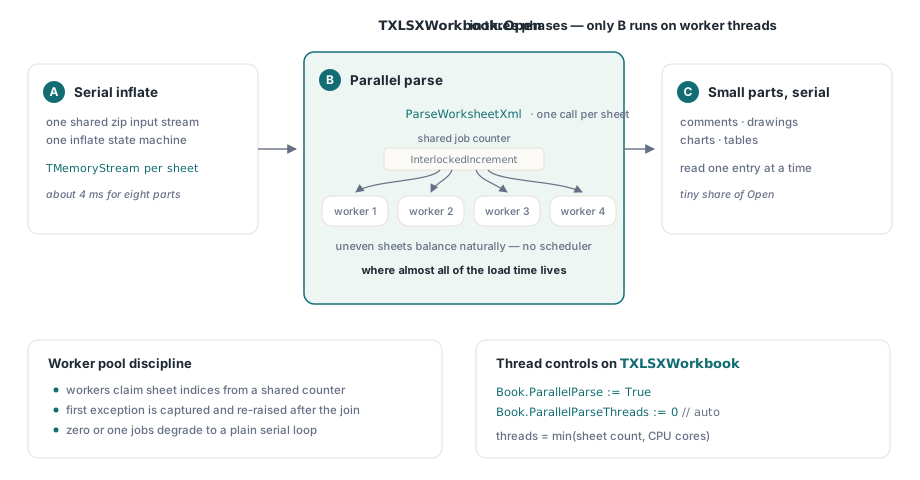
错误会回到调用线程。某个工作表在解析中抛出异常时,线程池停止发放新索引,等待仍在运行的工作线程收尾,然后从 Open 重新抛出编号最小的失败工作表的异常——报告遵循工作表顺序,调用方永远不必应付从工作线程里逃逸出来的异常。RecoveryMode 设为 True 时,解析失败的工作表改为跳过,一条警告写入 Diagnostics,其余工作表照常加载。把 ParallelParse 设为 False 则由同一个解析器逐张处理工作表,结果完全一致
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // 两个值都是默认值;明写出来能让这个选择
    // 在代码评审里看得见
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = 每个逻辑 CPU 一个工作线程,上限为工作表数
    Book.RecoveryMode := False;      // 解析失败的工作表会从 Open 抛出异常
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // 此时每个工作表都已完整加载;照常读取单元格
  finally
    Book.Free;
  end;
end;
为什么加线程反而让分配密集的解析器更慢?
工作表解析主要是小额分配,而 Delphi 默认内存管理器让线程在这些分配上轮流排队。朴素的 XML 读取器会为每个元素名生成一个字符串,为每个属性名和属性值各生成一个,再为单元格生成一个 Variant 和一个文本字符串。默认内存管理器把小块按大小分组放进池中,并用锁守护每个池。发现锁被占用的线程会退避、休眠、再重试。当八个工作线程都在索要同样那几种小尺寸时,它们不断在相同的池上相撞,源代码里看似独立的线程最终一个接一个地运行
开头那两个症状都由此得到解释。CPU 时间贴近墙钟时间,因为休眠的线程不烧 CPU;线程扫描曲线平坦,是因为定节奏的是池锁而不是核心。两个线程还可能干脆输给一个:每次分配现在都要付出在核心之间传递锁的代价,而串行循环根本不存在竞争
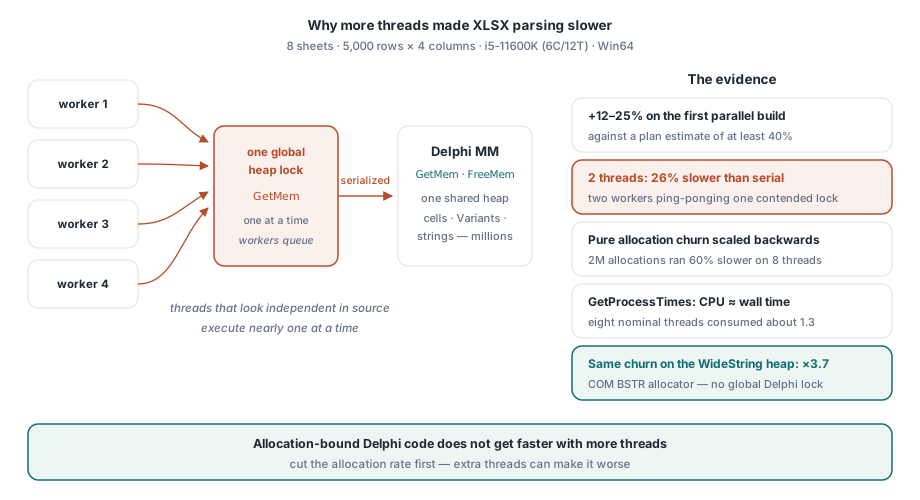
在 Windows 上有一种字符串类型置身事外。WideString 是 COM BSTR,由系统的 OLE 字符串分配器而非 Delphi 内存管理器分配,所以 WideString 的流量永远不在 Delphi 池上排队。HotXLS 把单元格文本存为 WideString,这一点对并行加载的影响比它当年对串行路径的影响更大
在自己的工作簿上测量竞争
两个数字能告诉你一次加载是否受分配限制:工作线程数上升时墙钟时间如何变化,以及同一时间段进程消耗了多少 CPU。如果八个工作线程名义上都在忙,而 CPU 时间除以墙钟时间仍接近 1.0,它们就是在排队而不是在解析。下面的扫描用 1 到 8 个工作线程打开同一个文件并打印这两个数字。它是给你自己的测试项目用的测量工具;只有 TXLSXWorkbook 的成员来自 HotXLS
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// 你自己的辅助函数:本进程的用户 + 核心 CPU 时间,毫秒
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // 100 纳秒刻度换算成毫秒
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 就是朴素的串行循环
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
把扫描多跑几遍,为每个线程数保留最好的成绩,因为首轮还要为冷磁盘缓存买单。墙钟时间曲线平坦且 CPU/墙钟接近 1,说明内存管理器就是天花板。如果墙钟时间持续下降、CPU/墙钟向线程数爬升,则文件是解析受限,额外的工作线程物有所值
平坦曲线引出下一个问题:是哪些分配在作祟?一个按大小统计调用次数的内存管理器包装器,不用 profiler,几分钟就能给出答案。下面的版本只统计 GetMem,FreeMem 和 ReallocMem 仍指向原管理器,这已足够看清流量从何而来
// 加进你自己测试工具的诊断代码;不属于 HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // 值得关注的小块分配流失
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
在 Open 之前装上计数器,结束后立刻卸下,再用文件里的单元格数去除 AllocCount。这个每单元格数字才是值得逐个构建版本跟踪的指标,32 字节及以下的块占比则显示短字符串是否占主导。动手写单元格对象池之前先测它:每个单元格对象是一次分配,而解析该单元格时产生的短命字符串很容易数倍于它
分配藏在工作表 XML 的哪些地方
像 <c r="B7" s="3" t="s"><v>42</v></c> 这样的单元格在磁盘上看起来微不足道。一个直来直去的读取器仍会把它变成一连串新字符串:元素名 c 和 v、三个属性名、三个属性值以及文本内容。每个 UTF-8 标记经过 RTL 转换,都会在最终的 WideString 诞生之前多出一个中间 UnicodeString。这些字符串没有一个活得比单元格久,而每一个都要跑一趟内存管理器
HotXLS 的 XML 读取器向两个最大的源头开刀。工作表 XML 里的元素名来自一个非常小的词汇表(row、c、v、f、is),所以读取器维护一个见过名称的短缓存,把每个新名称的原始字节与缓存比对,命中就返回缓存的字符串。缓存副本刻意用 AnsiString:AnsiString 带引用计数,发放一个缓存实例只花一次计数递增,完全不产生分配。缓存 WideString 名称则毫无收益:WideString 没有引用计数,每次赋值都是一次新的系统分配
属性名、属性值和单元格文本走另一条路。读取器直接从扫描缓冲区两遍解码 UTF-8:第一遍统计 UTF-16 码元数,第二遍填入按该长度一次性分配的 WideString。这样每个标记只有一次分配,而且落在系统字符串分配器上,不进 Delphi 池。形如 A 的字符引用和预定义实体在解码开始前就由扫描器解析完毕,解码器看到的始终是纯 UTF-8。对不是有效 UTF-8 的字节序列,解码器会逐字节照抄问题字节,而 RTL 转换会丢弃或替换它们,因此损坏的文件在坏点附近仍能得到可读的 ASCII。有效输入两种方式解码结果相同
这两招都能搬进你自己的 Delphi 解析代码。只有字符串类型带引用计数时,缓存才真正省下分配;直接解码进目标类型,则免掉了那些便捷 RTL 转换函数每次调用都会制造的临时对象
哪些工作簿受益,以及该如何选择设置
并行解析以工作表为粒度,所以工作簿的形态决定了大部分结果。几张大小相近的工作表是最好的情形,包括按区域或按月复制模板工作表得到的那些文件。整个工作簿只有一张巨表的,无论 ParallelParseThreads 怎么设都只由一个工作线程解析;这种形态更适合流式直接读取器,因为它根本不在内存中构建整个工作簿。花在批注、图表和绘图上的时间留在串行的阶段 C。待解析工作表为 0 或 1 个的文件会跳过线程池,直接跑朴素的串行循环
当只有部分工作表重要时,在调用 Open 前把它们的名称列进 SelectedSheets。其余工作表仍会带着名称与可见性被创建,只是没有单元格;工作线程会掠过它们,用户日后打开时再由 LoadSheet 补齐
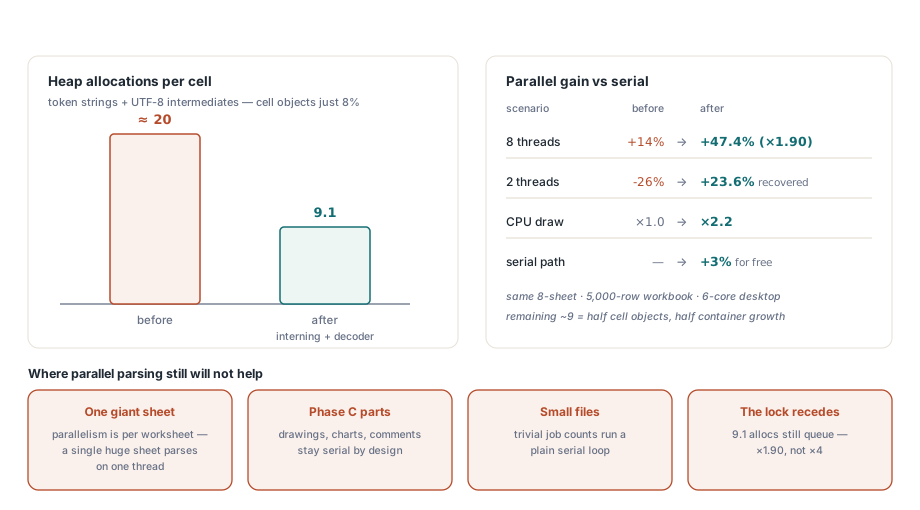
一次打开一个工作簿的桌面工具和批处理作业,让 ParallelParse 保持开启。这个默认值更稳妥:结果与串行路径一致,真出现线程问题时一个属性就能关掉。已经在并发打开多个工作簿的服务器则是另一回事:每个请求线程都在分配,每个额外的解析工作线程都给同一批内存管理器池添一个竞争者;那里把 ParallelParseThreads 设为 2,并且只有当上面的扫描在该服务器正常负载下运行、显示额外工作线程物有所值之后才往上加。每单元格分配的减少抬高了天花板,但没有移除它:单元格对象和容器增长仍要走 Delphi 池,这正是八个线程的收益远低于八倍的原因。加载与保存工具箱的其余部分,从样式复用到批量行回调,见Delphi 大型工作簿性能指南
工作线程池、ParallelParse 与 ParallelParseThreads 开关以及分配精简的 XML 读取器,都随 HotXLS Delphi Excel Component 交付;它直接从 Delphi 和 C++Builder 代码读写 XLS、XLSX 和 ODS,机器上无需安装 Excel