“这份工作簿还定义着叫 TaxRate 的名称吗?”这个问题由 XLSX 包里一小块就能回答。工作表名称、它们的隐藏或深度隐藏状态、所有工作簿级定义名称都住在 xl/workbook.xml(ECMA-376 Part 1, §18.2)里,通常几 KB。单元格住在别处——每个工作表一个 xl/worksheets/sheetN.xml 分部加一张共享字符串表,几乎所有字节都在那里。一个坚持先构建完整工作簿才许你提问的加载器,会为了回答前几 KB 早已定案的问题,把文件夹里每个文件的这一切都解压并解析一遍
要紧的分界在于:读工作簿的形状,和读它的重量。一个能在形状读完就停下的加载器,可以为选定的工作表子集加载重量、之后再补取一张工作表,把“打开工作簿”从一步定胜负变成每次调用自己定范围的操作。它也带来两个陷阱:一个关于索引基,一个关于源文件必须在原地待多久
仅元数据的 Open 读什么,停在哪里
在 Open 之前把 TXLSXWorkbook.MetadataOnly 设为 True,HotXLS 解析工作簿分部、样式、主题、定义名称、工作表名称和可见性状态、连接、外部链接,以及来自 docProps/core.xml 和 docProps/app.xml 的文档属性。然后跳过每个工作表的单元格 XML 和每表卫星分部:批注、绘图和表。共享字符串表也一并跳过——这一点比听上去重要,因为文本密集的工作簿里那一个分部的体量能与工作表们打平
返回的工作簿结构完整。Sheets.Count 正确,每张表有真名和 Visibility,DefinedNames 已填充,ExternalLinks 列出每个链接目标,Title、Author 和 LastModifiedBy 带着文件声明的内容。每张表只是零个单元格
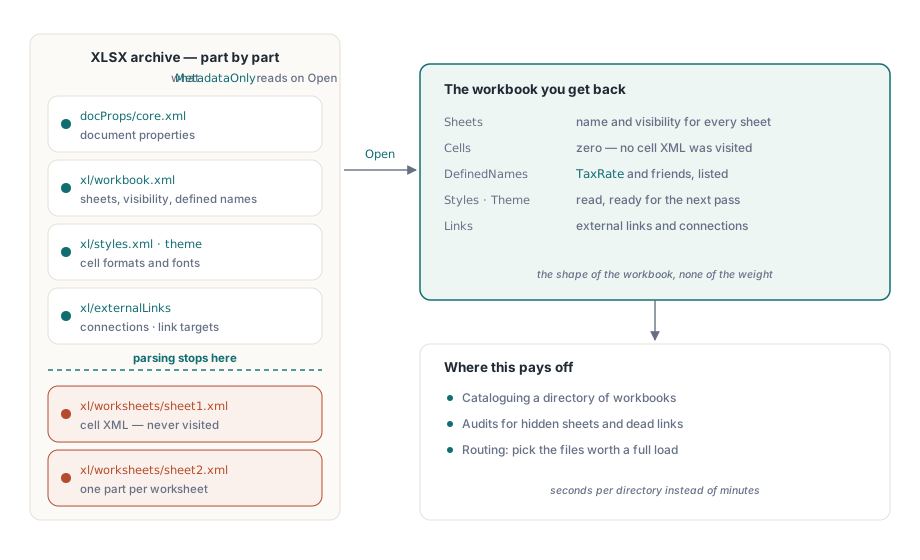
这正是审计要跑的数据。哪些工作簿藏了工作表?哪些还定义着 TaxRate、指向什么?哪些链向去年已退役的文件共享?下面的扫描器对一个文件回答全部三问。注意并排的两种索引约定:Sheets[] 从 1 开始,与 XLS 引擎一致,而 DefinedNames 和 ExternalLinks 是普通的从 0 开始的列表
procedure ScanWorkbook(const FileName: WideString; Report: TStrings);
var
  Workbook: TXLSXWorkbook;
  Name: TXLSXDefinedName;
  I: Integer;
begin
  Workbook := TXLSXWorkbook.Create;
  try
    Workbook.MetadataOnly := True;           // Open 时读取,所以要先设置
    if Workbook.Open(FileName) <> 1 then
    begin
      Report.Add(FileName + ': open failed');
      Exit;
    end;
    for I := 1 to Workbook.Sheets.Count do   // Sheets[] 从 1 开始
      case Workbook.Sheets[I].Visibility of
        xlsxSheetHidden:
          Report.Add(FileName + ': hidden sheet ' + Workbook.Sheets[I].Name);
        xlsxSheetVeryHidden:
          Report.Add(FileName + ': very hidden sheet ' + Workbook.Sheets[I].Name);
      end;
    Name := Workbook.DefinedNames.FindByName('TaxRate');
    if Name <> nil then
      Report.Add(FileName + ': TaxRate = ' + Name.Formula);
    for I := 0 to Workbook.ExternalLinks.Count - 1 do   // 从 0 开始的列表
      Report.Add(FileName + ': links to ' + Workbook.ExternalLinks[I].Target);
  finally
    Workbook.Free;
  end;
end;
扫描器特意读 Visibility 而不是布尔值 Visible。两种隐藏状态下 Visible 都是 False,而深度隐藏的工作表恰是审计最想标记的——Excel 的取消隐藏对话框不列出它,只有 VBA 或直接改文件才能把它请回来
用 SelectedSheets 从四十张表里加载两张
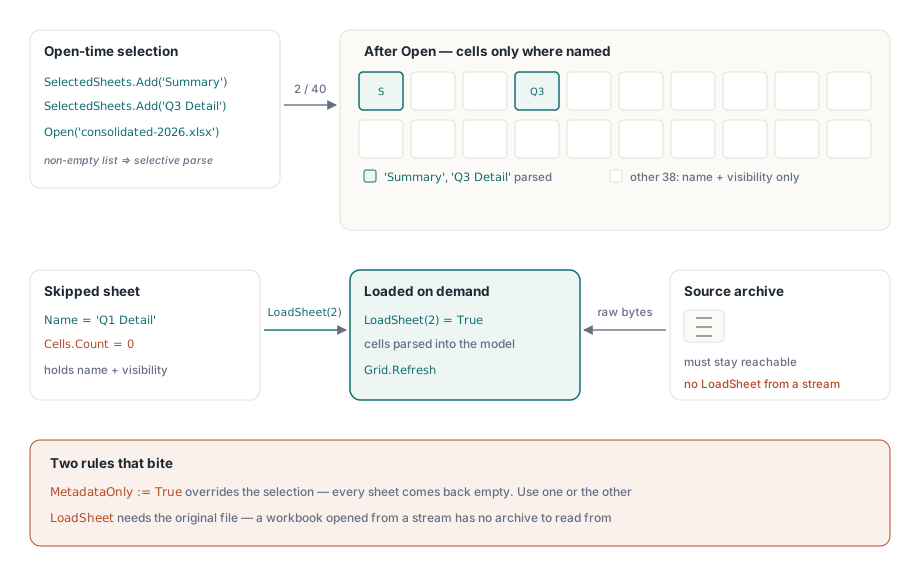
SelectedSheets 是工作簿持有的一个 TStringList。列表里至少有一个名字时,Open 只为它点名的表解析单元格 XML;其他每张表都带着正确的名称和可见性创建、没有单元格。空列表是默认值,加载全部工作表。名字用列表自己的 IndexOf 查找,所以默认设置下匹配忽略大小写——这与 Excel 的工作簿内两张表名不能仅大小写不同的规则正好对上
Workbook := TXLSXWorkbook.Create;
Workbook.SelectedSheets.Add('Summary');
Workbook.SelectedSheets.Add('Q3 Detail');
if Workbook.Open('consolidated-2026.xlsx') = 1 then
ShowSheet(Workbook.Sheets[1]); // ShowSheet 是你自己的 UI 代码两个开关只朝一个方向相互作用。MetadataOnly = True 压过选择、跳过所有表,所以同时配置两者的工作簿回来时处处无单元格,选择看起来坏了,其实是被压了。每次 Open 用一个:发现用仅元数据,定向干活用选择
ParallelParse 打开时,选择性加载同样贯穿并行解析阶段;未选中的表在 worker 作业内部被跳过,线程把时间花在你点名的表上。源是二进制 .xlsb 工作簿时这两个属性同样适用,但有一条范围规则:带 VBA 工程的 .xlsb 必须不用这两个选项打开;任一设置后,Open 会报告选择性读取不受支持
为什么 LoadSheet(1) 加载了错误的工作表?
因为 LoadSheet 收从 0 起的位置,而 Sheets[] 从 1 起。LoadSheet(1) 实体化的是工作簿里的第二张表;又由于加载已有单元格的表是不动声色的空操作并返回 True,一个搞混的索引可以看着像成功,而用户点的那张表依然空着。这个换算在你的代码里只该存在于一个地方
第二个陷阱是文件寿命。LoadSheet 不在两次调用之间保持归档打开。它按名字重新打开原始文件,解析工作簿分部、样式和共享字符串,然后解析请求的工作表。信任这个文件之前,HotXLS 会把它的大小和最后写入时间与 Open 时捕获的值比较;若期间有别的进程保存覆盖了工作簿,LoadSheet 返回 False,而不是把另一个版本的单元格混进你已持有的模型
procedure TReportForm.ShowSheetNo(SheetNo: Integer);  // SheetNo 从 1 起,与 Sheets[] 一致
var
  Sheet: TXLSXWorksheet;
begin
  Sheet := FWorkbook.Sheets[SheetNo];
  if Sheet.Cells.Count = 0 then
    if not FWorkbook.LoadSheet(SheetNo - 1) then      // LoadSheet 要的是从 0 起的位置
    begin
      StatusBar.SimpleText := 'The workbook changed on disk; reopen it';
      Exit;
    end;
  Grid.ShowSheet(Sheet);                              // 你自己的表格代码
end;
这套设计带来几条推论。从 TStream 打开的工作簿没有源文件可回,所以对流打开的 .xlsx,LoadSheet 返回 False;加密工作簿同理——它先在内存里解密再解析。从流选择性打开的二进制 .xlsb 是例外,HotXLS 会为延后的表暂存一份流的临时副本。而真正空着的表每次调用都会被重读,因为零单元格也是被跳过的表的样子
成本模型决定怎么用。每次 LoadSheet 都重解析共享字符串表,所以一张一张实体化十张表要为那个分部付十次钱。对用户偶尔多开一个标签页的查看器,这价钱可以接受。已经知道表集合时,改用 SelectedSheets 重开:一次归档遍历,一次共享字符串解析。内容上也有差别:LoadSheet 只带来表本身的单元格、值、公式和格式,而批注、绘图和表随 Open 一起来——所以你的代码要读其批注或表的那些工作表,应该一开始就放进选择
一个有意重新打开的发现流水线
全量重生成的保存会重写从未变过的字节。解压主题、构建对象模型、再序列化、再压缩,结果与原件不同——尽管没人碰过主题。对 VBA 工程和数据透视缓存,代价不止是嘈杂的 diff:VBA 工程是带内部流的二进制复合文件,数据透视缓存持有源数据快照、透视表定义按位置引用其字段,所以没人改它们时,最稳妥的做法是别动它们的字节
PreserveRawParts 默认 True,让 SaveAs 直接从源归档拷贝未变分部的压缩字节。覆盖范围:主题、VBA 工程、连接、图表、嵌入媒体、打印机设置、数据透视表、数据透视缓存定义与记录——每个都只在模型声明它未被修改时走这条路。这些分部途中从不解压也从不重压。把属性设为 False 强制每个分部完整重序列化——想让输出只反映对象模型所含内容时,伸手摸这个开关
原始拷贝路径用与 LoadSheet 相同的文件检查:源必须仍以 Open 时见到的大小和时间戳存在。不满足时,SaveAs 正常序列化那些分部,文件依然完整。两种情况总是走序列化路径:源是二进制 .xlsb 的工作簿(读取时已转成 XML),以及设置 StrictOOXML 的保存(分部命名空间变了)
保存部分加载的工作簿需要一个决定。对 .xlsb 源,只要还有表被延后,SaveAs 就拒绝,并在 Diagnostics 里记下“保存前先加载所有被延后的二进制工作表”。对 .xlsx,把选择性加载的工作簿当只读视图对待:壳表没有单元格可供写出,所以要么先对每个壳调 LoadSheet,要么编辑保存之前不带选择重新打开
这与其他大文件杠杆的关系
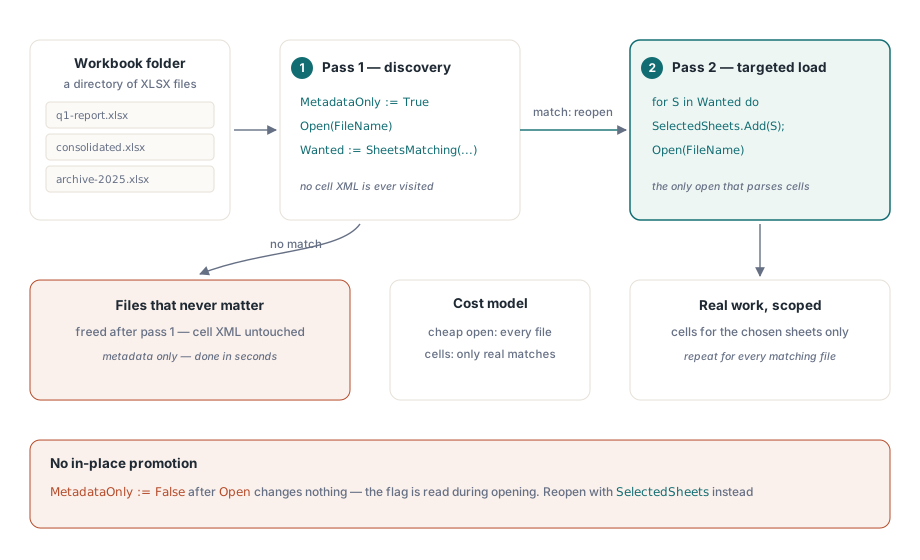
站得住的模式是两遍。第一遍对每个文件仅元数据打开并做判断;第二遍只重开命中的文件,带工作表选择,干活。重开看似浪费,直到你数一数第一遍省下了什么:第二次 Open 是唯一解析单元格的一次,而且只解析第一遍挑中的表
procedure ProcessInvoiceFile(const FileName: WideString);
var
  Probe, Workbook: TXLSXWorkbook;
  Wanted: TStringList;
  I: Integer;
begin
  Wanted := TStringList.Create;
  try
    // 第一遍:发现,不碰单元格
    Probe := TXLSXWorkbook.Create;
    try
      Probe.MetadataOnly := True;
      if Probe.Open(FileName) <> 1 then
        Exit;
      for I := 1 to Probe.Sheets.Count do
        if Pos('Invoice', Probe.Sheets[I].Name) > 0 then
          Wanted.Add(Probe.Sheets[I].Name);
    finally
      Probe.Free;
    end;
    if Wanted.Count = 0 then
      Exit;                               // 这个文件里没有值得解析的东西

    // 第二遍:只为选中的工作表解析单元格
    Workbook := TXLSXWorkbook.Create;
    try
      Workbook.SelectedSheets.Assign(Wanted);
      if Workbook.Open(FileName) = 1 then
        PostInvoices(Workbook);           // 你自己的处理代码
    finally
      Workbook.Free;
    end;
  finally
    Wanted.Free;
  end;
end;
Open 之后清掉 MetadataOnly 不会把探测对象变成完整工作簿。这个标志在打开时读取;之后改它只影响该对象的下一次 Open。探测对象仍可经 LoadSheet 一张一张长,一两张时还算合理,但流水线更适合干净的重开——顺带把每张表的批注和表也一起带来
为什么一次往返会改动你从没碰过的分部
选择性加载削减的是你解析的东西。表一旦加载,它的成本它一点也不分担;作业需要每张表的每个单元格时它也帮不上。那种情形关于存储——见行块单元格存储与区间样式叠加一文——和解析吞吐——见并行 XLSX 解析与内存分配器。任务是完全只读、编辑都不碰时,流式直接读取器整个跳过工作簿对象模型,比任何构建模型的加载策略都更合适
这一切都跑在你自己的 Delphi 或 C++Builder 可执行文件里,做扫描的服务器上不需要安装 Excel。支持的格式、版本与许可列在HotXLS Delphi 电子表格组件页面