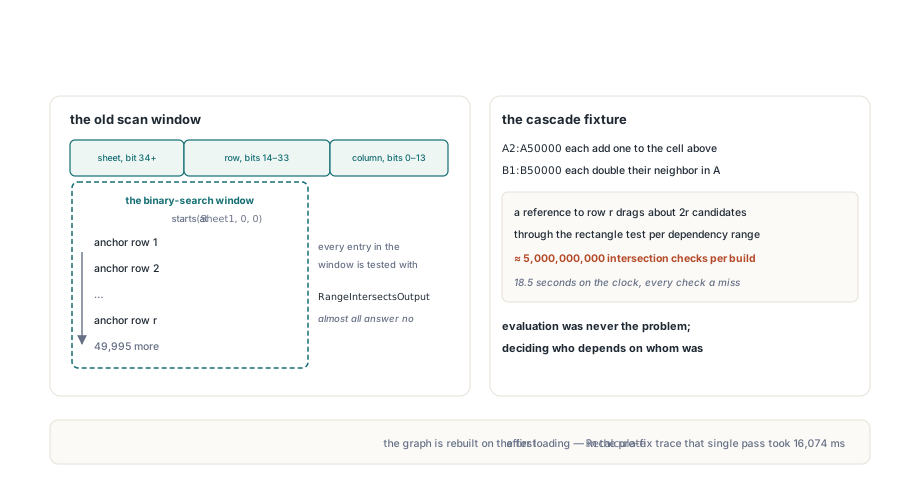
A 列 50,000 条公式各自给上面的单元格加一,B 列再放 50,000 条把邻居翻倍——这样的表格模型朴素得不能再朴素。求值它只花 100,000 次加法和乘法;而求值顺序的计算,若边构建器按最显然的方式写,代价要大得多:从被引用表的顶端向下搜到被引用行,逐条测试公式是否重叠,留下命中的。光这一张表就是约五十亿次矩形测试,而且几乎每一次的答案都是“不”
五十亿是算出来的,不是秒表读出来的。对第 r 行的一个引用会把约 2r 个候选拖进搜索窗口——它上方每行、每列各一个——对 100,000 个引用求和,量级就到了数十亿。有意思的是,这个窗口确实必须从表顶端开始,而理由与偷懒毫无关系
依赖图重建把时间花在哪儿
只要公式拓扑变化,HotXLS 重算引擎就会重建公式依赖图:工作簿加载或生成之后的第一次 Recalculate,以及公式重写、工作表增删、单元格块被克隆之后的第一次。TXLSWorkbook 和 TXLSXWorkbook 两个工作簿类都为此从 lxDepGraph 单元构建一个 TXLSDepGraph。每个公式单元格成为一个节点,带一个锚点(Row, Col)和一个延伸到(OutRow2, OutCol2)的输出矩形。对普通公式,这个矩形就是锚点单元格本身
节点按 XLSDepMakeKey 打包出的 64 位键排序:列占 0–13 位,行占 14–33 位,sheet 索引从 34 位起。按该键排序得到先按表、再按行的顺序,所以找一个引用可能涉及的最后一条公式,只需对(Sheet2, Row2, 16383)做一次二分。第一条才是麻烦所在:下界必须是(Sheet1, 0, 0),即被引用表的最顶端,两个界之间的所有节点都成了候选
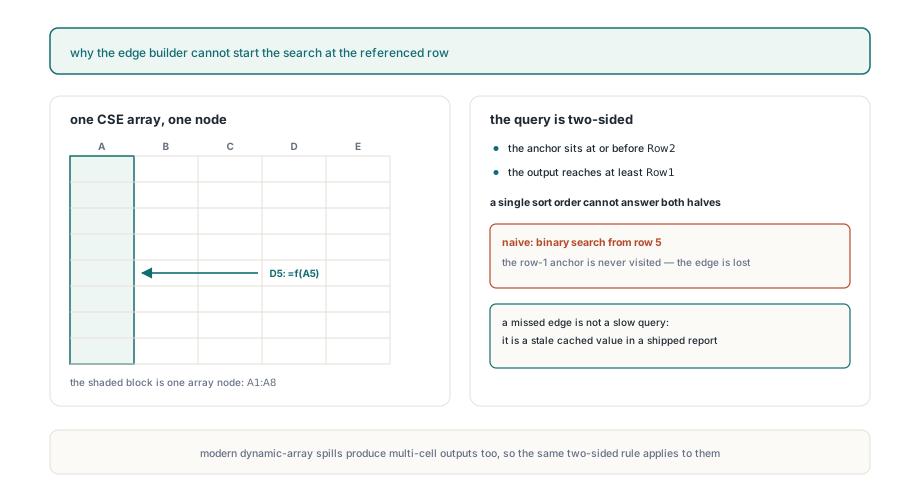
搜索为什么不能从被引用行开始?
锚在区域上方的数组公式可能拥有区域内部的单元格。在 TXLSXWorkbook 中,输入在 A1:A8 的 CSE 数组是单个节点,锚点为 A1,输出一直延伸到第 8 行——增量重算与依赖图一文讲过这个。只读 A5 的 D5 公式仍需要一条来自该节点的边。二分若从第 5 行开始,第 1 行的锚点永远不会被访问,边不会记录,D5 就可能先于它依赖的数组被求值。症状是保存的工作簿里留下过期的缓存值——比一次慢的重算难察觉得多
所以真正的查询是两边的。一个节点成为候选的条件是:锚点不晚于 Row2、输出至少够到 Row1、所在表在引用范围内、列有重叠。按锚点排序回答了前一半;锚点顺序对后一半什么也说明不了,因为第 3 行的公式可能输出一个单元格,也可能输出一千行。What-if 数据表也是同样的形状:TXLSXWorkbook 把每个数据表登记为覆盖其整个结果区域的单个节点。动态数组公式走另一条路,被标记为 volatile,每一趟都重算;动态数组 spill 公式一文讲了 spill 区域的行为
TXLSDepGraph 是公开类,所以不用工作簿也能轻松复现这个案例。sheet 索引从 1 起,行和列从 0 起,与计算器的坐标一致。下面的探针登记数组根和读取者,构建边,还让一条逆序点引用链跑过同一个图类型,以展示后文几节都要用到的计数器
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE 数组:锚点 A1(行 0,列 0),输出向下到 A8(行 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5(行 4,列 3)只读 A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1,即 A1 根节点
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2:A1 根与 D5 自身
  finally
    G.Free;
  end;

  // 链 A1..A100000,每个单元格读它上面的那个,自底向上添加
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
按最大输出行剪掉子树
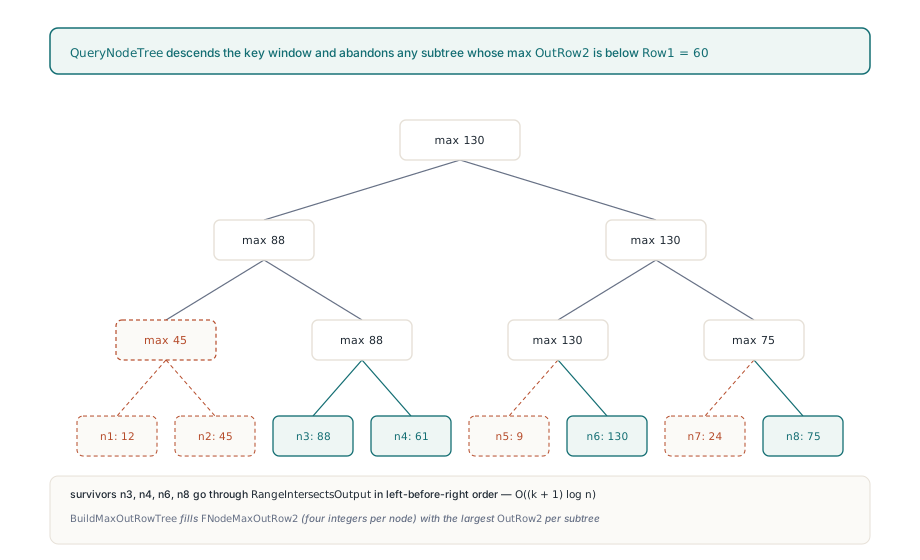
TXLSDepGraph.BuildEdges 为上界保留锚点排序,用一棵架在排序结果上的最大值增强 segment tree 回答下界。每个树节点存储其下所有节点中最大的 OutRow2。查询只在键窗口内下降,一旦某棵子树存储的最大值位于 Row1 之上(行号更小),整棵子树直接放弃——里面的公式没有一条够得到被引用的行。存活下来的节点仍要做完整的矩形测试,所以跨表与列的检查与从前一字不差
这项技术小到可以完整展示。下面的代码是专为本文写的最小版本,使用它自己的命名;这些名字都不是 HotXLS API,数组由读者自行从一个已按锚点键排好序的输出行列表填充
uses
  System.Math, System.Generics.Collections;

// 仅为示意:架在按锚点键排序的节点之上的最大值增强 segment tree。
// OutRow2[i] 是排序后第 i 个节点的最后一个输出行。
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// 从左到右收集 [Lo, Hi) 中输出够到 Row1 的每个节点
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // 在窗口之外,或没有输出够到 Row1
  if L = R then
  begin
    Hits.Add(L);                 // 调用方仍要跑完整的矩形测试
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // 先左
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // 保持扫描顺序
end;

// 先用 BuildMax(Ix, 1, 0, Count - 1) 构建一次,
// 然后每个引用调用 Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
对每个引用,工作量从窗口大小降到 O((k + 1) log n),其中 k 是输出真正够到被引用行的节点数。回到开场的模型:从 Br 到 Ar 的引用现在只测两个矩形——Ar 和 Br 自身;从 Ar 到上一格的引用测该行的两个节点。手算下来,整个构建约 200,000 次测试,而不是五十亿
同样的边,同样的顺序
先左后右的递归比看上去更重要。存活节点被访问的顺序,与对窗口做普通循环的顺序完全一致,于是每个节点的 Dependents 和 Precedents 数组按同样序列填充,由它们构建的拓扑顺序每次运行都相同。这个顺序不只是内部簿记:图是最新的时,XLSX 写出器按 FullTopoOrder 返回的顺序输出 xl/calcChain.xml——访问顺序不确定的话,同一工作簿两次保存之间就会冒出嘈杂的 diff
边的种类也保留各自的规则。出现在 VLOOKUP、MATCH、XLOOKUP 等函数的查找数组参数里的引用产生 lookup-scan 边:传播脏标记,但不参与环检测。当一个节点对同一个前置既有硬引用又有查找引用时,先记录的硬边压制后来的 scan 边;先记录的 scan 边保住自己的位置,硬边照常添加。正是这个顺序让查找区域不会产生假循环引用,而它只有在剪枝后的遍历按扫描顺序访问候选时才成立
EdgeCandidateChecks 属性让剪枝可被观测。它统计最近一次 BuildEdges 实际测试的输出矩形数,并在每次构建开始时清零。上面的探针里,逆序链报告 99,999——每个引用一次测试,尽管节点是自底向上添加的,排序不得不重排所有节点。AddNode 会把排序和边双双标记为过期,下一次 BuildEdges 或 NodeIndexOf 重建索引而不是缝缝补补
剩余的开销在哪里
这棵树只在行上剪枝,这个选择决定了大型模型仍要为什么买单
- 列上的落空要到叶子处才付费:填满
A100:Z200的 2,626 条公式都够到第 100 行,所以对AA100:AA200的引用要把它们逐个测试一遍,才在列上拒绝 - 整列以及其他宽引用确实有很多前置;索引去掉的是浪费的测试,构建真实边的开销仍与它们的数量成正比
- 跨多张表的引用会打开一个覆盖第一张表的窗口,那张表上输出很深的公式会到达叶子测试;边的结果不变,只是剪枝变弱
- 这棵树每个节点占四个整数,100,000 条公式约 1.6 MB;任何拓扑变化都要在下一次建边时付一次完整的 O(n log n) 重排序加一次 O(n) 建树
行是唯一值得索引的维度。生成的报表、台账和财务模型都向下生长,所以行距离几乎是所有浪费候选的来源;列上的落空由矩形测试在几次整数比较内拒绝。在树里加第二个维度,会让每次查询变复杂,换来的只是省下本就便宜的测试
在调用侧,昂贵的步骤是重建,而纯值的编辑不会触发它。Recalculate 第一次调用时建图;之后的调用只重算受变更值下游影响的公式,外加 volatile 的那些。值得追求的模式是:先写完全部公式,再重算一次。下面的计时工具在经典引擎上给两种趟次计时——这里的 Recalculate 返回未能求值的公式单元格数;请在将要承载批处理作业的硬件上运行它,绝对时间对机器相当敏感
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // A 列 49,999 环的链
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // B 列 50,000 个依赖者
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // 建图,全部求值
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // 值编辑:图被复用
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // 只重算脏子图
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
在这个模型里,值那一趟仍会重算全部 99,999 条公式,因为整列 A 都挂在 A1 下;它跳过的是建图。把公式单元格覆盖为普通值是另一回事:那会改变拓扑,下一次 Recalculate 会从头重建图
克隆 defined name 里同样的平方级形态
报表带在另一个地方藏着同样的模式。TXLSXWorksheet.CloneRangeTo 会复制直接指向克隆块内区域的 defined name,而每一份副本都需要一个在其作用域内唯一的名字:Total_2、Total_3,依此类推。每次复制都从 _2 重新搜索,就要多探测一个候选,于是由数百个克隆带拼成的表格,光在命名上就要花掉平方级的名称查找
TXLSXDefinedNames 用保存在名称索引里的后缀提示避开这一点,每个 base name 和作用域一条。下一次搜索从上次返回的后缀起步并优先复查它——因为调用方完全可以不加那个名字。删除名称、通过 Name 改名、用 SheetIndex 移动、或清空集合,都会把索引连同全部提示一起丢掉,于是下一次克隆回到第一个空闲后缀,并补上这次变动留下的任何空洞
对要生成或重算大型电子表格的 Delphi 和 C++Builder 应用,面向 Delphi 和 C++Builder 的 HotXLS Excel 组件在 classic 与 XLSX 两个工作簿类的重算引擎里都使用这棵带索引的依赖图