一列 10,000 个公式、每个都让上一行的值增长一点,是电子表格能装下的最便宜的模型之一。在每次遇到被引用公式就当场计算的求值器里,总和仍然正确,但算术账单不对:最后一个单元格拖着 9,999 个祖先求值,它上面的那个拖 9,998 个,一次完整扫描为 10,000 次乘法累计付出约 5,000 万次求值。改一下顶部的增长率,这个求值器就得把整张账单再付一遍,因为它不记录哪个单元格读了哪个
为什么编辑一个单元格能让整个工作簿跑一遍
两条捷径都会造成这种行为,多数手写的公式引擎占了其中一条。递归捷径对每个被引用的公式重新求值、无视任何已缓存的值,把链条变成平方级工作量,把循环引用变成栈溢出。全量扫描捷径更安全:按某种固定顺序求值每个公式,直到什么都不变为止。它正确,但成本跟着工作簿的大小走,而不是跟着编辑的大小走
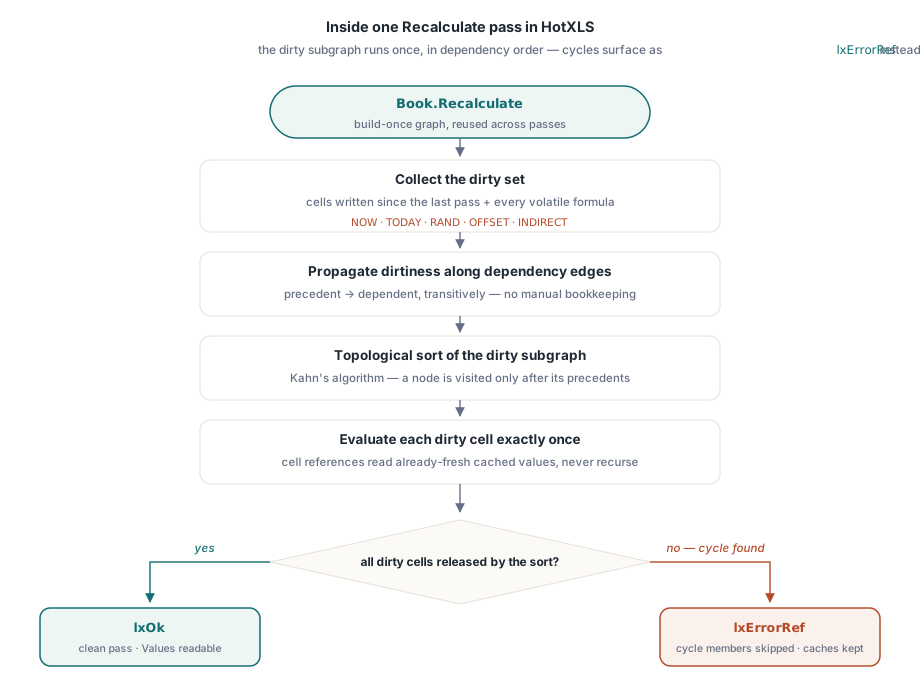
Excel 用它的计算链避开两者——给公式单元格排一个顺序,让一次编辑只标记一小部分单元格、只走受影响的尾部。HotXLS 的 XLSX 引擎在 TXLSXWorkbook.Recalculate 背后用显式依赖图实现了同一个想法。第一次调用从每张工作表的每个公式构建图并对全部公式求值;此后的每次调用只求值那些其引用覆盖了自上一轮以来被改写单元格的公式,外加一小串每轮都必须运行的公式
Recalculate 如何把一次编辑变成一趟有序处理
每个公式单元格成为一个节点,边从公式读取的每个公式单元格指向读取它的公式。SUM(Model!B2:B500) 这样的引用会从矩形内的每个公式单元格各引出一条边,跨一组工作表的 3D 引用则与该组中的每张表匹配。普通常量根本不是节点;它们只作为编辑的起点有意义
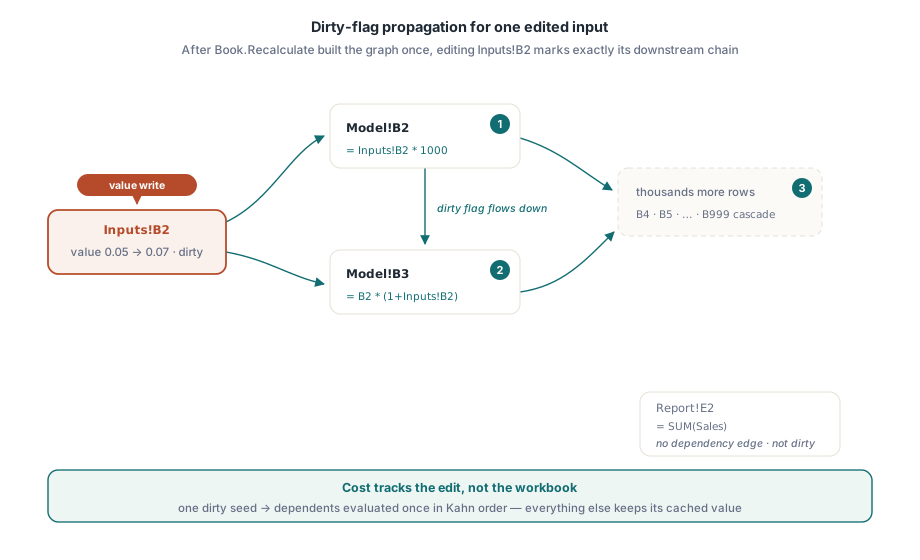
写 Value 在写入那一刻几乎什么都不做:工作簿把这个单元格的地址排进队列,仅此而已。Recalculate 启动时,引用覆盖了队列地址的每个公式被标脏,标记沿边流向它的全部依赖者,再到依赖者的依赖者。从未调用过 Recalculate 的工作簿不保留图,写入只花一次 nil 检查的代价,只读写值的代码完全不为这个特性付费
图的脏部分随后用 Kahn 算法排序。让这一趟便宜下来的细节在于入度怎么数:只有脏的先例才算数。干净的先例已经持有有效缓存值,公式永远不必等它。扫描期间,引用另一个公式单元格的公式读取那个单元格的缓存值而不是重新求值;排序保证了缓存已是新鲜的。每个脏公式恰好求值一次
下面的代码构建开头那段模型并编辑它的唯一输入。HotXLS 的工作表索引从 1 开始,所以 Inputs 是第 1 张表、Model 是第 2 张;Cells 的行和列同样从 1 开始
uses
  SysUtils, lxCalc, lxHandleX;   // lxOk 声明在 lxCalc 里

var
  Book: TXLSXWorkbook;
  Inputs, Model: TXLSXWorksheet;
  Row: Integer;
  Last: Variant;
begin
  Book := TXLSXWorkbook.Create;
  try
    Inputs := Book.Sheets.Add('Inputs');   // Sheets[1]
    Model  := Book.Sheets.Add('Model');    // Sheets[2]

    Inputs.Cells[2, 2].Value := 0.05;      // Inputs!B2 里的增长假设
    Model.Cells[2, 2].Formula := 'Inputs!B2*1000';
    for Row := 3 to 10000 do
      Model.Cells[Row, 2].Formula :=
        'B' + IntToStr(Row - 1) + '*(1+Inputs!$B$2)';

    if Book.Recalculate <> lxOk then      // 构建图,对 9,999 个公式求值
      Exit;

    Inputs.Cells[2, 2].Value := 0.07;      // 把一个地址排进队列
    if Book.Recalculate = lxOk then        // 由 Inputs!B2 供给的公式重新运行(这里是全部 9,999 个)
      Last := Model.Cells[10000, 2].Value; // 缓存结果,像普通值一样读取

    // 一次性读取:RecalcCell 先跑 Recalculate,再返回该单元格
    // 工作表 2 = Model,第 10000 行,第 2 列
    Book.RecalcCell(2, 10000, 2, Last);
  finally
    Book.Free;
  end;
end;
在这个特定模型里每个公式都读 Inputs!$B$2,所以第二轮仍然碰到全部 9,999 个;图无法缩小一个真正影响全局的编辑。节省出现在多输入的模型上:场景循环只写三四个单元格,工作簿的其余部分保住自己的缓存值
写值很便宜,写公式会重建图
只有值编辑保持增量。任何可能改变节点或边集合的操作都把整张图标为过期,下一次 Recalculate 从零重建并对每个公式求值。这包括:给 Formula 赋值;向公式单元格写 Null 或空值以清除它;增、删、移动工作表;插入或删除行列;编辑已定义名称;更改 what-if 数据表。注册或注销用户函数、给 OnUserFunction 赋值则保留图但把每个节点标脏
对报表生成器来说,实际后果是一个循环形状:先一次性铺好公式,调用 Recalculate,此后只碰值。每个客户重写一遍公式模板再重算的循环,每次迭代都会拿到一次完整重建——这正是图要避免的成本。模板真的要改时,把所有公式编辑攒在一次 Recalculate 之前,重建只发生一次;场景循环本身此后只写值
// 模型构建一次;Recalculate 已调用
for I := 0 to High(Scenarios) do
begin
  Inputs.Cells[2, 2].Value := Scenarios[I].Growth;    // 只写值
  Inputs.Cells[3, 2].Value := Scenarios[I].Discount;
  if Book.RecalcNeeded then          // 有单元格排队或为脏时为 True
    if Book.Recalculate <> lxOk then
      Break;
  Results[I] := Model.Cells[10000, 2].Value;
end;

// 只有还有未处理项时才让 SaveAs 重算
Book.RecalcBeforeSave := xrmIfDirty;
Book.SaveAs('scenarios.xlsx');
RecalcBeforeSave 默认是 xrmManual,保存时从不重算。xrmIfDirty 是生成文件该用的设置:只有图过期或有脏公式时才重算,循环里已经重算过的工作簿按原样写出,忘了某次编辑的工作簿也不会带着陈旧缓存被保存
哪些 Excel 函数每轮都强制重算?
调用 NOW、TODAY、RAND、RANDBETWEEN、RANDARRAY、OFFSET、INDIRECT、CELL、INFO 或 GETPIVOTDATA 的公式在 HotXLS 里是易失的:每轮开始时都被标脏,上游有没有变化都一样,它们的全部依赖者也是如此。时钟和随机函数易失的原因显而易见。OFFSET 和 INDIRECT 易失是因为它们读取的单元格在运行时才从参数值算出来,任何对公式的静态遍历都说不清该画哪些边
同样的规则适用于图构建器钉不到具体矩形上的引用、经由其他名称自指的已定义名称、动态数组溢出引用,以及 what-if 数据表。已定义名称总体上不是问题:构建器把名称展开成它引用的范围,所以经过工作簿级或工作表级名称的公式能拿到真实的边。已定义名称与跨工作表公式一文讲这些名称如何解析
保守方向在这里是对的:多余的一次求值只花一点时间,缺一条边意味着成品报表里有一个陈旧数字。把 OFFSET 和 INDIRECT 挡在大型模型的热路径之外,只留给真正需要动态地址的那几个单元格——链条顶附近的易失单元格,实际上会把整条链都变成易失的
经 OnUserFunction 或 RegisterUserFunction 提供的函数在另一头。它们不是易失的,只有喂给其参数的单元格变化时处理器才会被再次调用,和其他内置函数一样。从数据库读汇率的处理器因此会在各轮之间一直返回上次的答案。把汇率写进输入单元格、再把那个单元格作为参数传入:图看见了依赖,汇率一变公式立刻重跑。HotXLS 公式引擎中的自定义函数一文解释处理器参数如何到达
循环引用:lxErrorRef 或迭代计算
默认 Iterate = False 时,排序发现环,TXLSXWorkbook.Recalculate 返回 lxErrorRef。环成员是 Kahn 算法永远放不出来的脏节点,它们下游的脏公式因同样的原因被阻塞。这些公式保留先前的缓存值,脏集合里的其余部分照常按序求值。失败的一轮还会把图标为过期,所以下一次调用会重建图并对每个公式再求值一遍
case Book.Recalculate of
  lxOk:
    Book.SaveAs(OutputFile);
  lxErrorRef:
    // 循环及其下游公式仍持有旧缓存;
    // LogWarning 是你自己的例程
    LogWarning('Circular reference in model, report not written');
else
  LogWarning('Recalculation did not complete');
end;
Iterate := True 打开与 Excel 相同的迭代计算。引擎反复求值环及其被阻塞的依赖者,至多 IterateCount 轮(默认 100),直到没有值移动超过 IterateDelta(默认 0.001)。空的环成员从 0 起步。到达轮数上限会保留最后结果并仍返回 lxOk——这正是生成报表时应把迭代关掉的原因:真实报表模型里的环几乎全是错误,比如合计行被包进了自己的 SUM 范围,你要的是明确的错误码。只有围绕有意循环构建的模型才打开它,比如对包含利息本身的平均余额计息
有一种看起来循环的情况不会被报成环。VLOOKUP、HLOOKUP、LOOKUP、MATCH、XLOOKUP 和 XMATCH 的查找数组参数在该范围内的单元格变化时仍会让公式变脏,但不计入环检测,所以写在 B 列的 VLOOKUP(A1,B:B,1) 正常求值。真正的环,用 公式求值追踪器一步步看那条折回自身的引用链
数组公式与多线程扫描
传统 CSE 数组公式是其整个锚定矩形的一个节点。根公式每轮求值一次,矩阵写进每个成员单元格(标量结果广播到整个矩形),引用矩形内任何单元格——不只是左上角锚点——的公式都从根取得一条边。动态数组公式处理得更谨慎:它们每轮都运行,溢出改变大小时 Recalculate 重建图并重复本轮,直到溢出形状稳定;32 轮内不稳定则返回 lxErrorCalc
RecalcThreads 设为大于 1 时,每一拓扑层上的独立公式在工作者线程间求值,每线程一个独立计算器。数据表仍然串行,含动态数组的工作簿留在串行路径上。调高这个值之前,任何用户函数处理器都必须线程安全;处理器要碰共享状态的话,让 RecalcThreads 保持默认的 0 更稳妥
依赖图、易失处理和迭代计算都是 HotXLS Delphi Excel Component 中 XLSX 引擎的一部分,公式计算器、已定义名称及其周边读写管道也在其中。对整天开着定价表或合并工作簿、不断喂新输入的 Delphi 和 C++Builder 应用来说,每次编辑的开销从此只跟着编辑真正触及的单元格走