引用整列的定义名称出现在标量位置时,Excel 会把它当作单个单元格来读:第 7 行里的 =Vertical+1 意思是「Vertical 在第 7 行的那一个单元格」,而不是整块区域。HotXLS Delphi Component 从 v2.382.4 起在两个层面施加这种隐式交集——求值时和提取依赖时——因为一个带 4805 条公式的贷款模板表明,光把值算对还不够。当依赖遍历器把名称展开成完整区域,任何喂给该区域里某个单元格的下游公式都会闭合出一个根本不存在的环,于是 TXLSXWorkbook.Recalculate 拒绝整个工作簿
说的是一个现成的贷款摊还工作簿。把所有缓存值下毒改成 777,再跑一次完整的 Recalculate,两种引擎架构都返回 23——也就是 lxErrorRef,循环引用的错误码。4805 条公式里有 3842 条与独立预期不符,B18 是 #VALUE!,E18 还停在 777,J7 里的期数读到了尚未算完的余额列里的占位值。一个返回码背后藏着三个互不相同的缺陷,本文逐个分析,并附上修好它们的那些源码
为什么对标量位置上的列名引用会造出假环?
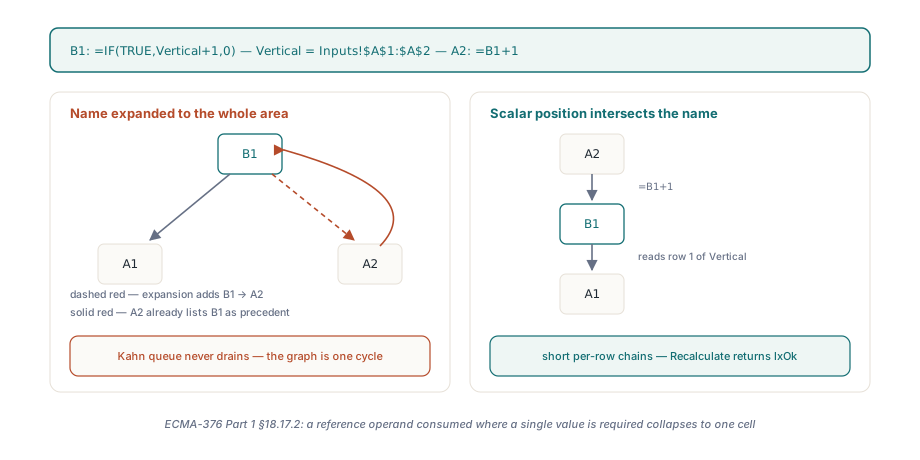
因为依赖图只认边,而从一条公式到一个 480 行的区域,一条边就变成 480 条边,其中总有一条会经由某个依赖该公式的单元格指回来。设想 B1 里是 =IF(TRUE,Vertical+1,0),Vertical 定义为 Inputs!$A$1:$A$2,A2 里是 =B1+1。Excel 把 B1 算成 A1+1、把 A2 算成 B1+1,是一条直链。而把 B1 记录成依赖 A1:A2 的遍历器,会让 A2 成为 B1 的前驱,可 A2 早已把 B1 列为前驱,于是驱动 HotXLS 增量重算的 Kahn 队列永远等不到任一节点入度归零。贷款模板恰恰就是这个模式:每一期行都引用余额、利率和期数对应的命名列,每个名称都横跨整张摊还表,而每一行又往这些列里写值。把名称展开,图就是一整块巨大的强连通分量;用隐式交集去求值,图就退化成一组短链,每行一条——这正是 ECMA-376 Part 1 §18.17.2 对「单个值位置上消费的引用操作数」的描述
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // 标量位置:公式在第 1 行,所以 Vertical 收窄成 A1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // 定义指向另一个名称的名称照样参与交集,所以这里取到 A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // 引用类参数:整块区域被求和,不做交集
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // 第 6 行落在 A1:A2 之外,交集为空,由 IFERROR 兜住
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2、A2 = 3、B2 = 3、B3 = 4、B6 = 42
      // 在 v2.382.4 之前这个分支进不来:B1 -> A2 -> B1 构成环
    end;
  finally
    Book.Free;
  end;
end;
HotXLS 怎么判断一个参数是标量?
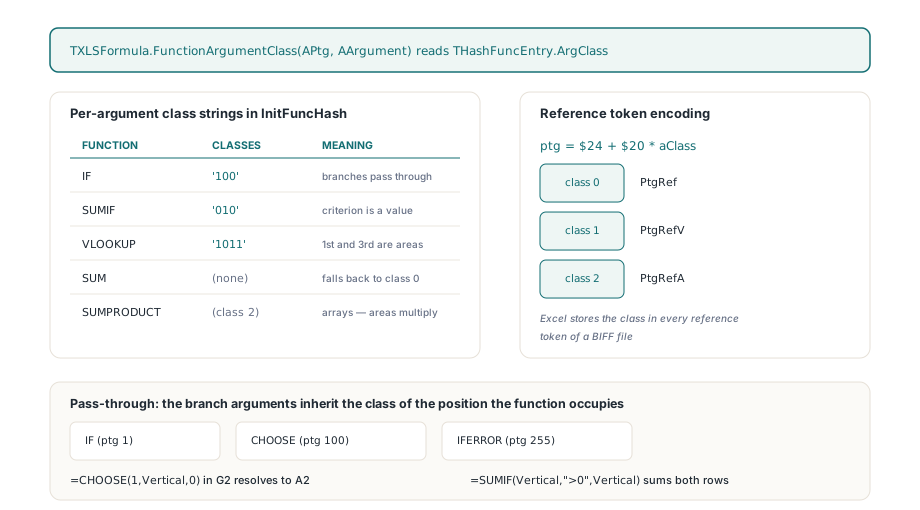
HotXLS 是从函数表里读答案,而不是看参数的形状。TXLSFormula.InitFuncHash 里每个条目都通过 THashFunc.SetValue 注册,带一个可选的逐参数类别串:'IF' 带 '100','SUMIF' 带 '010','VLOOKUP' 带 '1011',而 'SUM' 什么都不带,所以它的全部参数都退回函数级类别 0。新增的 TXLSFormula.FunctionArgumentClass(APtg, AArgument) 通过 THashFuncEntry.ArgClass 把这个字节暴露出来,返回 1 就表示 value class。这三个类别正是 [MS-XLS] §2.2.2 分配给操作数 token 的那三个,而且编码器早就靠它们活着了:写引用时它把 ptg 算成 $24 + $20 * aClass,类别 0 得到 PtgRef、类别 1 得到 PtgRefV、类别 2 得到 PtgRefA。Excel 写出的 BIFF 文件在每个引用 token 里都存着这个类别,所以只要函数表与规范对得上,引擎不用看数据就能回答「这个参数是不是标量」。SUMIF 的中间参数是判定条件,属于值;第一和第三个是区域,属于引用。SUMPRODUCT 注册的函数级类别是 2(数组),这就是 =SUMPRODUCT(Vertical,Vertical) 仍然乘整块区域的原因
有三个函数在第一个参数之后完全不查自己的表项。IF(ptg 1)、CHOOSE(ptg 100)和 IFERROR(ptg 255)对它们选中的东西一律原样透传,于是它们的分支参数继承函数自身所占位置的类别。正是这一条规则让 G2 里的 =CHOOSE(1,Vertical,0) 解析到 A2,而紧挨着的 =SUMIF(Vertical,">0",Vertical) 仍然把两行都求和;摊还表用得最多的也是这条规则,因为它的每一期单元格都靠 IF 判断贷款是否还没结清
把类别带过依赖遍历
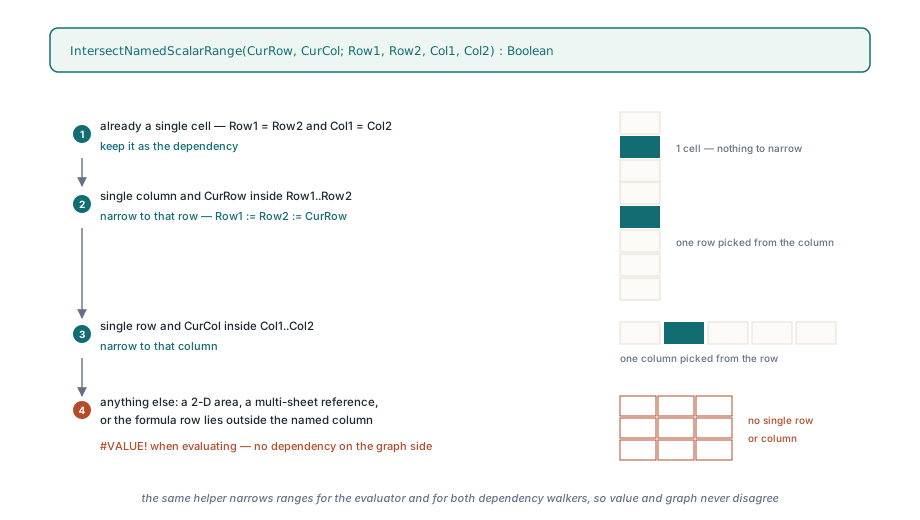
lxCalc.pas 里的依赖提取器是对编译后语法树的一趟递归 Walk,而且它有两份:一份在 TXLSCalculator.ExtractDependencies 里服务于工作簿内的图,一份在 ExtractWorkspaceDependencies 里服务于跨工作簿的图。v2.382.4 给两个遍历器各加了两个参数。AScalar 在公式根部初值为 True,对每个函数子节点由 FunctionArgumentClass 重算,而对 ptg 1、100、255 的分支参数原样传递。ANameRoot 只有在遍历器下潜到某个名称的编译定义里时才为 True,并且只能穿过 SA_GROUP 节点(也就是括号)存活下来,所以定义为 =A1:A2+1 的名称不会被误认成一块纯区域。当两个标志在某个 SA_RANGE 节点上都为 True 时,AddResolvedRange 会用求值器所用的同一个 helper 先把区域收窄,再记录依赖。这个 helper 短到可以整段引用
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // 已经是单个单元格
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // 单列:取当前行
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // 单行:取当前列
    Result := True;
  end;
end;
helper 拒绝的一切——二维区域、横跨多个工作表的引用,或者行号落在命名列之外的公式——在求值侧产出 #VALUE!,在图那一侧则完全不记录依赖,这也正是 Excel 对空交集的处理。求值侧的代码在 TXLSCalculator.GetValueItemName:它剥掉编译定义外层的 SA_GROUP 包裹,如果根部是 SA_RANGE 就调用 GetRangeInfo、做交集,然后通过 FGetValue 取出那一个单元格,而不是把整个定义求值一遍。外部引用仍走老路,因为没有本地行可以拿来求交集。名称的存储和适用范围最初是怎么来的,定义名称与跨工作表公式那篇有讲;这里只关心名称解析之后引擎做了什么
为什么在只算了一半的列上做 MATCH 读到了 777?
因为 MATCH 的查找数组参数属于 scan 引用,而 scan 引用被刻意排除在求值顺序之外。lookup scan 那篇引入了 TXLSDepRange.LookupScan,并在「把 scan 边排除在排序之外要付出什么代价」一节里收尾:查找公式可能在其范围内的每个单元格都重算完之前就跑,从而读到过期值。在交互式会话里这会在下一轮收敛;在对下毒模板做批量重算时不会。定义为 =MATCH(0.01,Balances,-1)+1 的 PaymentCount 于是读到了还躺在余额列里的 777 占位值,返回了一个不可能正确的期数
TXLSDepGraph.TopoOrder 现在把 scan 边当成软排序边。除了硬入度之外,它多维护一个 ScanInDeg 数组,按节点统计尚未处理的 scan 前驱数,并在这些前驱被输出时递减——复用的是上一次改动已经存下来的 ScanPrecedents、ScanDependents 和 ScanPrecedentCount 列表。每一轮迭代里,Kahn 队列会在就绪窗口内扫描第一个 ScanInDeg 为零的节点并把它换到队首;如果所有就绪节点都还在等 scan 前驱,就按稳定顺序弹出队首。scan 边永远不进硬入度,所以对自己的列做自引用的 VLOOKUP 依旧合法,但一个本来可以等某个跑得完的前驱的查找,现在真的会等。钉住这个行为的回归测试 LookupScan_WaitsForDirtyFormulaValues 把三个余额单元格下毒成 777,期望 PaymentCount 返回 3,然后把输入翻成零,期望 =IFERROR(PaymentCount,99) 看见 #N/A 并返回 99
四位小数的截断是从哪来的?
来自 Delphi 的 Variant 运算,而且只在嵌套位置上出现。TXLSCalculator.GetValueItem 里的二元运算符本来就会把顶层的 + 或 - 复制进两个 Double 局部变量,所以 =B1-A1 没问题。可在 =IF(TRUE,B1-A1,0) 里面,同一个减法是在两个 Variant 上按 Value := Value - SubValue 跑的;当一个操作数是 Int64 单元格值、另一个是 Double 时,我们观察到的结果类型是 Currency——一个四位小数的定点类型——于是 1066.1854641400994 减 120 回来时被截断到四位小数。在每一期都由上一行推算的摊还表里,这个误差会一路走过几百期才抵达合计行
// TXLSCalculator.GetValueItem,二元算术分支(lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Int64 与 Double 混合的 Variant 运算可能提升成 Currency。
// 电子表格运算必须保留浮点精度。
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
这段防护对 SA_ADD、SA_SUB、SA_MUL 和 SA_DIV 一视同仁地在前面运行;回归测试 Arithmetic_MixedInt64AndDoubleKeepsPrecision 往 A1 存 Int64(120)、往 B1 存 1066.1854641400994,然后要求嵌套的差与和精确到 1E-10,积与商分别精确到 1E-8 和 1E-12。HotXLS 不声称自己知道 RTL 在不同编译器版本里对混合 Variant 类型施加的每一条提升规则;它声称的是电子表格运算就是 IEEE double,而现在它在运算符看到两个操作数之前就把它们都变成 double,问题就此消失
这次修复保证了什么,又没保证什么
在 v2.382.4 之后,两种引擎架构对下毒模板都返回 lxOk,4805 个缓存值全部与独立逐行预期在 1E-7 内吻合,而且「缓存确实被下过毒」「源文件哈希未变」「每条公式都还在」这几条断言也都成立。做到这些既没打开迭代,也没压掉任何错误码。经过名称的真环——A1 里是 =B1 而 B1 仍在读 Vertical——依然返回错误,测试 NamedScalarRanges_IntersectWithoutFalseCycles 正是以此断言收尾
边界值得明说。隐式交集只适用于这样的名称:编译定义在剥掉括号之后,是单张工作表上的单列或单行区域。标量位置上的二维名称就是 #VALUE!,和 Excel 一样;而函数表不认识的函数从 FunctionArgumentClass 拿到类别 0,所以它的名称参数仍会被整块展开。软排序是一种偏好而不是保证:纯 scan 环依然按稳定顺序求值、缓存里有什么就读什么,这正是 lookup scan 那篇有意接受的行为。另外,整份模板的结果是拿独立预期脚本验证的,而不是拿另一个电子表格引擎对比——那套参考办公软件没能在 60 秒预算内把原始模板重算完。HotXLS 是原生 Delphi 和 C++Builder 电子表格组件,不装 Excel 就能读写并重算 XLS、XLSX、ODS 和 CSV;名称交集、参数类别表和软 scan 排序对每种格式都生效,因为计算引擎是共用的;当前支持的函数清单列在 HotXLS Delphi 电子表格组件产品页上