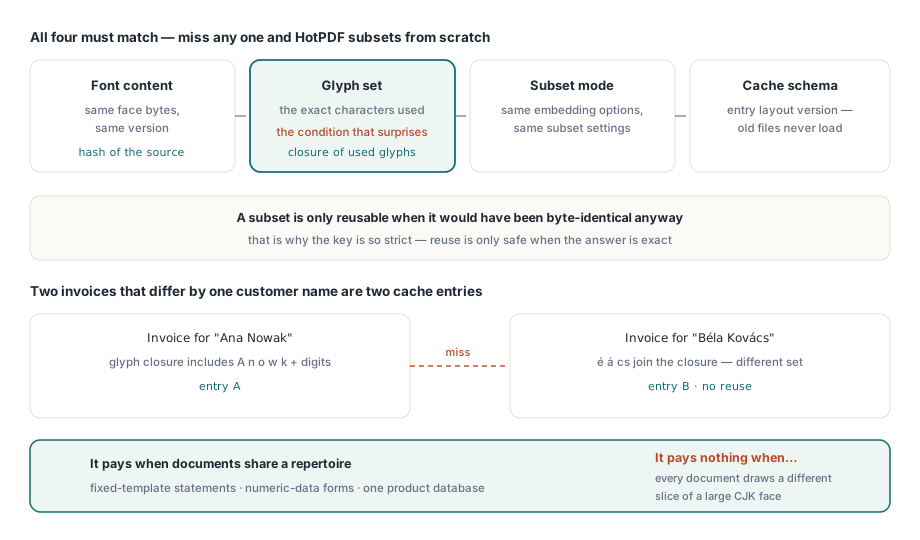
两份用同一模板、同一 TrueType 字体渲染的发票,仅仅客户姓氏不同,就会在字体子集缓存里留下两个不同的文件。这个姓氏带来了大写 Q 和小写 z,第一份发票从没用过它们,于是保留的字形集合变了,子集和缓存键也跟着变。当文档的字形集合不断重复时,持久化子集缓存才真正划算,而它暴露的那些计数器能在一批文档之内告诉你你的场景算不算
在 HotPDF 中打开磁盘缓存
在给它一个目录之前,HotPDF 的子集缓存始终是关闭的。THotPDF 上有两个属性控制它:FontSubsetCacheFolder 指定目录,FontSubsetCacheMaxBytes 限制容量,默认 268435456 字节(256 MiB)。只有目录非空且预算大于零时缓存才生效。赋值目录时,若目录不存在会自动创建,并立即把里面已有的内容修剪到预算以内
子集化值得缓存,因为它是实打实的工作。构建 TrueType 子集意味着遍历复合字形闭包、重写 loca 和 glyf、重建索引字形的各张表,还要产出一个 PDF 可寻址的 CID 映射。对单个文档,这点成本淹没在噪声里;而在一台用同样三款字体循环渲染数千份对账单的报表服务器上,同样的子集被一遍遍重建——这正是缓存替你省下的 CPU
var
  Pdf: THotPDF;
  Info: THPDFFontSubsetCacheInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.EnableFontSubsetting := True;
    // 路径只用 ASCII:这个属性是 AnsiString
    Pdf.FontSubsetCacheFolder := 'C:\ProgramData\Reports\fontcache';
    Pdf.FontSubsetCacheMaxBytes := 64 * 1024 * 1024;   // 64 MiB,不用 256 MiB 的默认值
    // ...批处理中的每份文档各走一遍 BeginDoc / 绘制 / EndDoc...
    Info := Pdf.GetFontSubsetCacheInfo;
    // LogFmt 是你自己的日志例程
    LogFmt('subset cache: %d hits, %d misses, %d bytes in %d files',
      [Info.HitCount, Info.MissCount, Info.CurrentBytes, Info.FileCount]);
  finally
    Pdf.Free;
  end;
end;
两条子集化路径背后都是这个缓存:通过 EnableFontSubsetting 走子集化的字体(覆盖 TrueType 和 OpenType-CFF),以及用 RegisterUnicodeTTF 注册的字体。绘图代码里的其他东西一概不用改。文件夹路径声明为 AnsiString,所以目录名里带系统代码页之外的字符就是在自找麻烦;ProgramData 或服务数据目录下一个纯 ASCII 路径可以完全绕开这个问题
缓存键由什么构成
四个输入决定一份存储的子集能否复用:源字体的精确字节、文档保留的字形集合、子集模式,以及缓存格式版本。每个键由字体字节的 SHA-256 散列和已用字形 ID 位图的 SHA-256 散列构成,前缀 v1-,稀疏子集后缀 -s,紧凑子集后缀 -c。条目以 <key>.hpdfsubset 的形式落在磁盘上,看一眼目录列表就知道这批文档在产出哪种模式
对字体内容而非文件名做散列有一个实际后果。升级 Arial 或换入企业字体的新构建会自动产生新键,旧条目只是不再被命中,直到被淘汰清除。字体更新之后你不必清缓存也能拿到正确的输出;清缓存只是提前把空间要回来
子集模式是最容易被忘掉的输入。CompactFontSubsetting 把保留的字形重新编号成致密区间,并写出显式的 /CIDToGIDMap(ISO 32000-1 §9.7.4.2);设置了 PDFACompliance 时,注册字体总是得到紧凑子集。CompressDocument 也会在文档存续期间打开紧凑子集。于是同一个服务把同一份对账单先写成普通 PDF 再写成 PDF/A,会为相同的字形填满两组条目,一组以 -s 结尾,一组以 -c 结尾。OpenType-CFF 字体总是走稀疏路径
命中率由字形集合决定。固定模板出的对账单、可变数据几乎全是数字的表单、从同一个产品数据库画出来的目录册:这些场景一份份文档复用同一批字形。而每份文档都从一个上万字形的 CJK 字体里拉出不同切片的负载基本全 miss,因为几乎每份文档的位图都是新的。先跑一批有代表性的文档、读一遍计数器,再判断自己的负载属于哪一类
怎么知道缓存到底有没有在干活?
GetFontSubsetCacheInfo 返回一个有九个字段的 THPDFFontSubsetCacheInfo 记录,拿 HitCount 对 MissCount 就能直接回答上面的问题。WriteCount 和 EvictionCount 显示条目是活得够久被复用了,还是被过紧的预算挤了出去。CurrentBytes 和 FileCount 描述文件夹此刻的状态
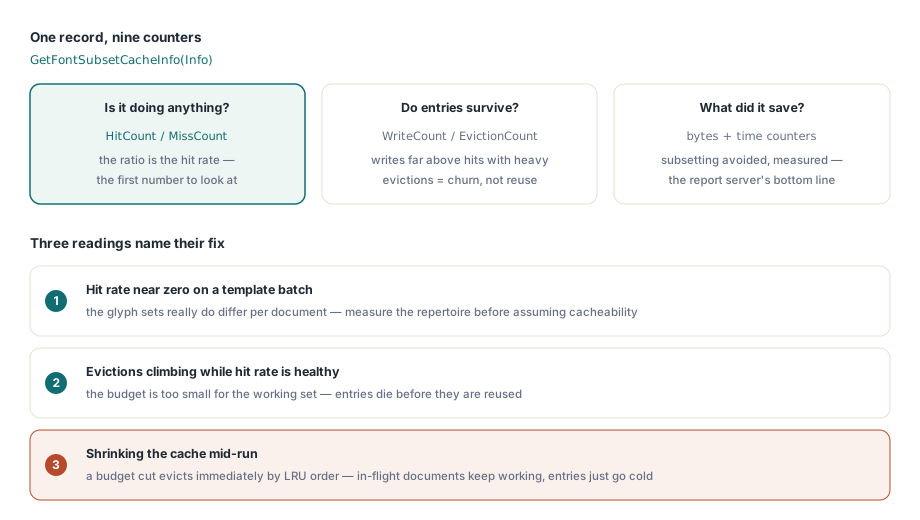
把这些计数器接进监控时有两处细节要留意。七个事件计数器属于 THotPDF 实例本身,组件创建时从零开始,所以一份文档建一个组件的服务每次读到的都只是一份文档的活动量。CurrentBytes 和 FileCount 则相反,它们来自调用那一刻对文件夹的枚举,既反映使用该文件夹的所有进程,也让每次调用都付一次目录扫描的成本。每批只读一次,放在批末尾,别让逐文档的循环里出现它
剩下三个计数器值得配告警。CorruptCount 统计加载时校验失败并被删除的条目,每一个同时也算一次 miss;断电后出现零星几个属正常,持续小量增长则指向存储本身。RejectedCount 统计缓存拒绝存储的子集,典型原因是单个子集比整个预算还大。WriteFailureCount 统计未完成的写入,实践中几乎总是服务账号对文件夹没有写权限。三者都不会打断文档生成,所以有写权限问题的缓存产出的 PDF 与没有缓存时完全一样——只是永远不会变快
// SubsetCacheNeedsAttention 是你自己加的辅助函数;
// 阈值只是示例,按你的批量调整
function SubsetCacheNeedsAttention(const Info: THPDFFontSubsetCacheInfo;
  out Reason: string): Boolean;
begin
  Reason := '';
  if Info.WriteFailureCount > 0 then
    Reason := 'cache folder is not writable for this account'
  else if Info.RejectedCount > Info.WriteCount then
    Reason := 'subsets exceed FontSubsetCacheMaxBytes, raise the budget'
  else if (Info.EvictionCount > Info.WriteCount div 2) and (Info.HitCount < Info.MissCount) then
    Reason := 'entries are evicted before they are reused'
  else if Info.CorruptCount > 10 then
    Reason := 'repeated damaged entries, check the storage';
  Result := Reason <> '';
end;
预算、淘汰,以及那个会清空文件夹的开关
淘汰策略按文件修改时间的最近最少使用执行。每次成功加载都会触碰条目的时间戳,每次写入后都会跟随一次修剪,最老的文件先走,直到文件夹重新塞进预算。运行时调低 FontSubsetCacheMaxBytes 会立即修剪而不是等下一次写入,所以对磁盘空间告警做出反应的服务可以在决定收缩的那一刻就动手
这种即时性也有一道锋利的边。文件夹已配置时把预算设为零会修剪到零,删光里面所有 .hpdfsubset 文件;而把 FontSubsetCacheFolder 设为空字符串是关掉缓存,文件原地不动。两个开关都会让下一份文档停用缓存,但只有一个会保住一整周的热条目。排查问题时,清空文件夹属性,预算别动
// 诊断运行期间暂停缓存,保留所有已存储的条目
Pdf.FontSubsetCacheFolder := '';

// 危险:文件夹已设置时,零预算会把文件夹修剪到空
// Pdf.FontSubsetCacheMaxBytes := 0;

// 刻意重置:删除 *.hpdfsubset 和遗留的临时文件,
// 事件计数器保持原值
Pdf.FontSubsetCacheFolder := 'C:\ProgramData\Reports\fontcache';
Pdf.ClearFontSubsetCache;停用缓存跑一次诊断,是排除缓存嫌疑最干净的办法。/BaseFont 里那六个字母的子集标签由保留的字形集合派生,同样的字形无论有没有缓存都得到同样的标签,嵌入的字体程序也应当一致。整文件散列仍会不同,因为创建日期和文档 ID 在变——所以要比的是字体流,不是文件
损坏或写了一半的条目会怎样?
损坏的条目会被删除,子集按正常流程重建,条目里的任何内容都不会进入 PDF 流。加载时 HotPDF 检查文件签名、格式版本、子集模式标志、相对源字体的字形数、声明长度与实际文件大小,以及所存字体程序的 sfnt 头。任何不匹配都会丢弃条目、递增 CorruptCount,然后落到内存子集化。把一个损坏的字体程序塞进客户的 PDF,几周后才会出现在别人机器上的某个查看器里,离病因十万八千里——这套校验要防的就是这种失败
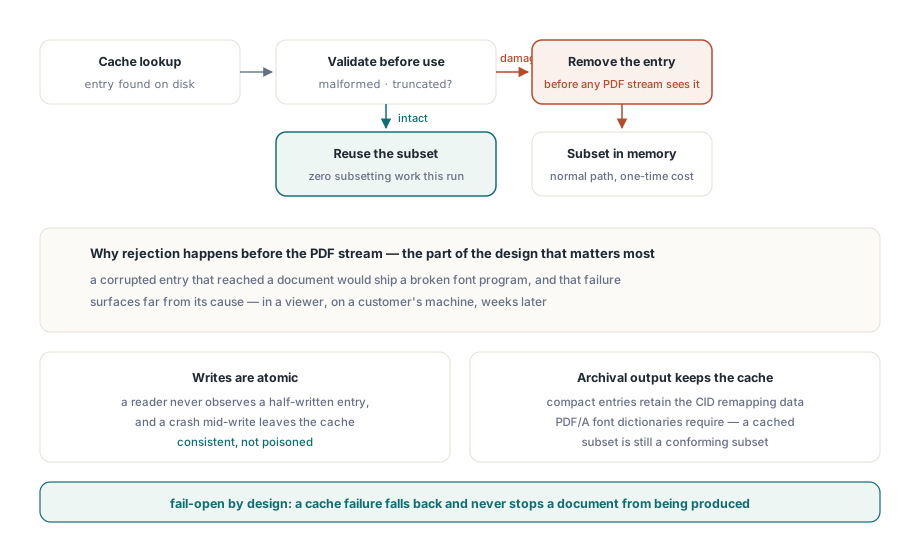
写了一半的条目压根不会出现。写入先落到一个临时文件,文件名带上进程 ID 和组件实例,然后用一次替换并刷盘的 rename 盖到最终名字上。写到一半崩溃只会留下一个游离的 .tmp- 文件,ClearFontSubsetCache 会把它扫掉,而真正的条目要么是完整的旧版本,要么是完整的新版本。紧凑条目还会把新旧字形映射连同字体程序一起存储,所以缓存的紧凑子集能重建出同样的 /CIDToGIDMap,PDF/A 输出可以直接用缓存而不必绕开它
文件夹该放在哪里?
三个条件说了算:服务账号得能写、文件夹应在本地存储上、任何部署步骤都不该清掉它。网络共享会把每次查找变成一次往返,还把 rename 语义交到文件服务器手里。应用目录内会被安装程序重建的文件夹意味着每次更新后缓存都从零开始,这会在你盯性能盯得最紧的那天悄悄抹掉全部收益
多个组件、多个进程可以共享同一个本地文件夹。临时名不会冲突,最终 rename 是原子的,输掉竞争的代价不过是 miss 一次、或一次写入留到下一份文档重试。在同一台机器上,共享是更好的默认,因为每个实例都在为其他实例预热缓存。唯一可见的副作用是各实例的计数器只描述自己的流量,而 CurrentBytes 和 FileCount 描述所有人的;偶发的 WriteFailureCount 跳动可能来自两个进程同时替换同一条目。只读文件夹仍然能提供已有条目,只是无法刷新它们的时间戳,也加不进新的
什么时候缓存不是那根正确的杠杆
缓存消除的是重复劳动。它对一批文档的第一份无能为力,对字形集合从不重复的负载也帮助有限。如果输出被一款覆盖不可预测文本的大型 CJK 字体主导,去看看每个子集都拉进了哪些字形、为什么,字体子集闭包与塑形后的字形的笔记里有讲。如果目标是文件大小而非 CPU,CompressDocument 与紧凑字体子集一文解释了紧凑模式对嵌入字体改了什么。当一批文档慢下来而原因与字体无关,报表输出中的字体与图像演练展示了时间通常流向哪里,EndDoc 字体子集排序则说明了子集在文档收尾阶段何时构建
由于子集缓存就在组件内部,Delphi 或 C++Builder 报表服务器只要设一个文件夹路径和一个预算就能用上它,不需要额外部署或监控任何服务。字体嵌入、子集化以及其余 PDF 生成特性列在HotPDF Delphi 组件页